La fragmentación de texto (text chunking) es uno de los pasos más críticos al construir un pipeline de RAG (Retrieval Augmented Generation). La forma en que divides tus documentos impacta directamente la calidad de todo tu sistema. Una estrategia de fragmentación deficiente puede provocar que se inserte contexto irrelevante en tus prompts, haciendo que tu IA dé respuestas completamente incorrectas.
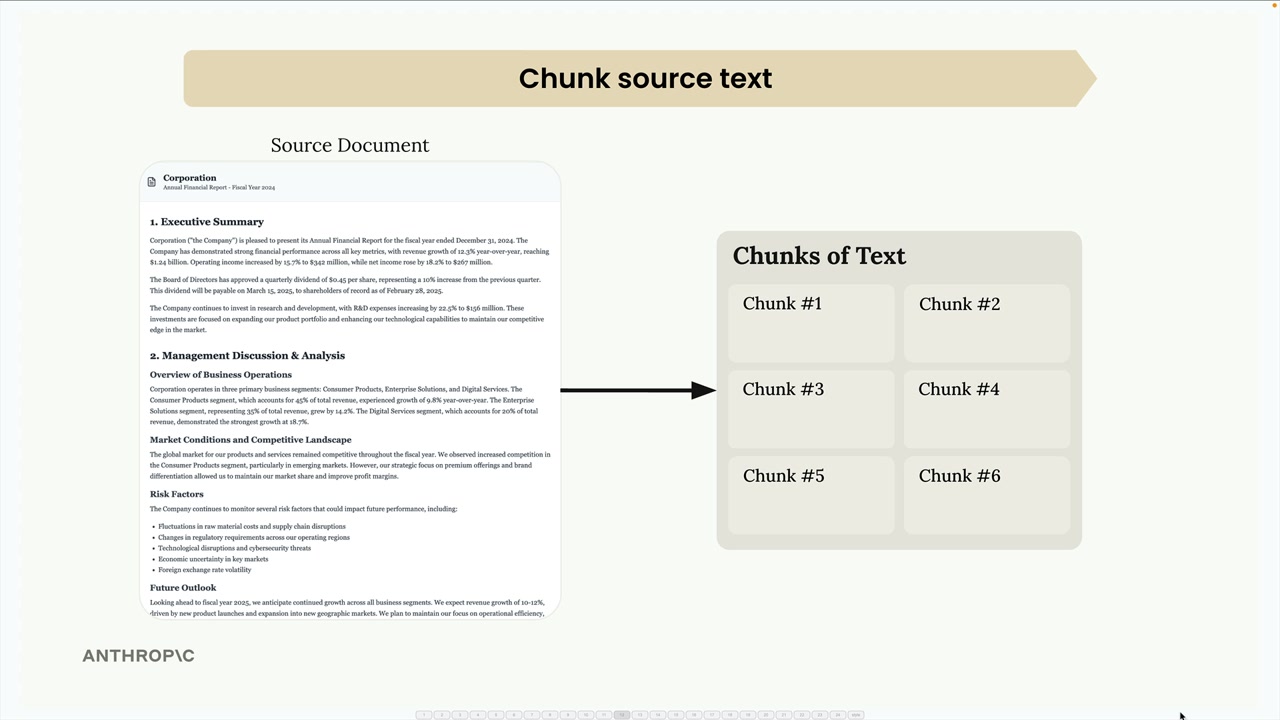
Considera este ejemplo: tienes un documento con secciones sobre investigación médica e ingeniería de software. Si fragmentas mal, un usuario que pregunte "¿Cuántos errores (bugs) corrigieron los ingenieros este año?" podría obtener información sobre investigación médica en lugar de ingeniería de software, simplemente porque la sección médica contenía la palabra "bug" en un contexto diferente.
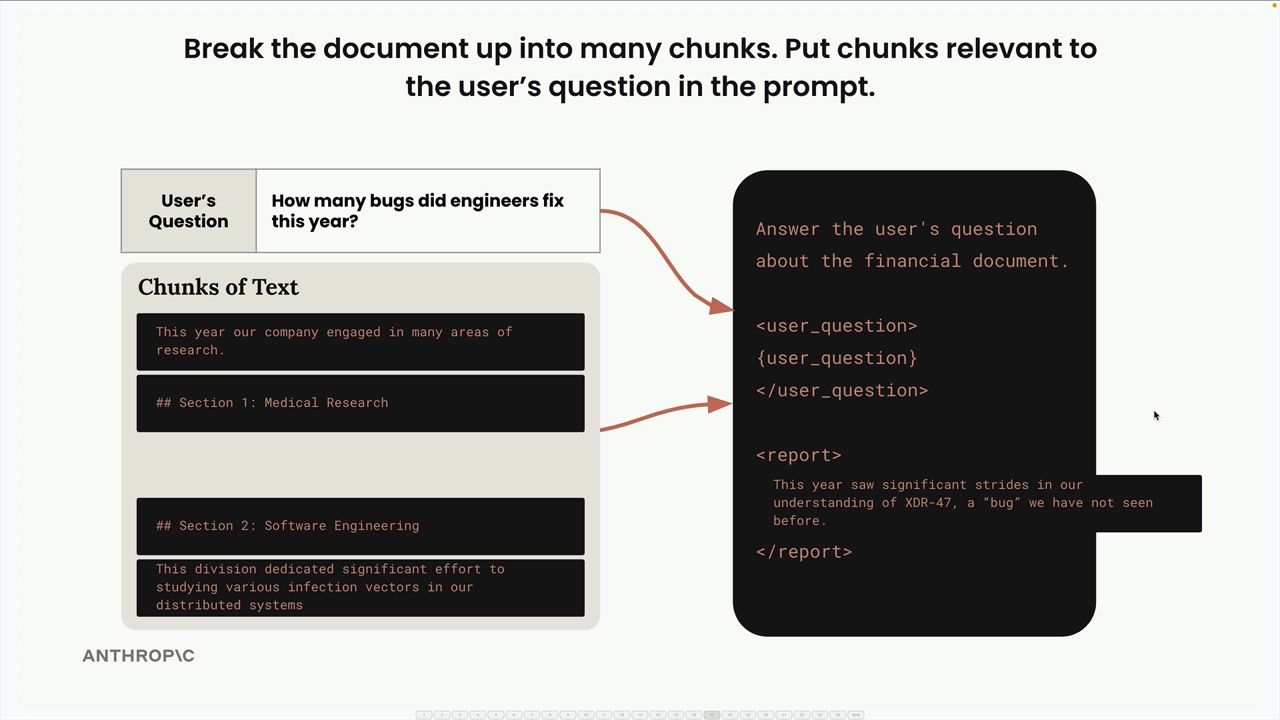
Por eso elegir la estrategia de fragmentación correcta importa tanto. Exploremos tres enfoques principales.
Fragmentación basada en tamaño
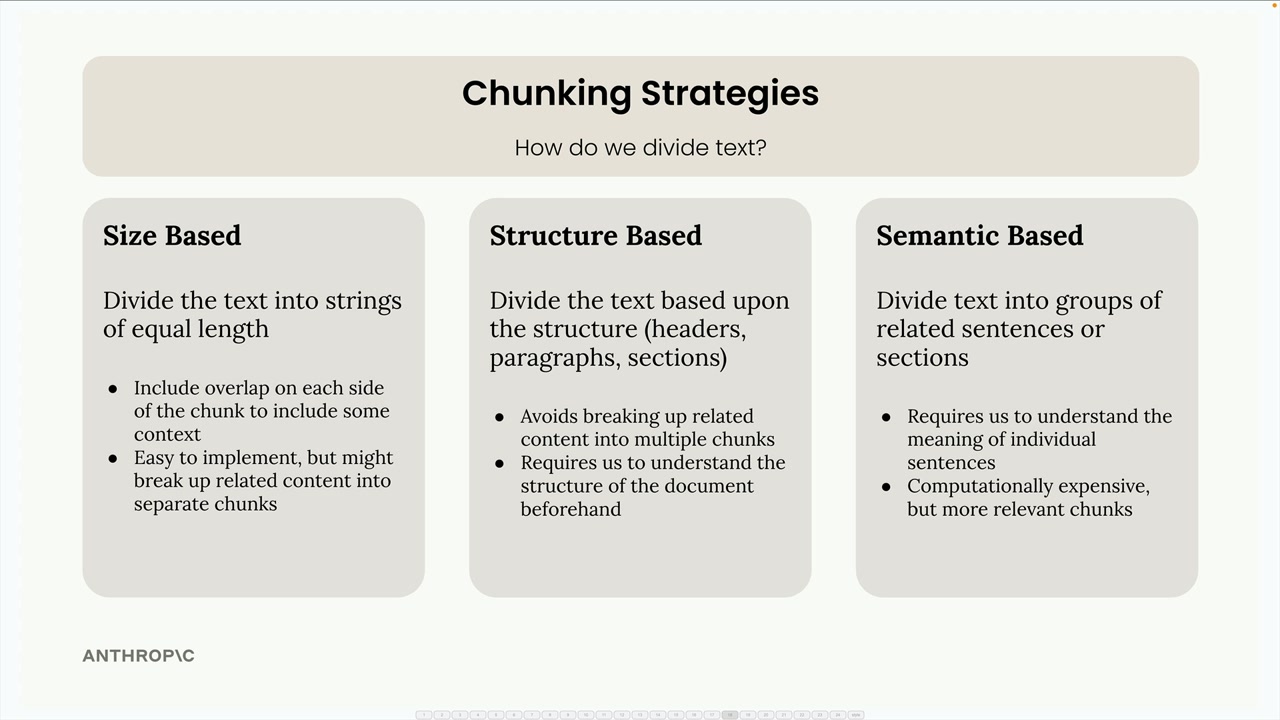
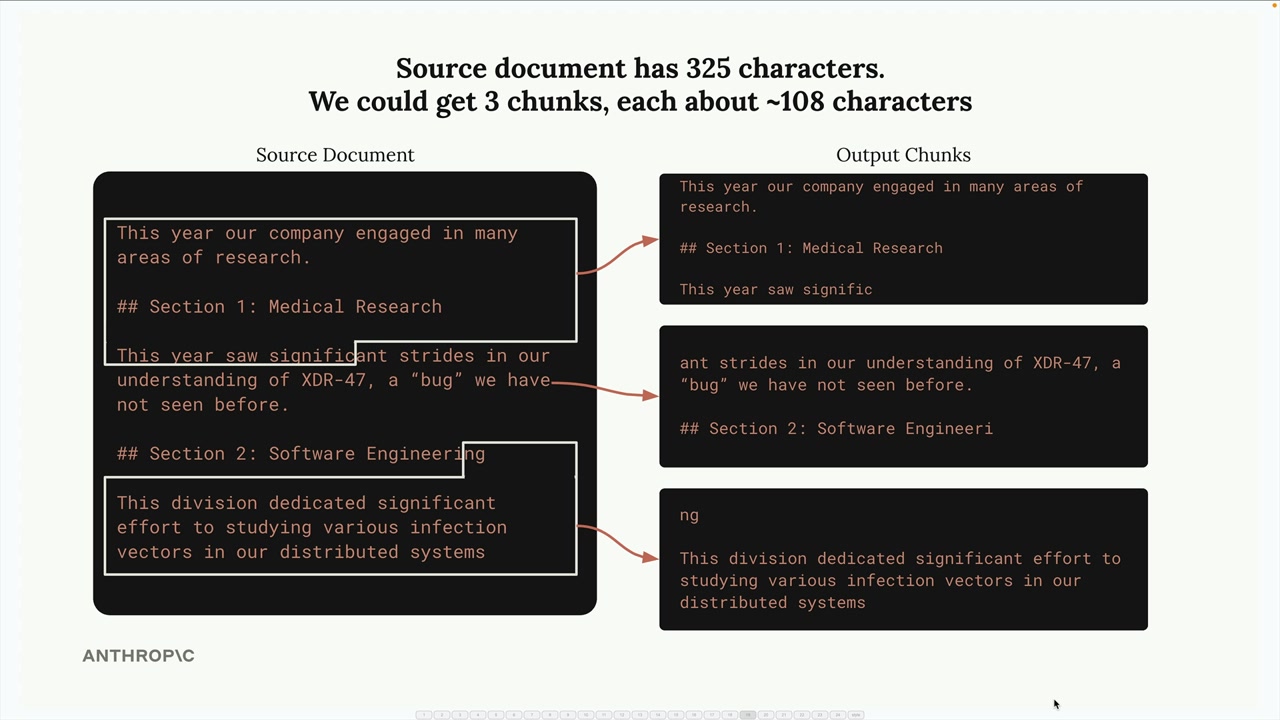
La fragmentación basada en tamaño es el enfoque más simple: divides tu texto en cadenas de igual longitud. Si tienes un documento de 325 caracteres, podrías dividirlo en tres fragmentos de aproximadamente 108 caracteres cada uno.
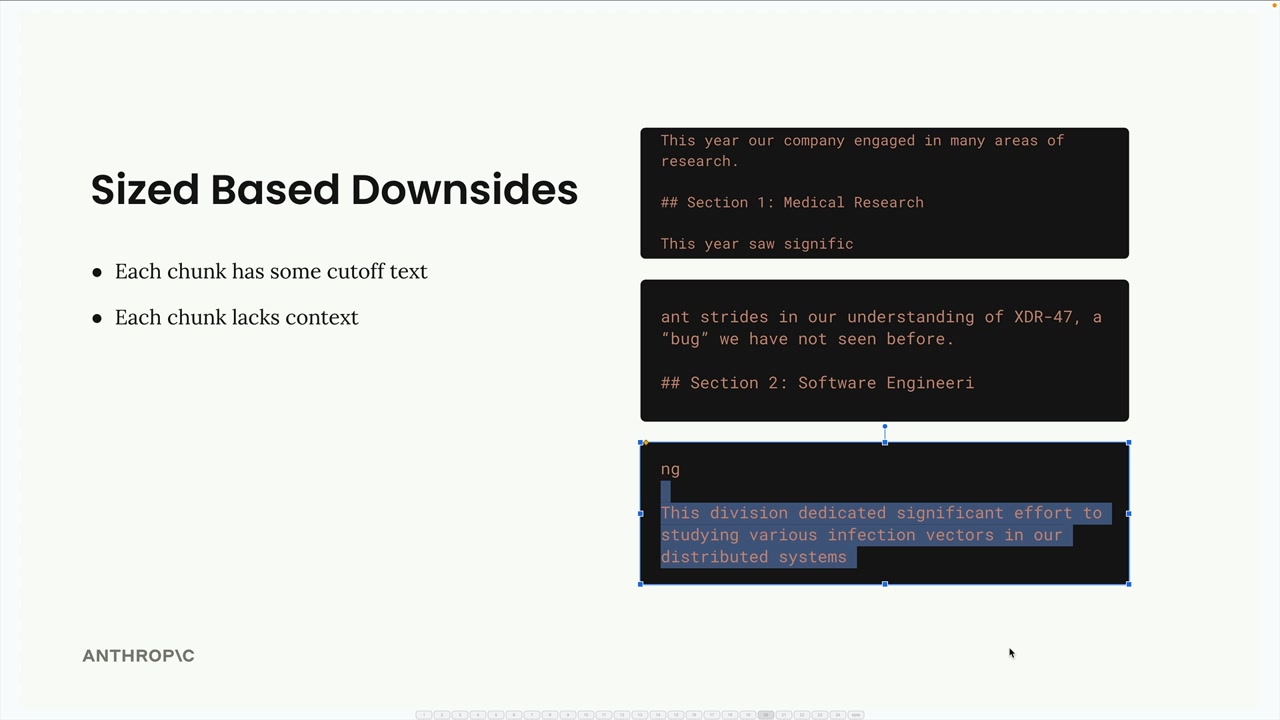
Este método es fácil de implementar y funciona con cualquier tipo de documento, pero tiene desventajas claras:
- Las palabras se cortan a mitad de oración
- Los fragmentos pierden contexto importante del texto circundante
- Los encabezados de sección pueden separarse de su contenido
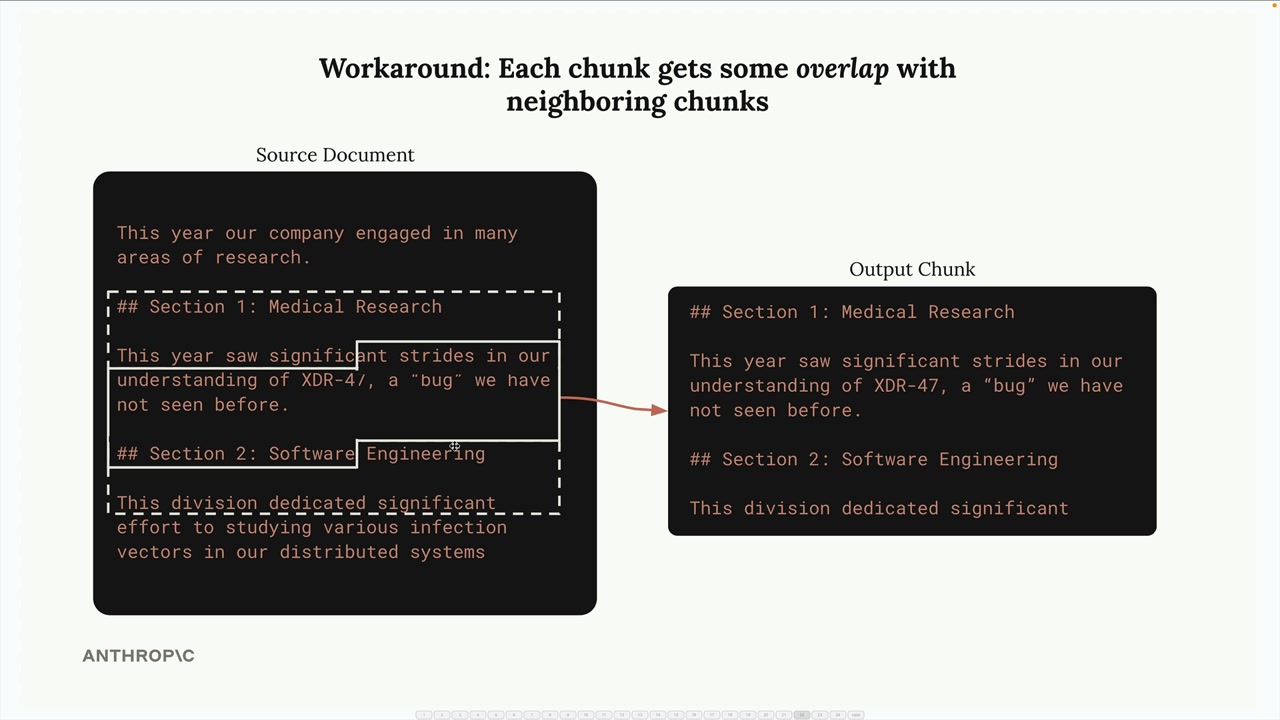
Para abordar estos problemas, puedes agregar superposición (overlap) entre fragmentos. Esto significa que cada fragmento incluye algunos caracteres de los fragmentos vecinos, proporcionando mejor contexto y asegurando palabras y oraciones completas.
Aquí tienes una implementación básica:
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
Fragmentación basada en estructura
La fragmentación basada en estructura divide el texto según la estructura natural del documento: encabezados, párrafos y secciones. Esto funciona muy bien cuando tienes documentos bien formateados como archivos Markdown.
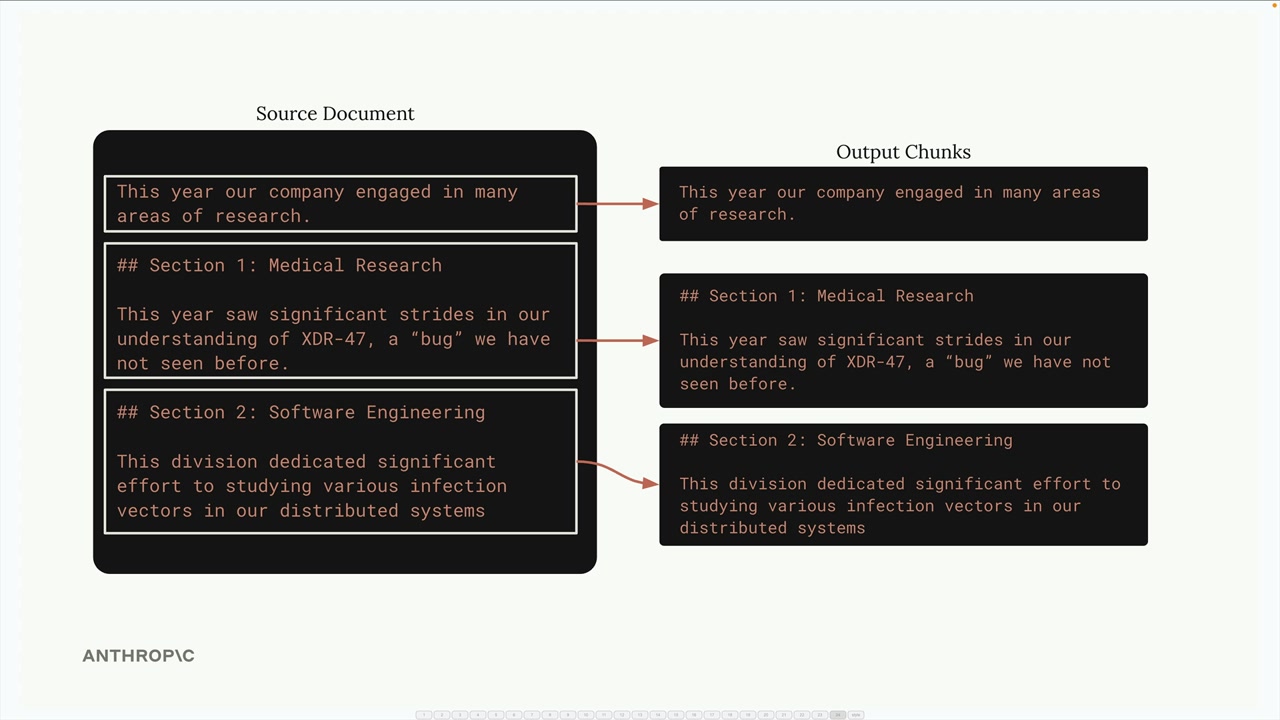
Para un documento Markdown, puedes dividir por marcadores de encabezado:
def chunk_by_section(document_text):
    pattern = r"\n## "
    return re.split(pattern, document_text)
Este enfoque te da los fragmentos más limpios y significativos porque cada uno representa una sección completa. Sin embargo, solo funciona cuando tienes garantías sobre la estructura de tu documento. Muchos documentos del mundo real son texto plano o PDFs sin marcadores estructurales claros.
Fragmentación basada en semántica
La fragmentación basada en semántica es el enfoque más sofisticado. Divides el texto en oraciones y luego usas procesamiento de lenguaje natural para determinar qué tan relacionadas están las oraciones consecutivas. Construyes fragmentos a partir de grupos de oraciones relacionadas.
Este método es computacionalmente costoso pero produce los fragmentos más relevantes. Requiere comprender el significado de oraciones individuales y es más complejo de implementar que las otras estrategias.
Fragmentación basada en oraciones
Un punto medio práctico es fragmentar por oraciones. Divides el texto en oraciones individuales usando expresiones regulares, y luego las agrupas en fragmentos con superposición opcional:
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r"(?<=[.!?])\s+", text)

    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(" ".join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
Elegir tu estrategia
Tu elección depende completamente de tu caso de uso y de las garantías del documento:
- Basada en estructura: Mejores resultados cuando controlas el formato del documento (como informes internos de la empresa)
- Basada en oraciones: Buen punto medio para la mayoría de los documentos de texto
- Basada en tamaño: Alternativa más confiable que funciona con cualquier tipo de contenido, incluido código
La fragmentación basada en tamaño con superposición suele ser la opción preferida en producción porque es simple, confiable y funciona con cualquier tipo de documento. Aunque puede no dar resultados perfectos, produce de manera consistente fragmentos razonables que no romperán tu pipeline.
Recuerda: no existe una única "mejor" estrategia de fragmentación. El enfoque correcto depende de tus documentos específicos, tus casos de uso y las concesiones que estés dispuesto a hacer entre la complejidad de implementación y la calidad de los fragmentos.