Construir un flujo de trabajo de evaluación de prompts personalizado comienza con crear un prompt sólido y luego generar datos de prueba para ver qué tan bien funciona. Repasemos cómo configurar un sistema de evaluación para un prompt que ayuda a los usuarios a escribir código específico de AWS.
Estableciendo el objetivo
Nuestro prompt necesita ayudar a los usuarios a escribir tres tipos específicos de salida para casos de uso de AWS:
- Código Python
- Archivos de configuración JSON
- Expresiones regulares
El requisito clave es que cuando un usuario solicite ayuda con una tarea, devolvamos una salida limpia en uno de estos formatos sin explicaciones, encabezados o pies de página adicionales.
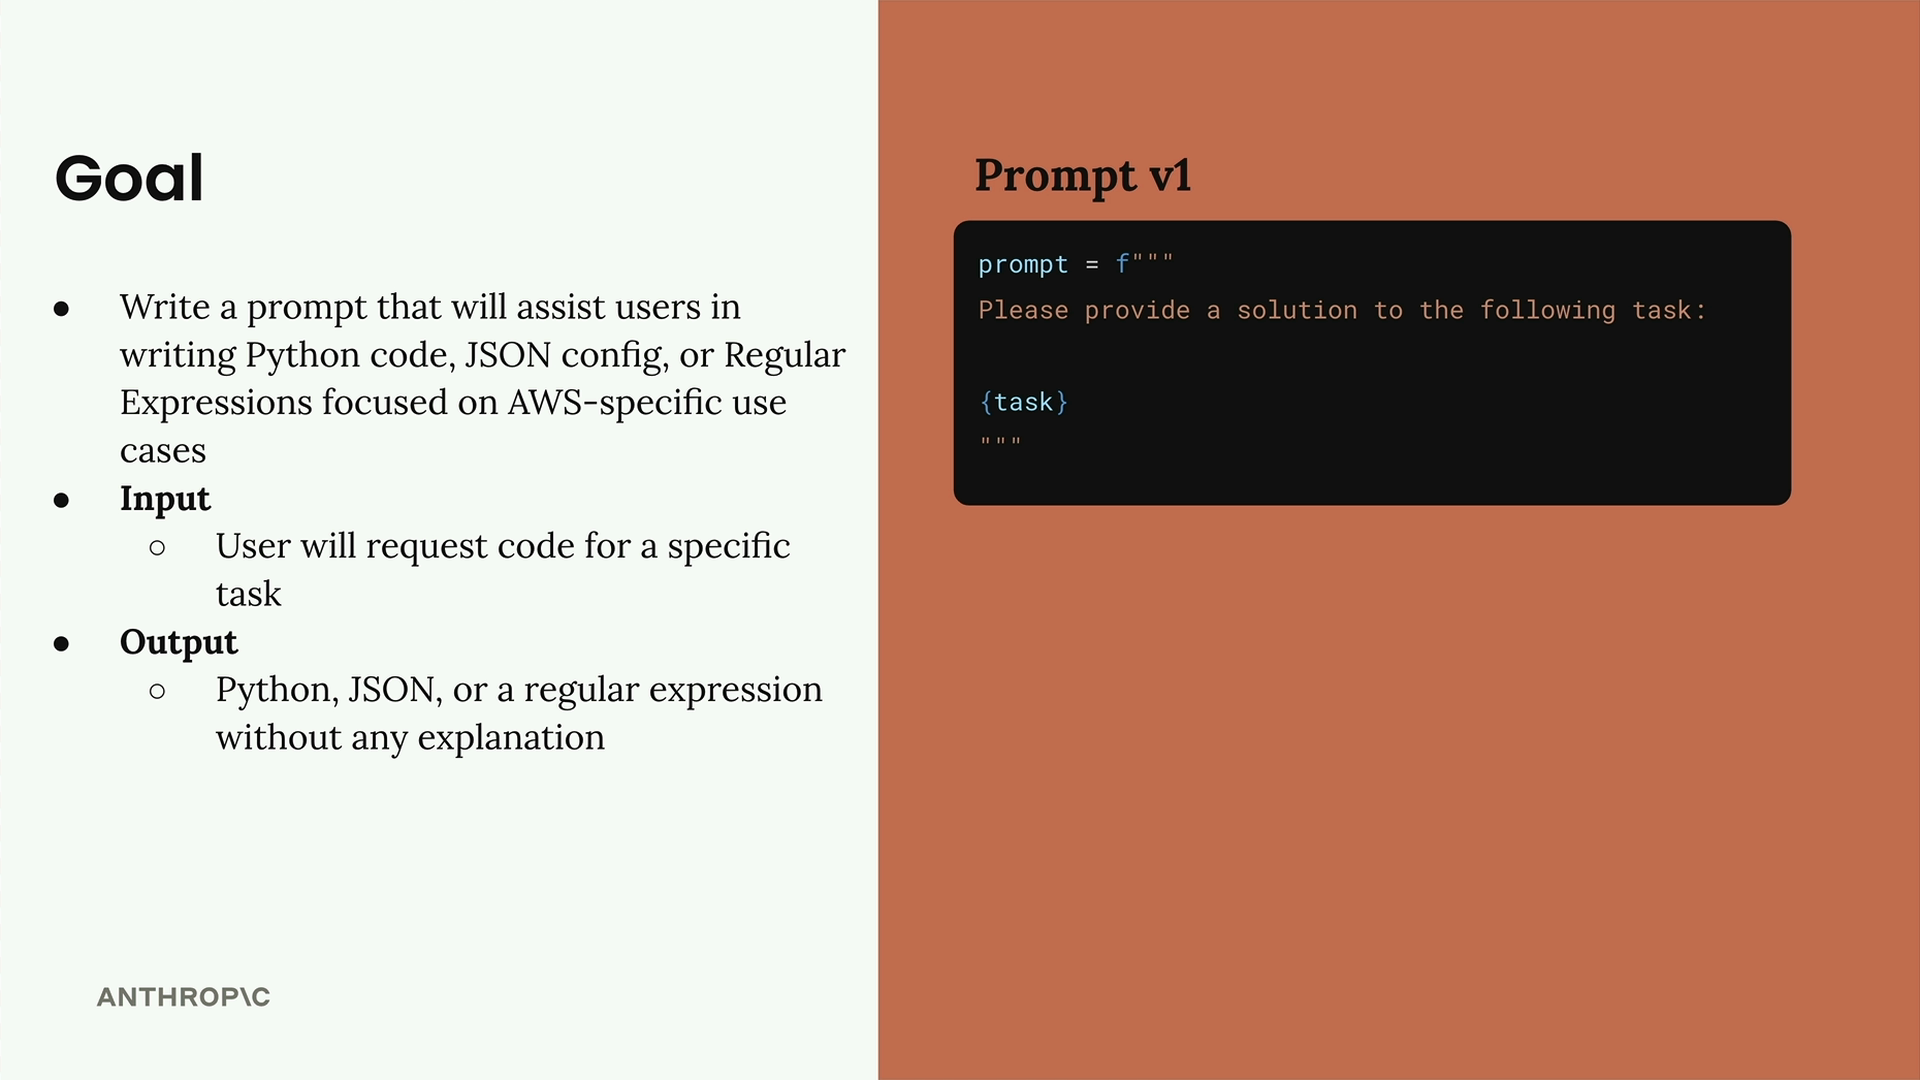
Aquí está nuestro prompt inicial (versión 1):
prompt = f"""
Please provide a solution to the following task:
{task}
"""
Creando un conjunto de datos de evaluación
Un conjunto de datos de evaluación contiene entradas que alimentaremos a nuestro prompt. Para cada combinación de prompt y entrada, ejecutaremos el prompt y analizaremos los resultados.
Nuestro conjunto de datos será un array de objetos JSON, donde cada objeto contiene una propiedad "task" que describe lo que queremos que Claude logre. Podemos crear este conjunto de datos a mano o generarlo automáticamente usando Claude.
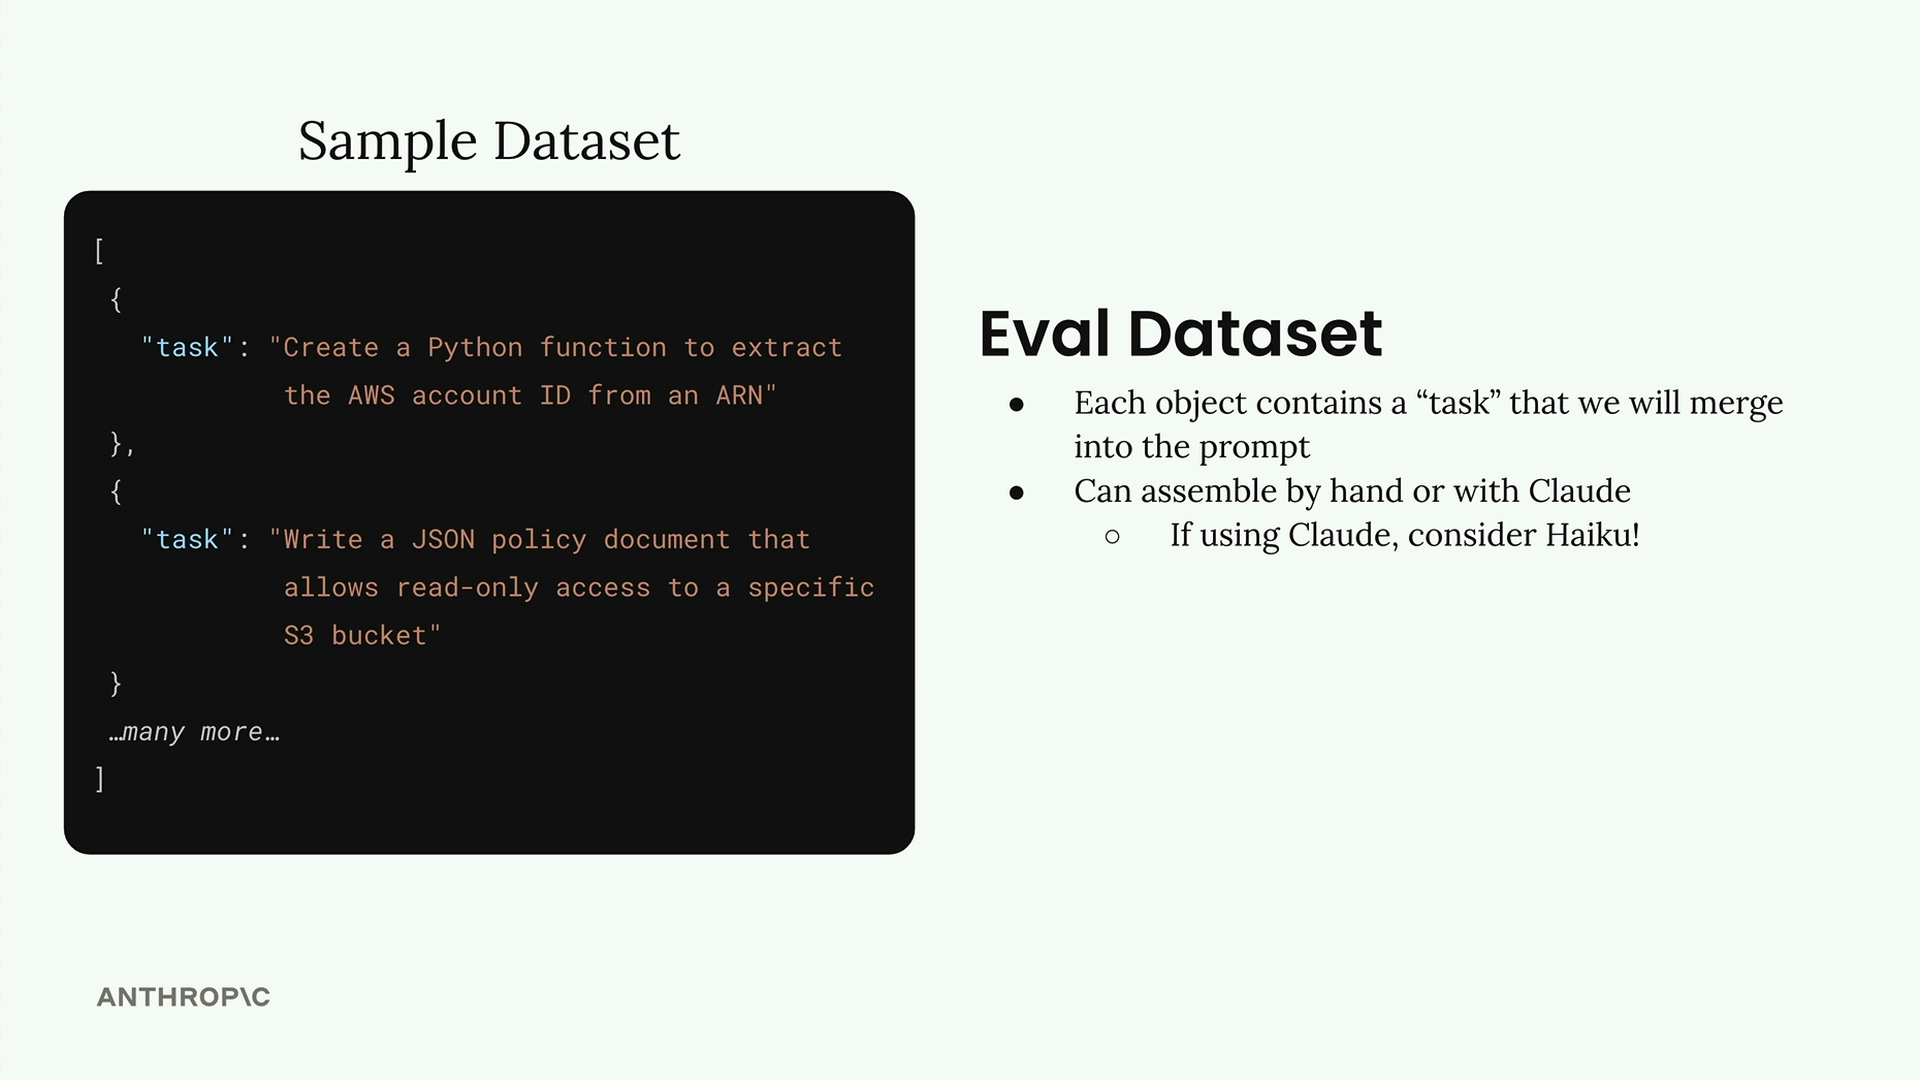
Dado que estamos generando datos de prueba, esta es una oportunidad perfecta para usar un modelo más rápido como Haiku en lugar del modelo completo de Claude.
Generando datos de prueba con código
Creemos una función que genere automáticamente nuestro conjunto de datos de prueba. Primero, necesitaremos nuestras funciones auxiliares para trabajar con Claude:
def add_user_message(messages, text):
    user_message = {"role": "user", "content": text}
    messages.append(user_message)

def add_assistant_message(messages, text):
    assistant_message = {"role": "assistant", "content": text}
    messages.append(assistant_message)

def chat(messages, system=None, temperature=1.0, stop_sequences=[]):
    params = {
        "model": model,
        "max_tokens": 1000,
        "messages": messages,
        "temperature": temperature
    }
    if system:
        params["system"] = system
    if stop_sequences:
        params["stop_sequences"] = stop_sequences

    response = client.messages.create(**params)
    return response.content[0].text
Ahora crearemos nuestra función de generación de conjuntos de datos:
def generate_dataset():
    prompt = """
Generate an evaluation dataset for a prompt evaluation. The dataset will be used to evaluate prompts that generate Python, JSON, or Regex specifically for AWS-related tasks. Generate an array of JSON objects, each representing task that requires Python, JSON, or a Regex to complete.

Example output:
```json
[
  \{
    "task": "Description of task",
  \},
  ...additional
]
```

* Focus on tasks that can be solved by writing a single Python function, a single JSON object, or a single regex
* Focus on tasks that do not require writing much code

Please generate 3 objects.
"""
Para analizar correctamente la respuesta JSON, usaremos el prefilling y las secuencias de parada:
    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
Probando la generación del conjunto de datos
Ejecutemos nuestra función y veamos qué tipo de casos de prueba obtenemos:
dataset = generate_dataset()
print(dataset)
Esto debería devolver tres casos de prueba diferentes que cubren nuestras salidas objetivo: funciones Python, configuraciones JSON y expresiones regulares para tareas específicas de AWS.
Guardando el conjunto de datos
Una vez que tengamos nuestro conjunto de datos, lo guardaremos en un archivo para poder cargarlo fácilmente más tarde durante la evaluación:
with open('dataset.json', 'w') as f:
    json.dump(dataset, f, indent=2)
Esto crea un archivo dataset.json en el mismo directorio que tu notebook, que contiene tu lista de tareas lista para la evaluación de prompts.
Con esta base establecida, ahora tienes una forma sistemática de generar datos de prueba para evaluar qué tan bien funcionan tus prompts en diferentes tipos de tareas de codificación relacionadas con AWS.