Claude puede leer y analizar archivos PDF directamente, lo que lo convierte en una herramienta poderosa para el procesamiento de documentos. Esta capacidad funciona de manera similar al procesamiento de imágenes, pero con algunas diferencias clave en cómo estructuras tu código.
Configuración del procesamiento de PDF
Para procesar un archivo PDF con Claude, usarás un código casi idéntico al que usarías para imágenes. Las principales diferencias están en las especificaciones del tipo de archivo y los nombres de las variables para mayor claridad.
Así es como puedes modificar tu código existente de procesamiento de imágenes para PDFs:
with open("earth.pdf", "rb") as f:
    file_bytes = base64.standard_b64encode(f.read()).decode("utf-8")

messages = []

add_user_message(
    messages,
    [
        {
            "type": "document",
            "source": {
                "type": "base64",
                "media_type": "application/pdf",
                "data": file_bytes,
            },
        },
        {"type": "text", "text": "Summarize the document in one sentence"},
    ],
)

chat(messages)
Cambios clave respecto al procesamiento de imágenes
Al adaptar tu código de procesamiento de imágenes para PDFs, necesitas actualizar varios elementos:
- Cambia la extensión del archivo de
.pnga.pdf - Actualiza el nombre de la variable de
image_bytesafile_bytespara mayor claridad - Establece el tipo como
"document"en lugar de"image" - Cambia el tipo de medio a
"application/pdf"en lugar de"image/png"
Qué puede extraer Claude de los PDFs
Las capacidades de procesamiento de PDF de Claude van más allá de la simple extracción de texto. Puede analizar y comprender:
- Contenido de texto en todo el documento
- Imágenes y gráficos incrustados en el PDF
- Tablas y sus relaciones de datos
- Estructura y formato del documento
Esto convierte a Claude esencialmente en una solución integral para extraer cualquier tipo de información de documentos PDF, ya sea que necesites resúmenes, análisis de datos o extracción de contenido específico.
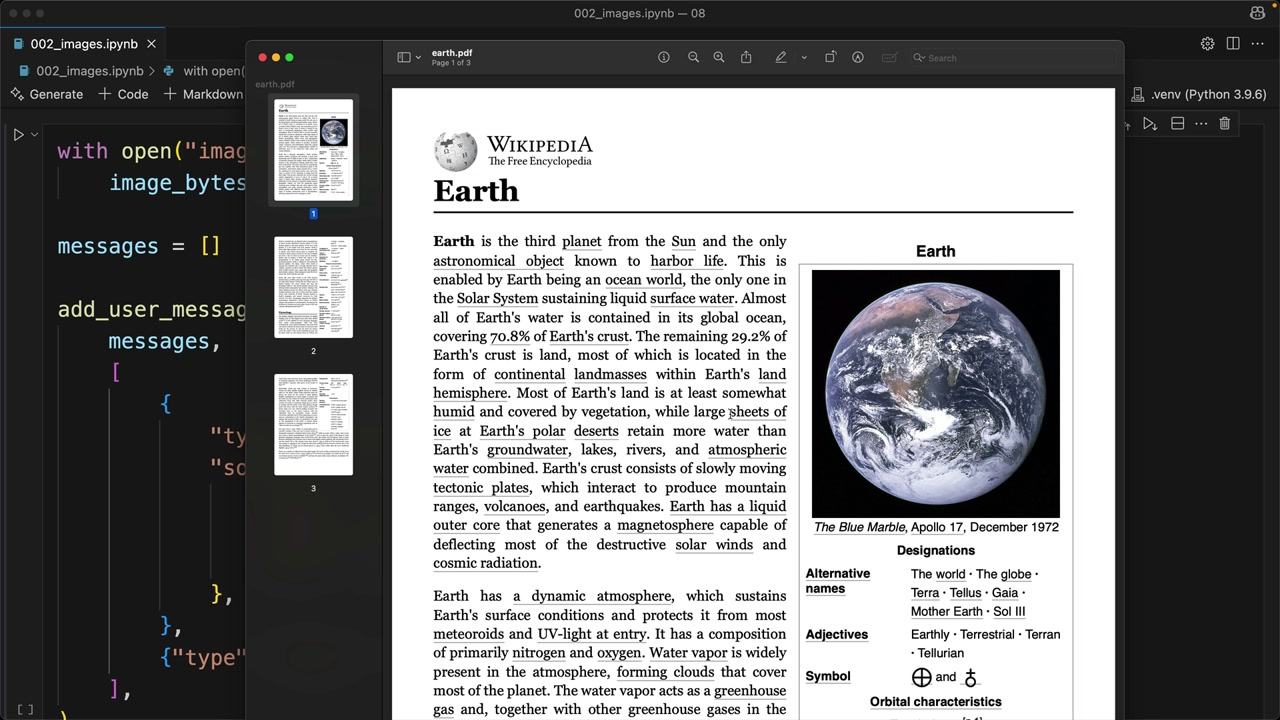
El ejemplo anterior muestra a Claude procesando con éxito un artículo de Wikipedia sobre la Tierra que fue guardado como PDF, demostrando cómo puede comprender y resumir contenido complejo de documentos en una sola oración.