Al construir flujos de trabajo de evaluación de prompts, los sistemas de calificación proporcionan señales objetivas sobre la calidad de la salida. Un calificador toma la salida del modelo y devuelve algún tipo de retroalimentación medible, típicamente un número entre 1 y 10, donde 10 representa alta calidad y 1 representa baja calidad.
Tipos de calificadores
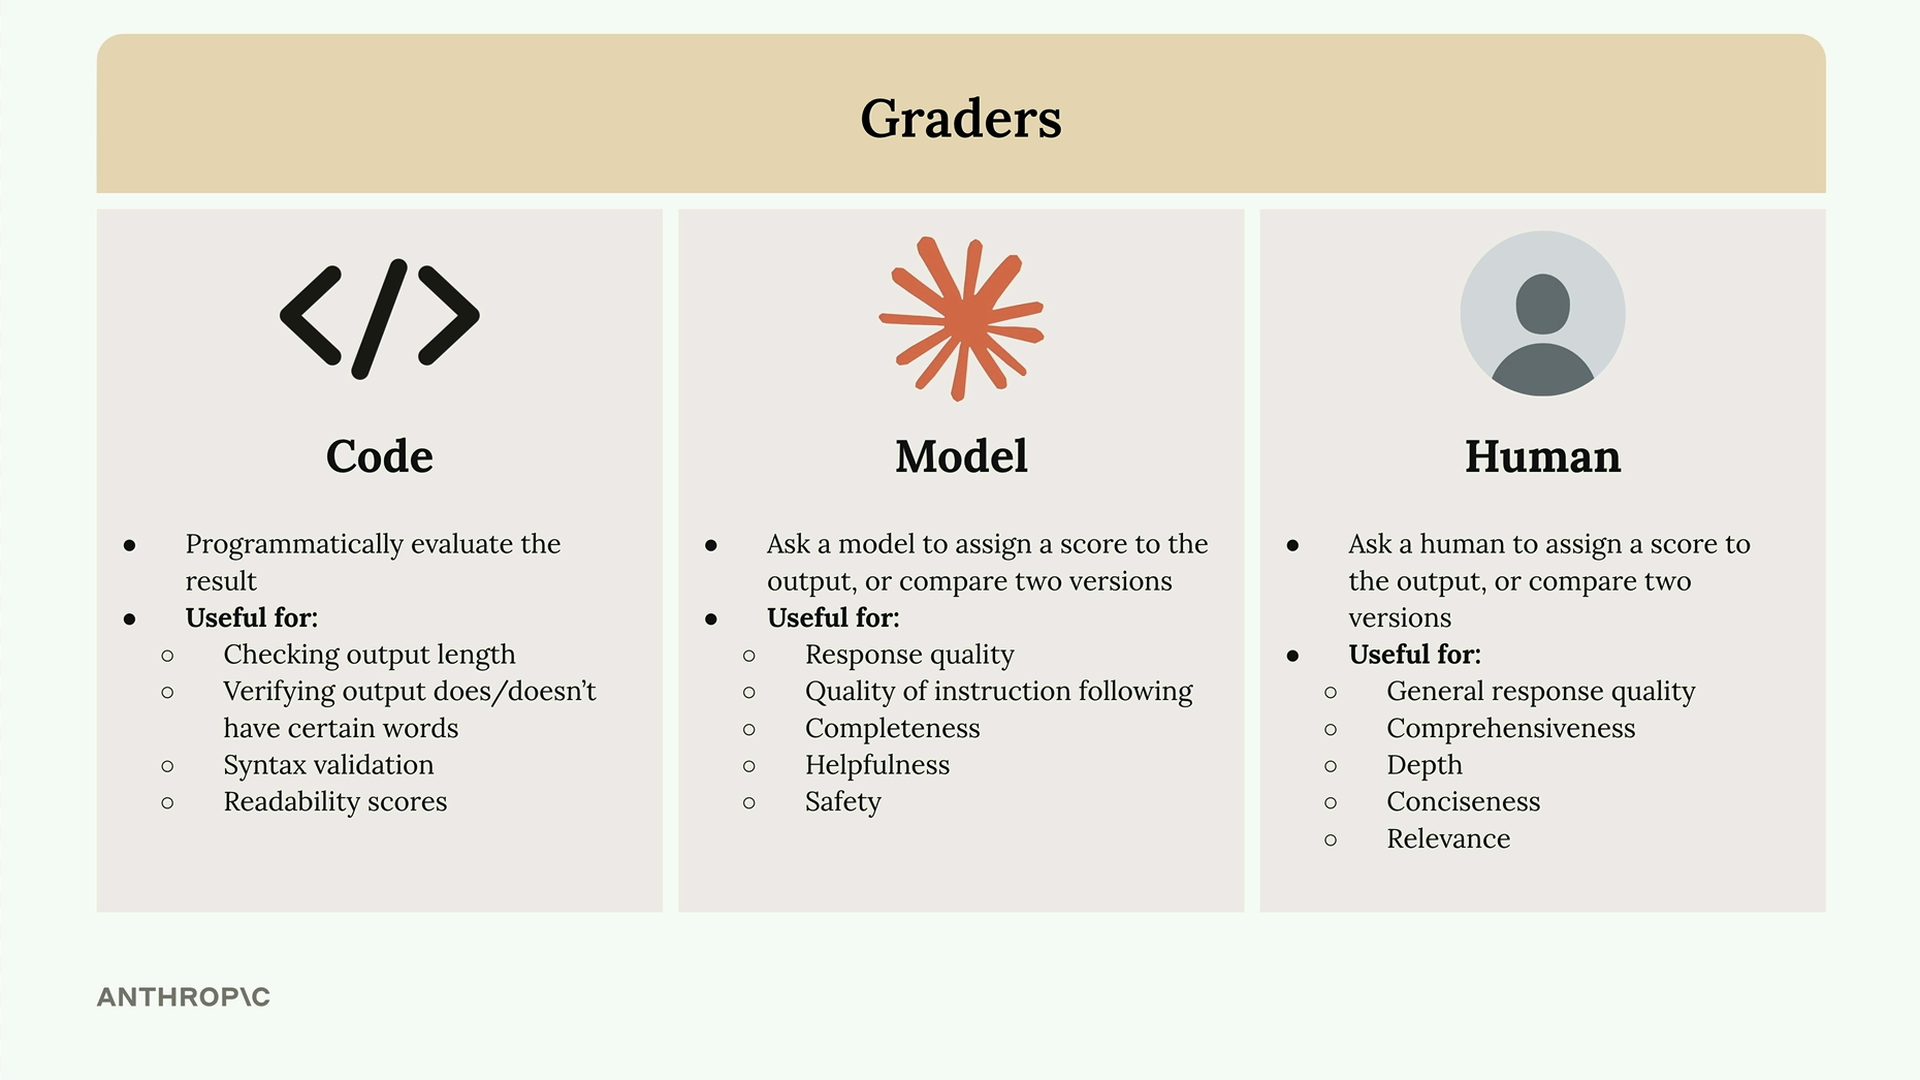
Hay tres enfoques principales para calificar las salidas del modelo:
- Calificadores de código - Evalúan las salidas programáticamente usando lógica personalizada
- Calificadores de modelo - Usan otro modelo de IA para evaluar la calidad
- Calificadores humanos - Hacen que personas revisen y puntúen manualmente las salidas
Calificadores de código
Los calificadores de código te permiten implementar cualquier verificación programática que puedas imaginar. Los usos comunes incluyen:
- Verificar la longitud de la salida
- Verificar que la salida tenga o no ciertas palabras
- Validación de sintaxis para JSON, Python o regex
- Puntuaciones de legibilidad
El único requisito es que tu código devuelva alguna señal utilizable, generalmente un número entre 1 y 10.
Calificadores de modelo
Los calificadores de modelo alimentan tu salida original en otra llamada a la API para su evaluación. Este enfoque ofrece una flexibilidad tremenda para evaluar:
- Calidad de la respuesta
- Calidad del seguimiento de instrucciones
- Completitud
- Utilidad
- Seguridad
Calificadores humanos
Los calificadores humanos proporcionan la mayor flexibilidad, pero son lentos y tediosos. Son útiles para evaluar:
- Calidad general de la respuesta
- Exhaustividad
- Profundidad
- Concisión
- Relevancia
Definición de criterios de evaluación
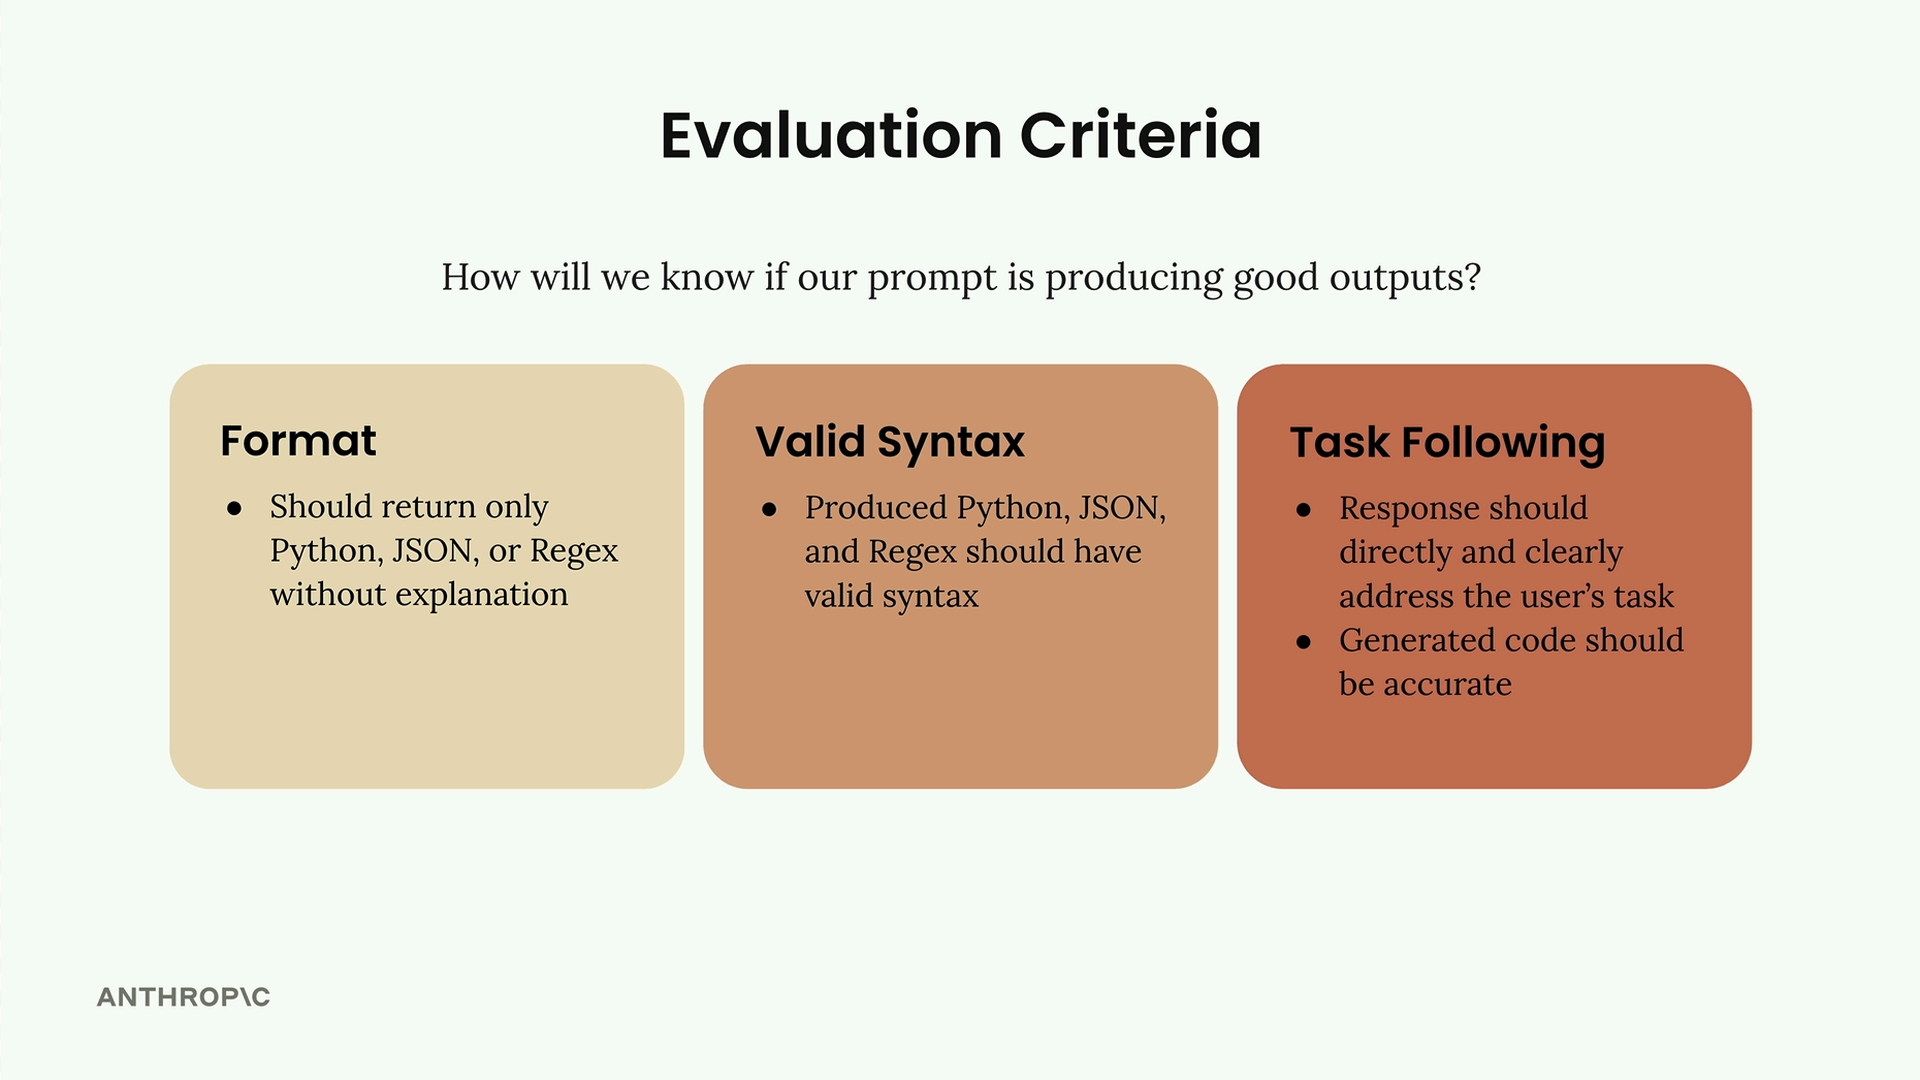
Antes de implementar cualquier calificador, necesitas criterios de evaluación claros. Para un prompt de generación de código, podrías enfocarte en:
- Formato - Debe devolver solo Python, JSON o Regex sin explicación
- Sintaxis válida - El código producido debe tener sintaxis válida
- Seguimiento de la tarea - La respuesta debe abordar directamente la tarea del usuario con código preciso
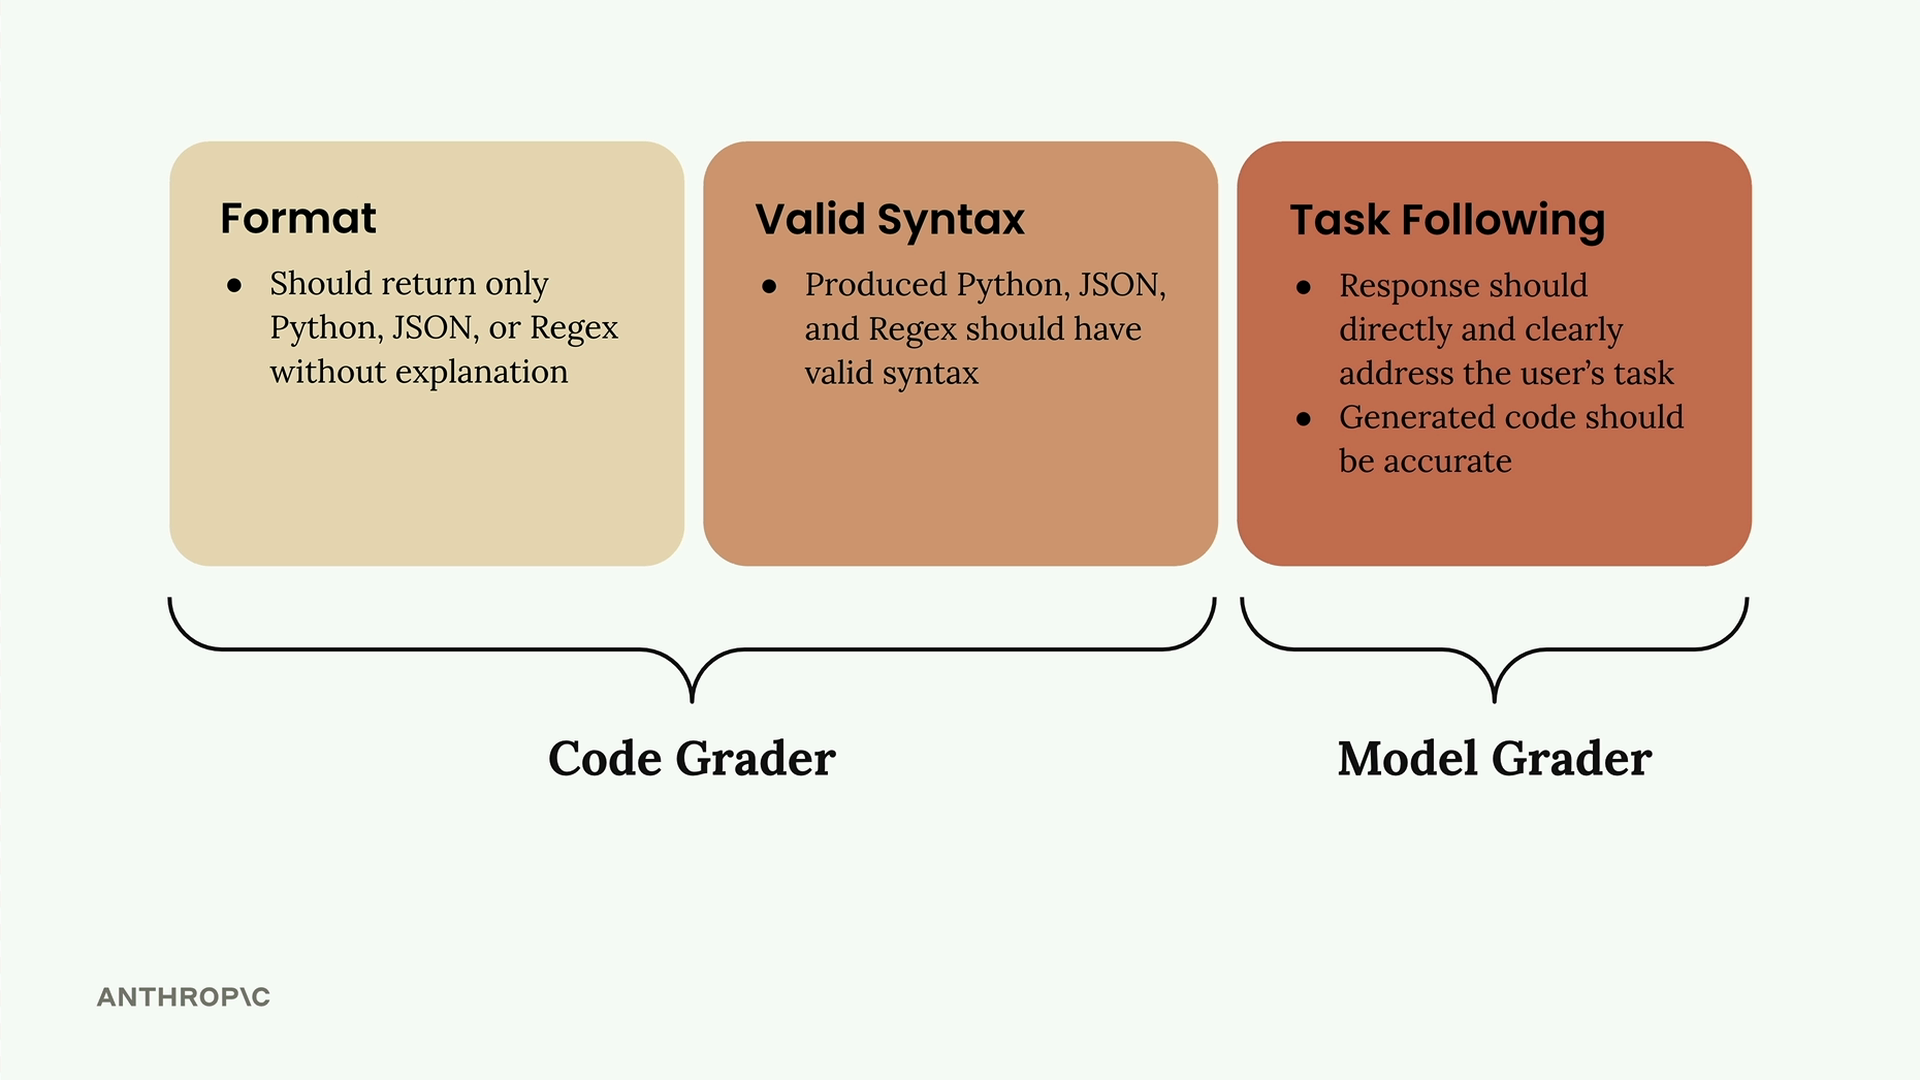
Los primeros dos criterios funcionan bien con calificadores de código, mientras que el seguimiento de la tarea es más adecuado para calificadores de modelo debido a su flexibilidad.
Implementación de un calificador de modelo
Así es como se construye una función de calificador de modelo:
def grade_by_model(test_case, output):
    # Crear prompt de evaluación
    eval_prompt = """
    You are an expert code reviewer. Evaluate this AI-generated solution.

    Task: {task}
    Solution: {solution}

    Provide your evaluation as a structured JSON object with:
    - "strengths": An array of 1-3 key strengths
    - "weaknesses": An array of 1-3 key areas for improvement
    - "reasoning": A concise explanation of your assessment
    - "score": A number between 1-10
    """

    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")

    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)
La idea clave es pedir fortalezas, debilidades y razonamiento junto con la puntuación. Sin este contexto, los modelos tienden a caer por defecto en puntuaciones intermedias alrededor de 6. ## Integración de la calificación en tu flujo de trabajo Actualiza tu ejecutor de casos de prueba para llamar al calificador: ``` def run_test_case(test_case): output = run_prompt(test_case) # Grade the output model_grade = grade_by_model(test_case, output) score = model_grade["score"] reasoning = model_grade["reasoning"] return \{ "output": output, "test_case": test_case, "score": score, "reasoning": reasoning \} ``` `` Finalmente, calcula una puntuación promedio en todos los casos de prueba: ``` from statistics import mean def run_eval(dataset): results = [] for test_case in dataset: result = run_test_case(test_case) results.append(result) average_score = mean([result["score"] for result in results]) print(f"Average score: \{average_score\}") return results ``` ` Esto te da una métrica objetiva para rastrear mientras iteras en tu prompt. Aunque los calificadores de modelo pueden ser algo caprichosos, proporcionan una línea base consistente para medir mejoras. ` ``