Hemos construido implementaciones separadas para la búsqueda semántica (usando embeddings vectoriales) y la búsqueda léxica (usando BM25). Ahora es momento de combinarlas en un pipeline de búsqueda unificado que aproveche las fortalezas de ambos enfoques.
La arquitectura Multi-Index
Tanto nuestra clase VectorIndex como BM25Index comparten APIs casi idénticas: ambas tienen métodos add_document() y search(). Esta consistencia hace que sea sencillo envolverlas juntas en una nueva clase llamada Retriever.
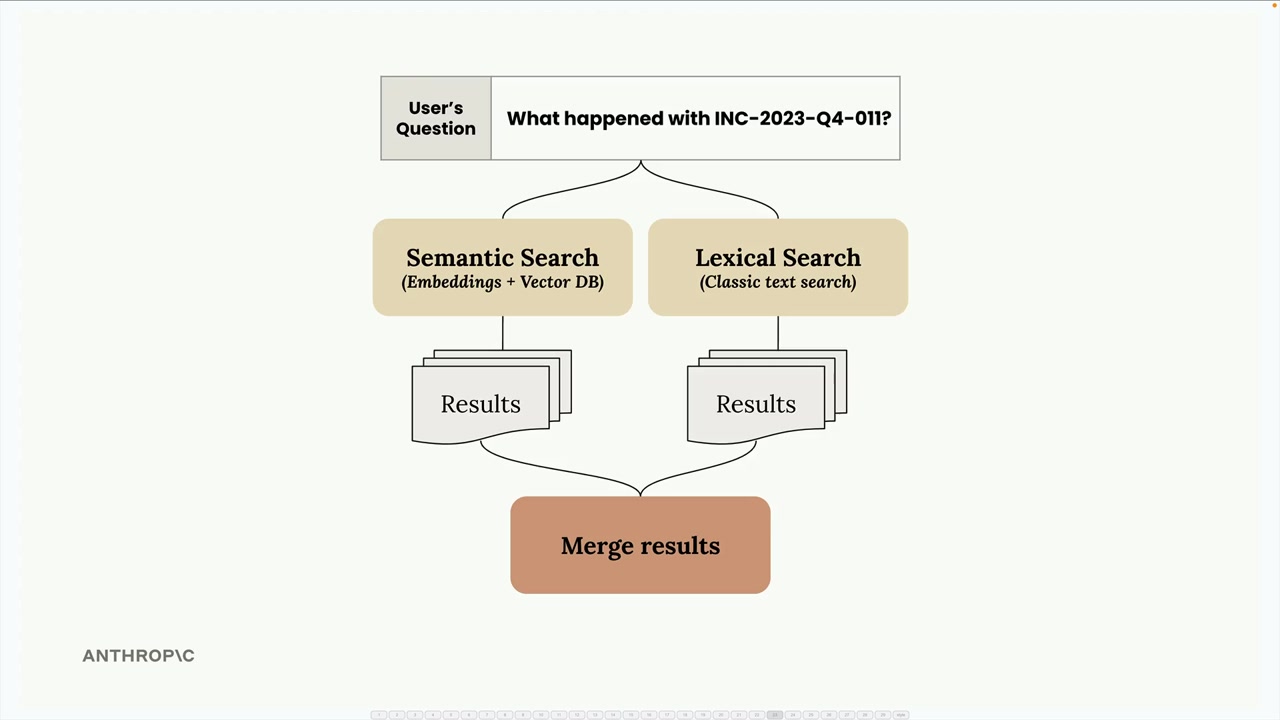
El Retriever actúa como un coordinador que reenvía las consultas del usuario a ambos índices, recopila sus resultados y los combina usando una técnica llamada reciprocal rank fusion.
Entendiendo Reciprocal Rank Fusion
Combinar resultados de diferentes métodos de búsqueda no es tan simple como concatenar listas. Cada método usa sistemas de puntuación diferentes, por lo que necesitamos una forma de normalizar y combinar sus clasificaciones de manera justa.
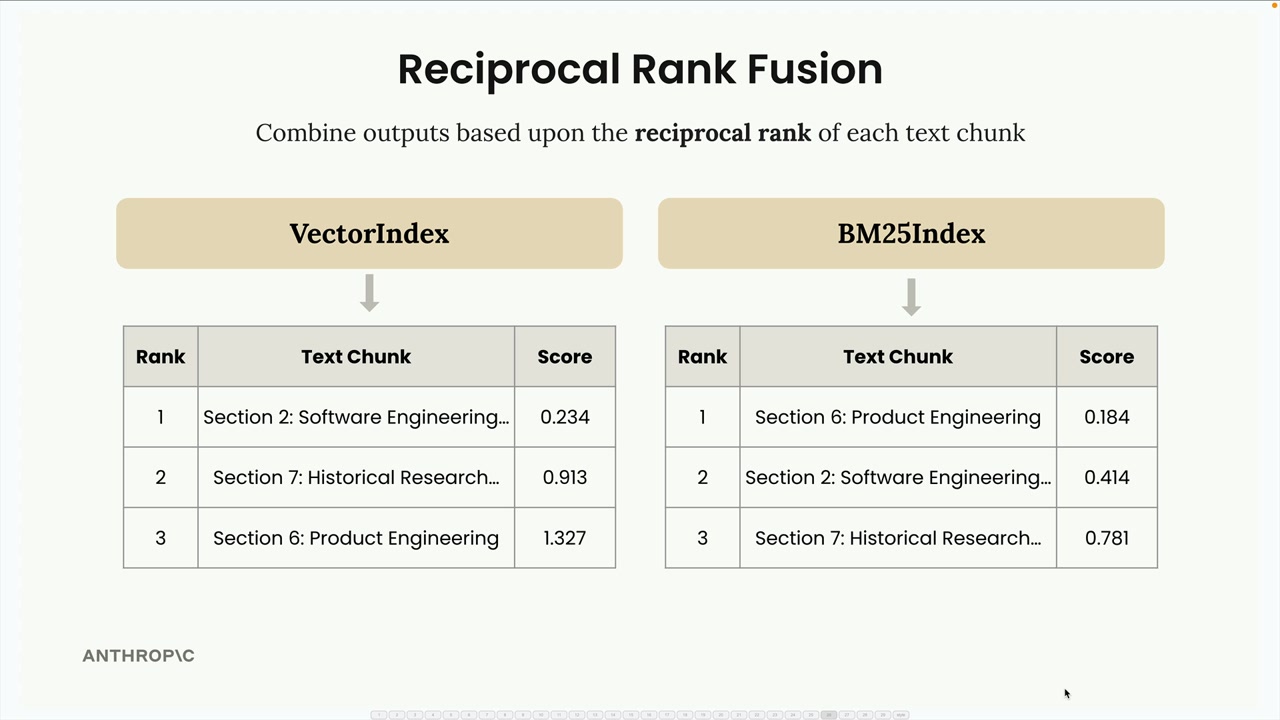
Así es como funciona reciprocal rank fusion con un ejemplo. Supongamos que buscamos información sobre "INC-2023-Q4-011" y obtenemos estos resultados:
- VectorIndex devuelve: Sección 2 (rango 1), Sección 7 (rango 2), Sección 6 (rango 3)
- BM25Index devuelve: Sección 6 (rango 1), Sección 2 (rango 2), Sección 7 (rango 3)
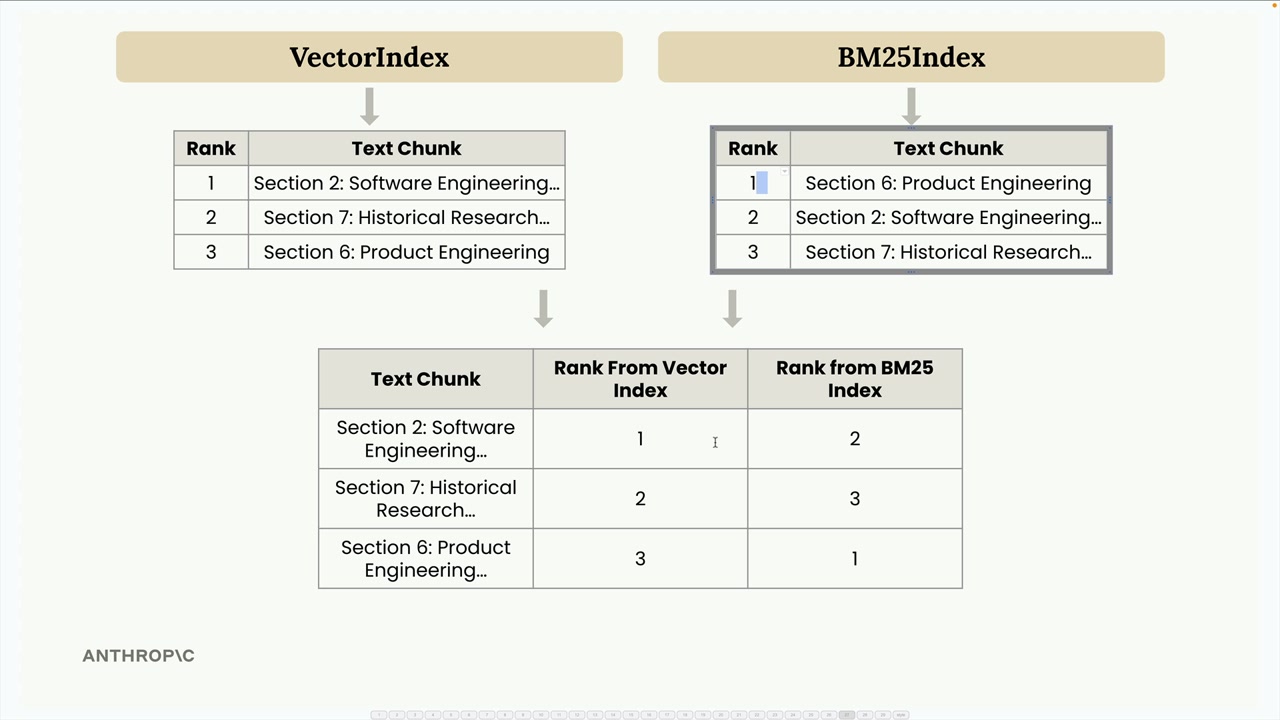
Combinamos esto en una sola tabla que muestra el rango de cada fragmento de texto en ambos índices, y luego aplicamos la fórmula RRF:
RRF_score(d) = Σ(1 / (k + rank_i(d)))Donde k es una constante (a menudo 60, pero usaremos 1 para obtener resultados más claros) y rank_i(d) es el rango del documento d en la i-ésima clasificación.
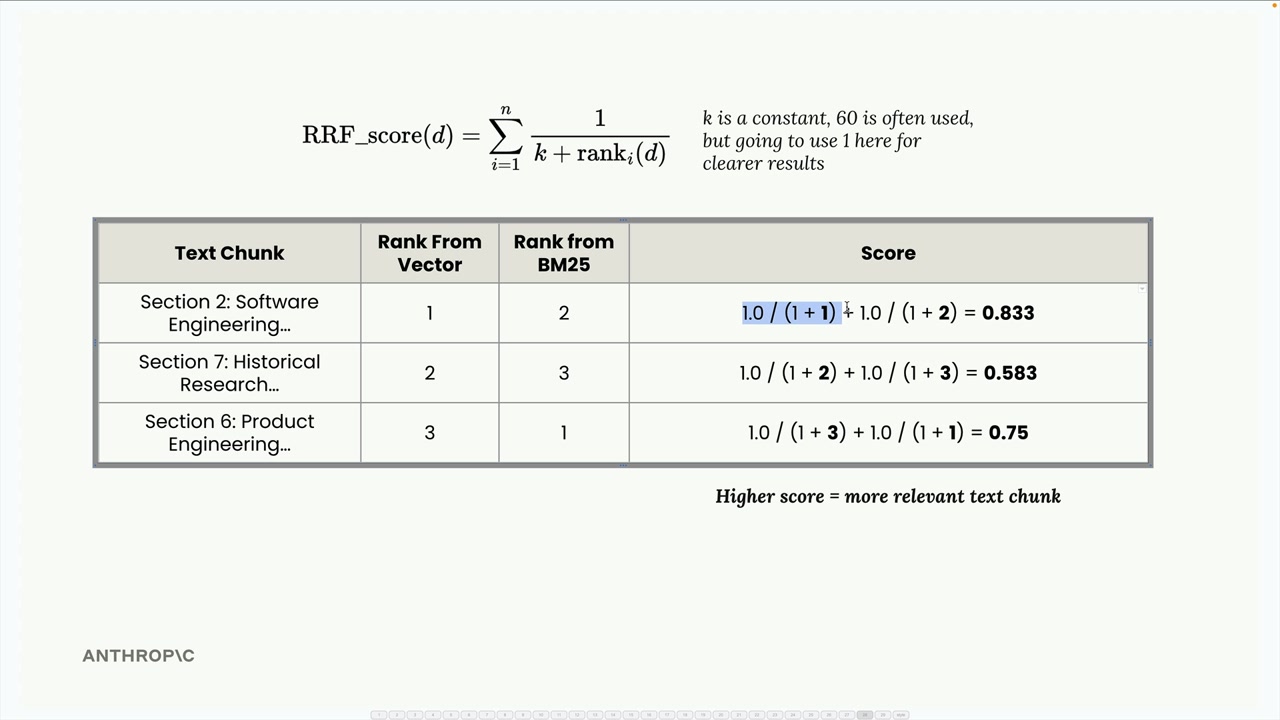
Para nuestro ejemplo:
- Sección 2: 1.0/(1+1) + 1.0/(1+2) = 0.833
- Sección 7: 1.0/(1+2) + 1.0/(1+3) = 0.583
- Sección 6: 1.0/(1+3) + 1.0/(1+1) = 0.75
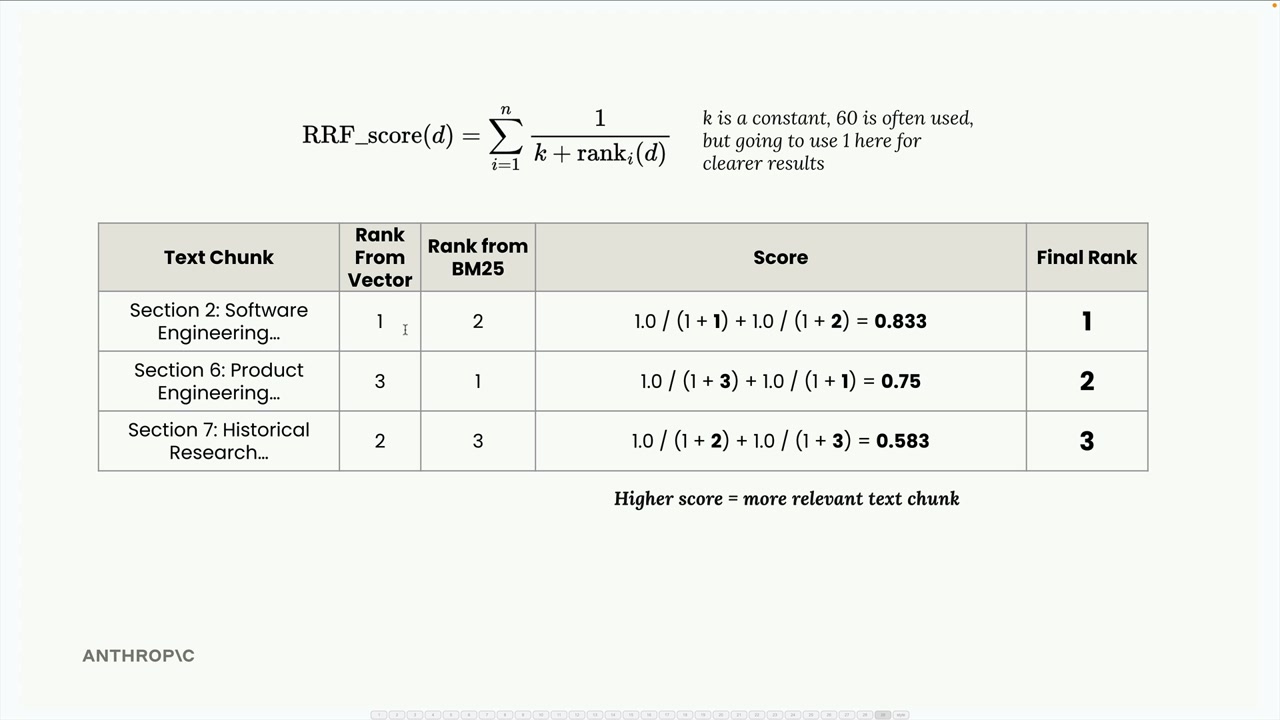
La clasificación final queda así: Sección 2 (0.833), Sección 6 (0.75), Sección 7 (0.583). Esto tiene sentido intuitivo: la Sección 2 tuvo buen desempeño en ambos índices, por lo que sube a la cima.
Detalles de implementación
La clase Retriever envuelve múltiples índices de búsqueda y proporciona una interfaz unificada:
class Retriever:
    def __init__(self, *indexes: SearchIndex):
        if len(indexes) == 0:
            raise ValueError("At least one index must be provided")
        self._indexes = list(indexes)

    def add_document(self, document: Dict[str, Any]):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text: str, k: int = 1, k_rrf: int = 60):
        # Obtener resultados de todos los índices
        all_results = []
        for idx, results in enumerate(all_results):
            for rank, (doc, _) in enumerate(results):
                # Rastrear rangos de documentos entre índices
                # Aplicar la fórmula de puntuación RRF
        # Devolver resultados combinados y ordenados
La idea clave es que, al mantener APIs consistentes entre diferentes implementaciones de búsqueda, podemos combinarlas fácilmente sin un acoplamiento estrecho.
Probando el enfoque híbrido
¿Recuerdas nuestro problema anterior donde buscar "what happened with INC-2023-Q4-011?" devolvía resultados inesperados con el enfoque solo vectorial? El incidente de ciberseguridad (Sección 10) apareció primero, pero el análisis financiero (Sección 3) apareció en segundo lugar en lugar de la sección de ingeniería de software, que era más relevante.
Con nuestro retriever híbrido, ahora obtenemos resultados mucho mejores:
- Sección 10: Análisis de ciberseguridad - Informe de respuesta a incidentes (más relevante)
- Sección 2: Ingeniería de software - Mejoras de estabilidad del Proyecto Phoenix (segunda más relevante)
- Sección 5: Desarrollos legales (tercera)
Esto demuestra cómo combinar la búsqueda semántica y léxica puede superar las limitaciones de cualquiera de los dos enfoques usados por separado.
Extensibilidad
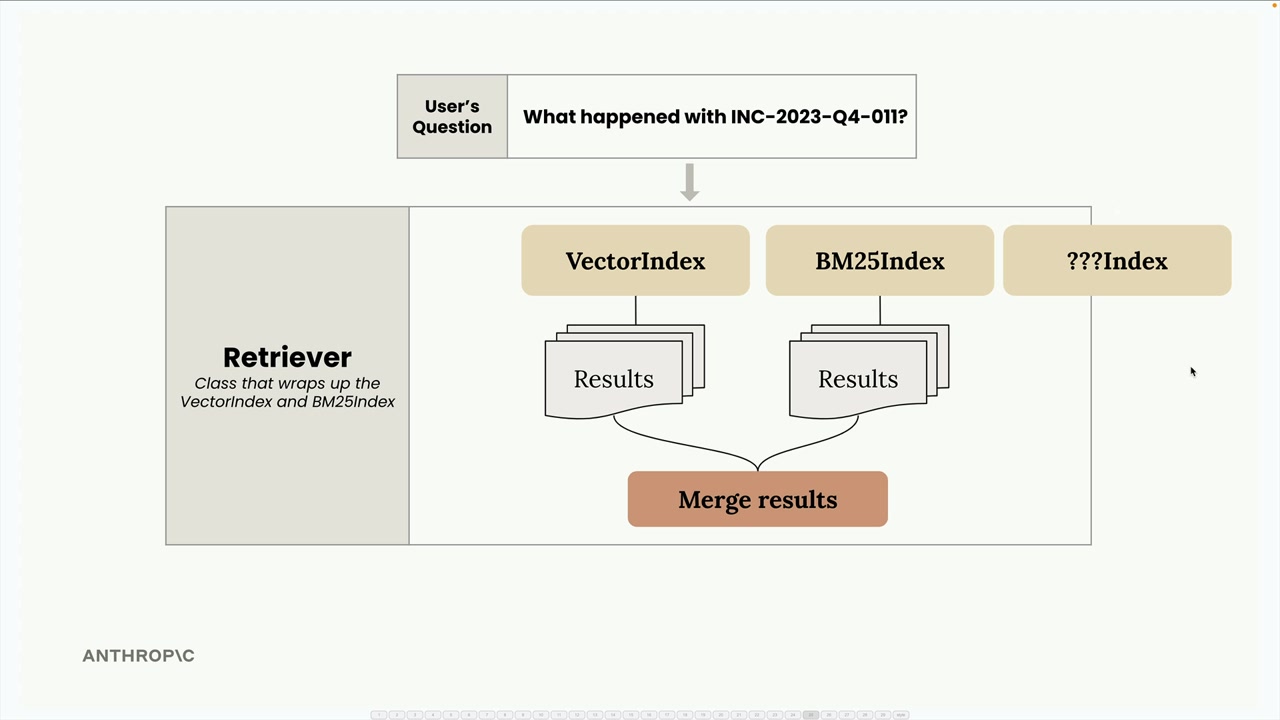
La belleza de esta arquitectura es su extensibilidad. Dado que todos los índices implementan el mismo protocolo SearchIndex con los métodos add_document() y search(), puedes agregar fácilmente nuevas metodologías de búsqueda:
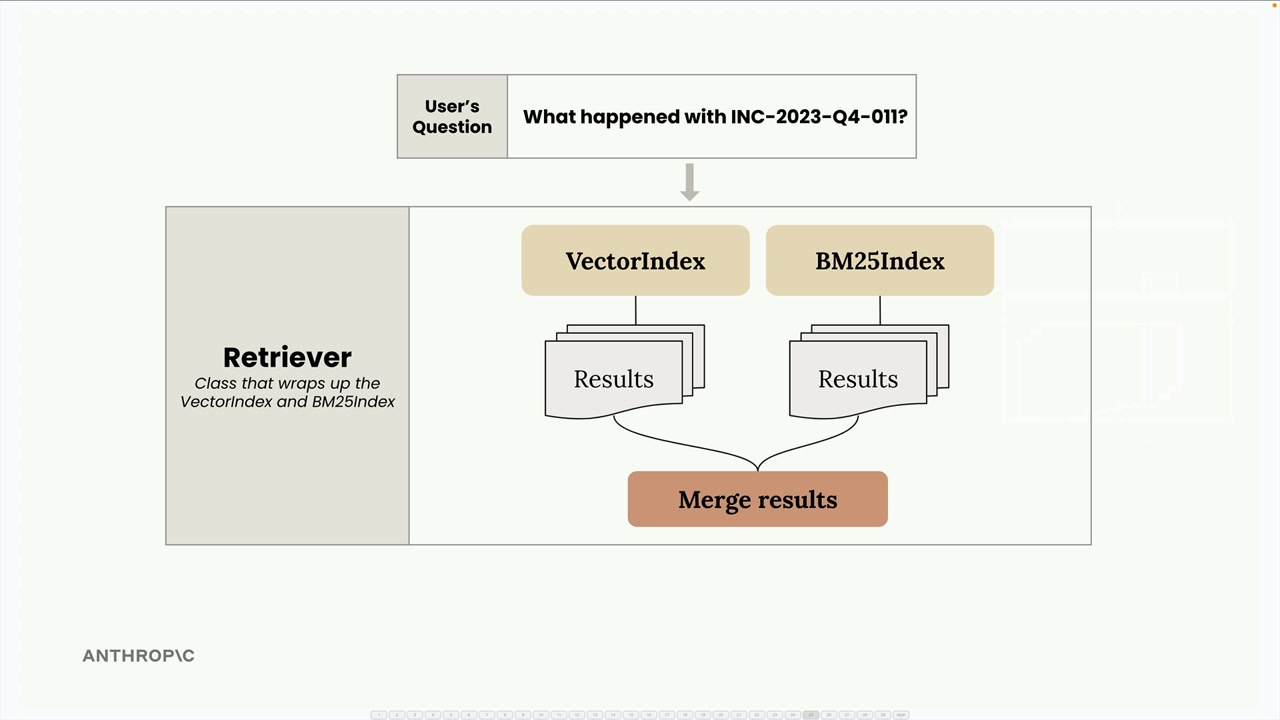
¿Quieres agregar un índice basado en palabras clave? ¿Una búsqueda basada en grafos? ¿Un índice de dominio especializado? Simplemente implementa la misma interfaz y el Retriever lo incorporará automáticamente al proceso de fusión.
Este enfoque modular mantiene cada implementación de búsqueda enfocada y comprobable, a la vez que proporciona una forma limpia de combinar sus fortalezas en el sistema final.