Ahora que entendemos el flujo de RAG conceptualmente, vamos a implementarlo paso a paso. Recorreremos un ejemplo completo que demuestra cómo dividir texto en fragmentos, generar embeddings, almacenarlos en una base de datos vectorial y realizar búsquedas de similitud.
La implementación de RAG en cinco pasos
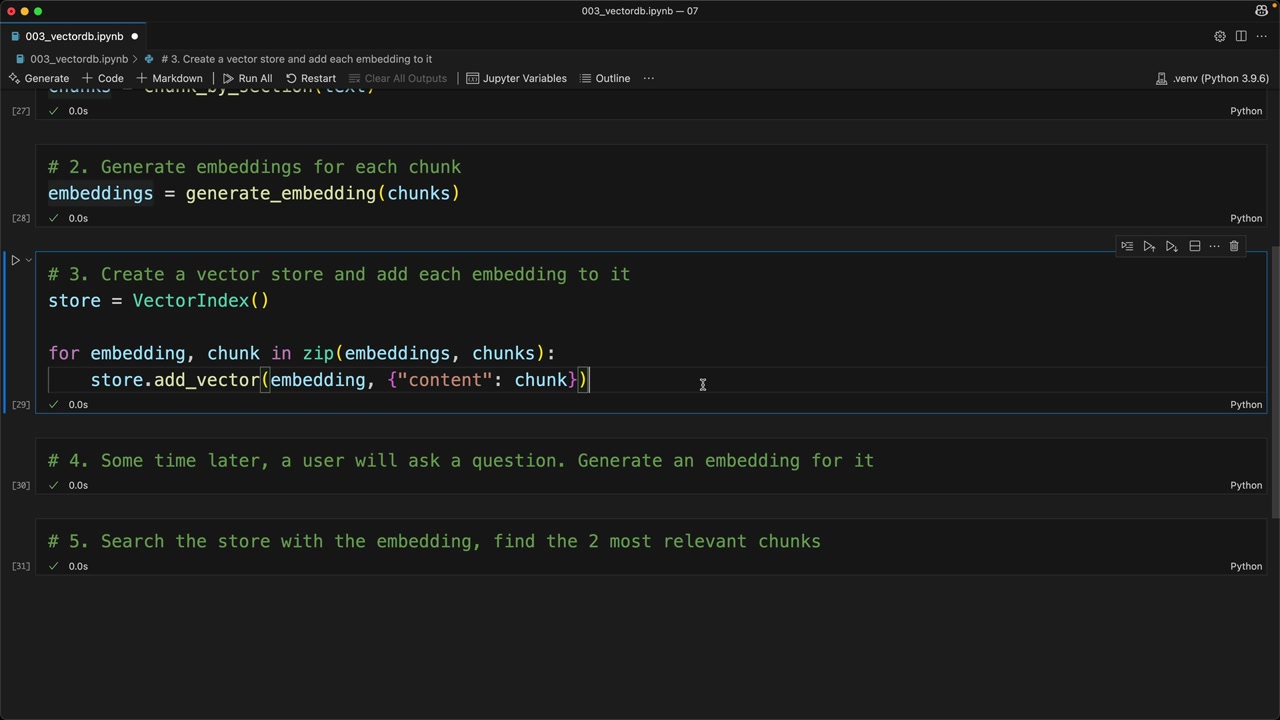
Nuestra implementación sigue los mismos cinco pasos que discutimos anteriormente:
- Dividir el texto en fragmentos por sección
- Generar embeddings para cada fragmento
- Crear un almacén vectorial y agregar cada embedding a él
- Generar un embedding para la pregunta del usuario
- Buscar en el almacén para encontrar los fragmentos más relevantes
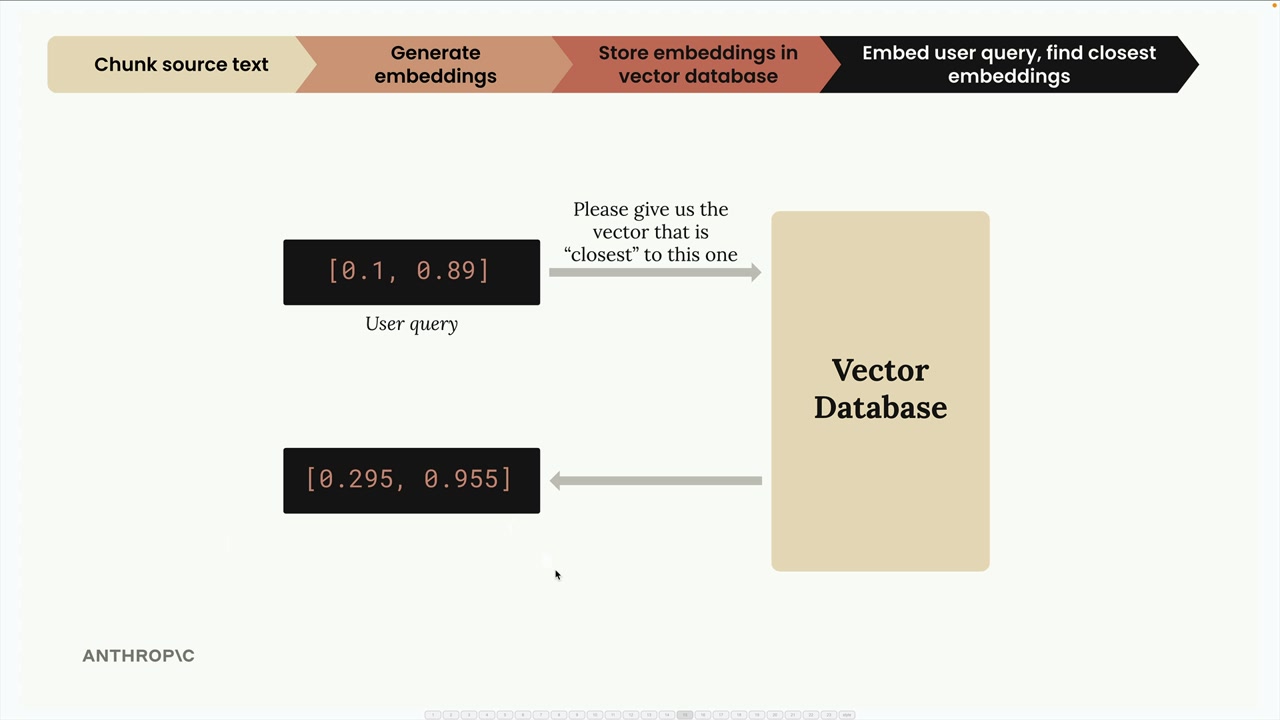
Este diagrama muestra cómo transformamos las consultas de los usuarios en embeddings y buscamos en nuestra base de datos vectorial para encontrar el contenido más relevante.
Paso 1: Dividir el texto en fragmentos
Primero, cargamos nuestro documento y lo dividimos en secciones manejables:
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
chunks[2]  # Test to see the table of contents
Usamos la misma función chunk_by_section de antes para dividir nuestro documento en secciones lógicas.
Paso 2: Generar embeddings
A continuación, creamos embeddings para todos nuestros fragmentos a la vez:
embeddings = generate_embedding(chunks)La función de embedding se ha actualizado para manejar tanto cadenas individuales como listas de cadenas, lo que la hace más eficiente para el procesamiento por lotes.
Paso 3: Almacenar en la base de datos vectorial
Ahora creamos nuestro almacén vectorial y lo poblamos con embeddings y su texto asociado:
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
Observa que almacenamos tanto el embedding como el contenido de texto original. Esto es crucial porque, cuando busquemos más adelante, necesitamos devolver el texto real, no solo los valores numéricos del embedding.
¿Por qué almacenar el texto original?
Cuando consultamos nuestra base de datos vectorial, obtener solo los números del embedding no es útil. Necesitamos el texto real que se usó para generar esos embeddings. Por eso incluimos el texto original del fragmento (o al menos una referencia a él) junto a cada embedding en nuestra base de datos.
Paso 4: Procesar las consultas del usuario
Cuando un usuario hace una pregunta, generamos un embedding para su consulta:
user_embedding = generate_embedding("What did the software engineering dept do last year?")Paso 5: Encontrar contenido relevante
Finalmente, buscamos en nuestro almacén vectorial para encontrar los fragmentos más similares:
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
Esta búsqueda devuelve los dos fragmentos más relevantes junto con sus puntuaciones de similitud (distancias coseno).
Los resultados de la búsqueda nos muestran qué secciones de nuestro documento son más relevantes para la pregunta del usuario, junto con las puntuaciones de similitud.
Entendiendo los resultados
Cuando ejecutamos nuestra consulta de ejemplo sobre el departamento de ingeniería de software, obtenemos:
- Sección 2: Ingeniería de software con una distancia de 0.71 (coincidencia más cercana)
- Sección de metodología con una distancia de 0.72 (segunda más cercana)
Valores de distancia más bajos indican mayor similitud, por lo que la Sección 2 es la más relevante para nuestra consulta.
¿Qué sigue?
Esta implementación funciona bien para casos básicos, pero hay escenarios en los que no se desempeña como se espera. En las siguientes secciones, exploraremos mejoras para hacer que nuestro sistema de RAG sea más robusto y preciso.
La conclusión clave es que RAG se trata fundamentalmente de convertir texto en números (embeddings), almacenar esos números de manera eficiente y luego usar similitud matemática para encontrar contenido relevante cuando los usuarios hacen preguntas.