从文档中提取文本块后,RAG 流程的下一步是找出哪些文本块与用户的问题最相关。这本质上是一个搜索问题——您需要查看所有文本块,并识别出与用户所询问内容相关的那些。
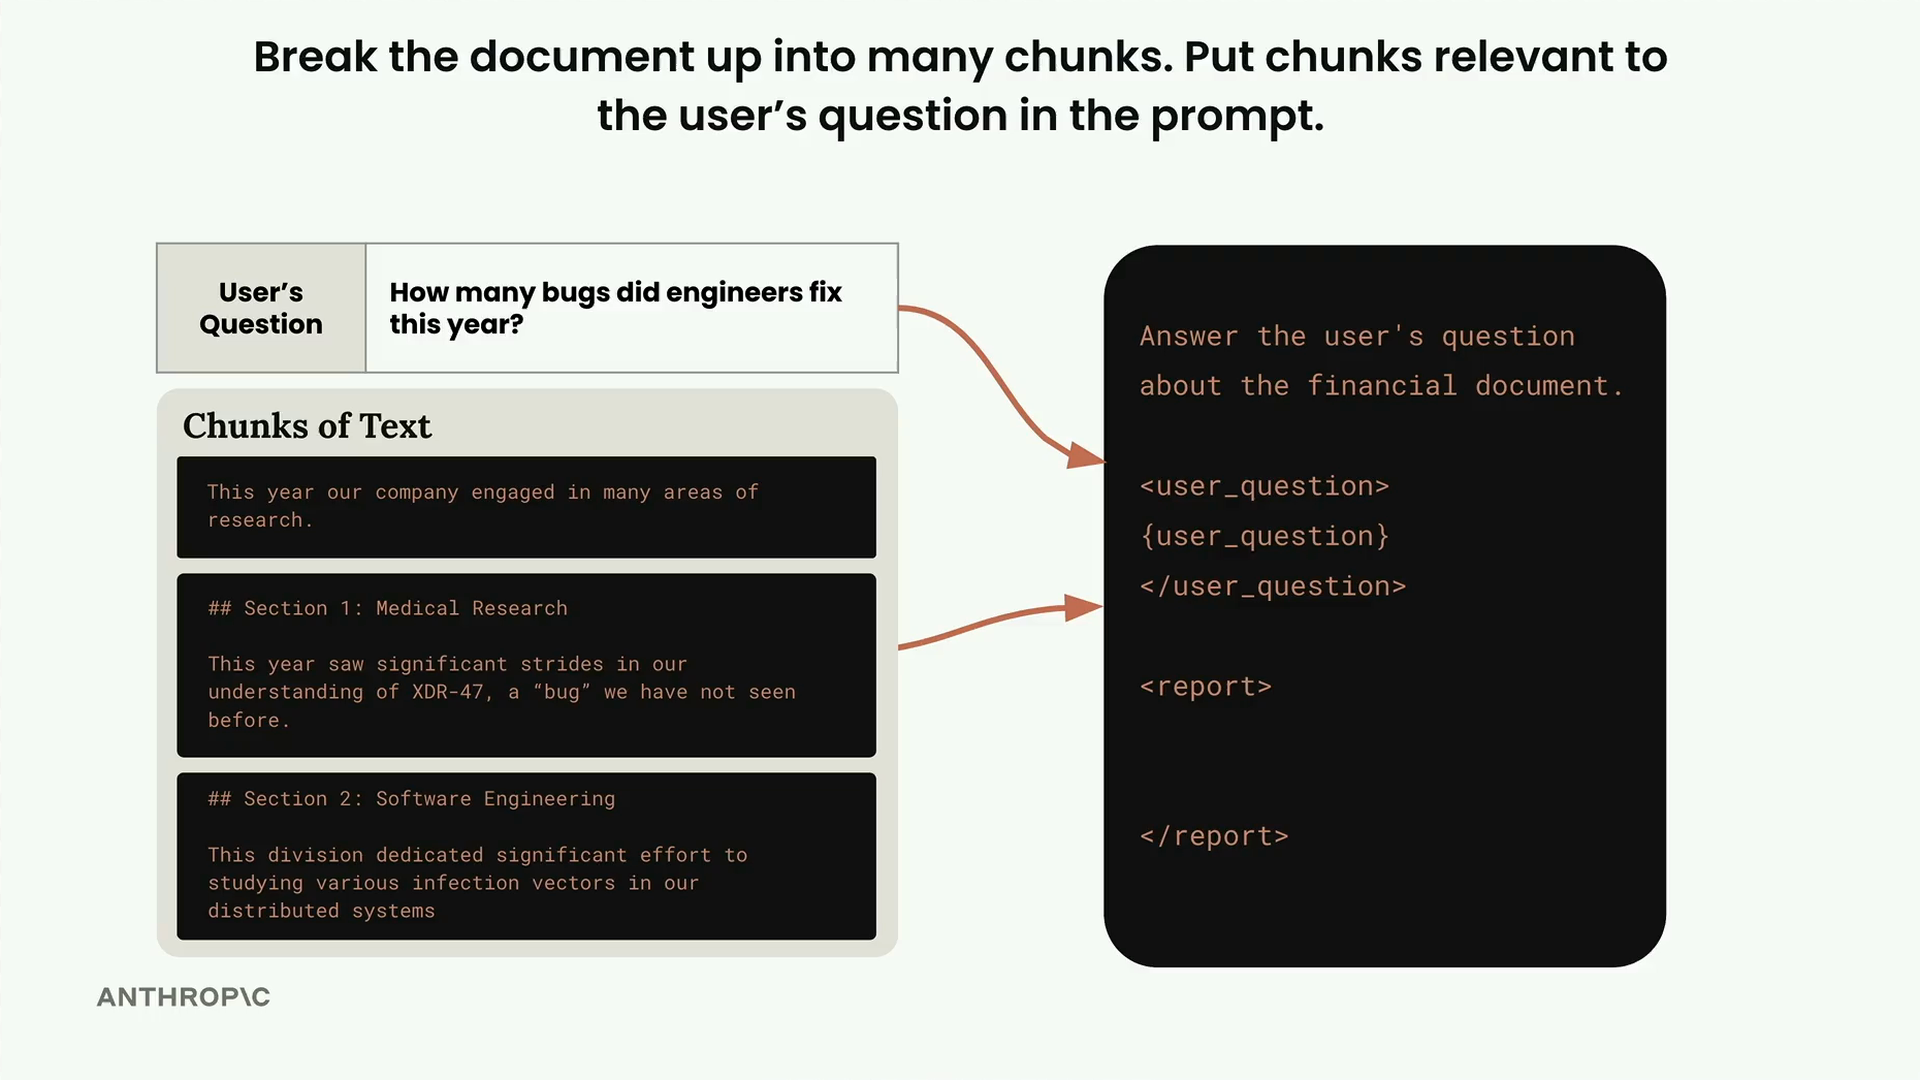
语义搜索
查找相关文本块最常见的方法是语义搜索。与传统的基于关键词的搜索不同,语义搜索使用文本嵌入来理解用户问题和每个文本块的实际含义。这使得系统即使在确切词语不匹配的情况下,也能找到概念上相关的内容。
什么是文本嵌入?
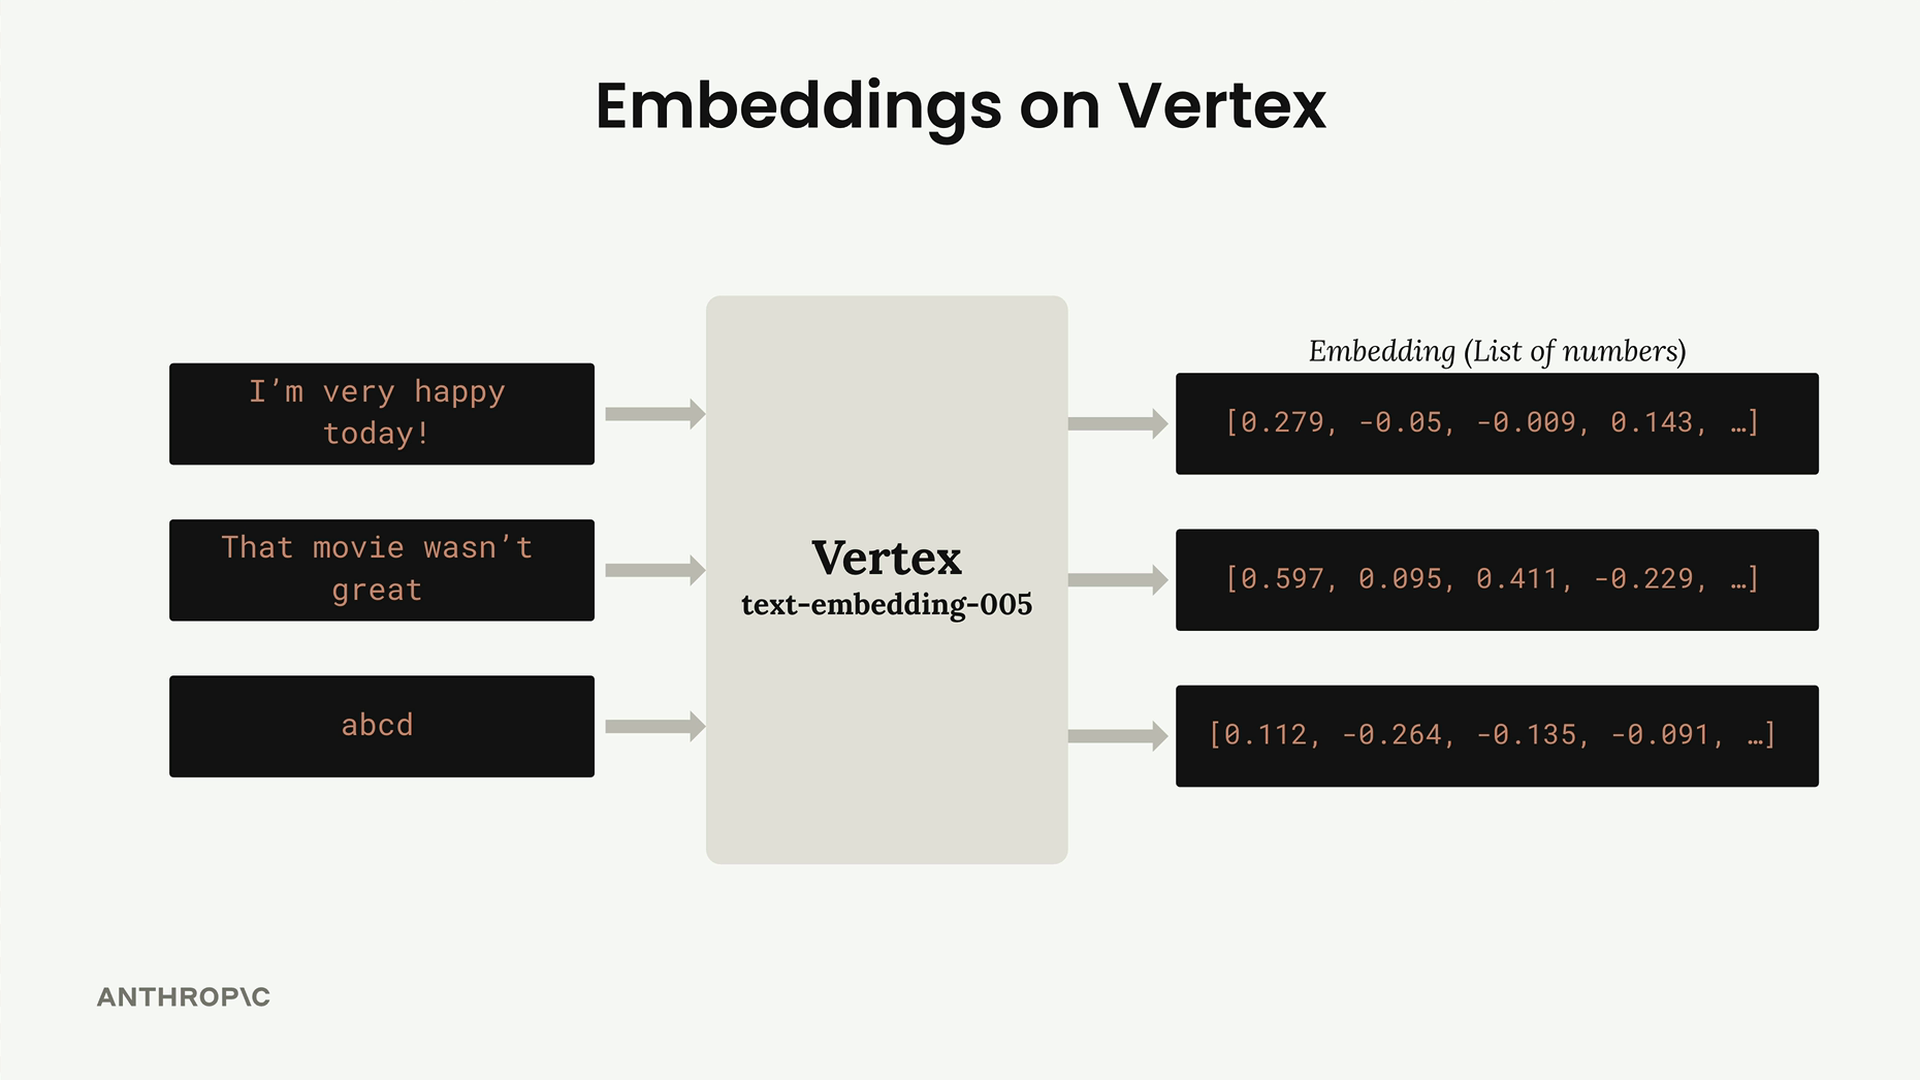
文本嵌入是对某段文本中所包含含义的数值表示。可以将其理解为将单词和句子转换为计算机可以进行数学运算的格式。
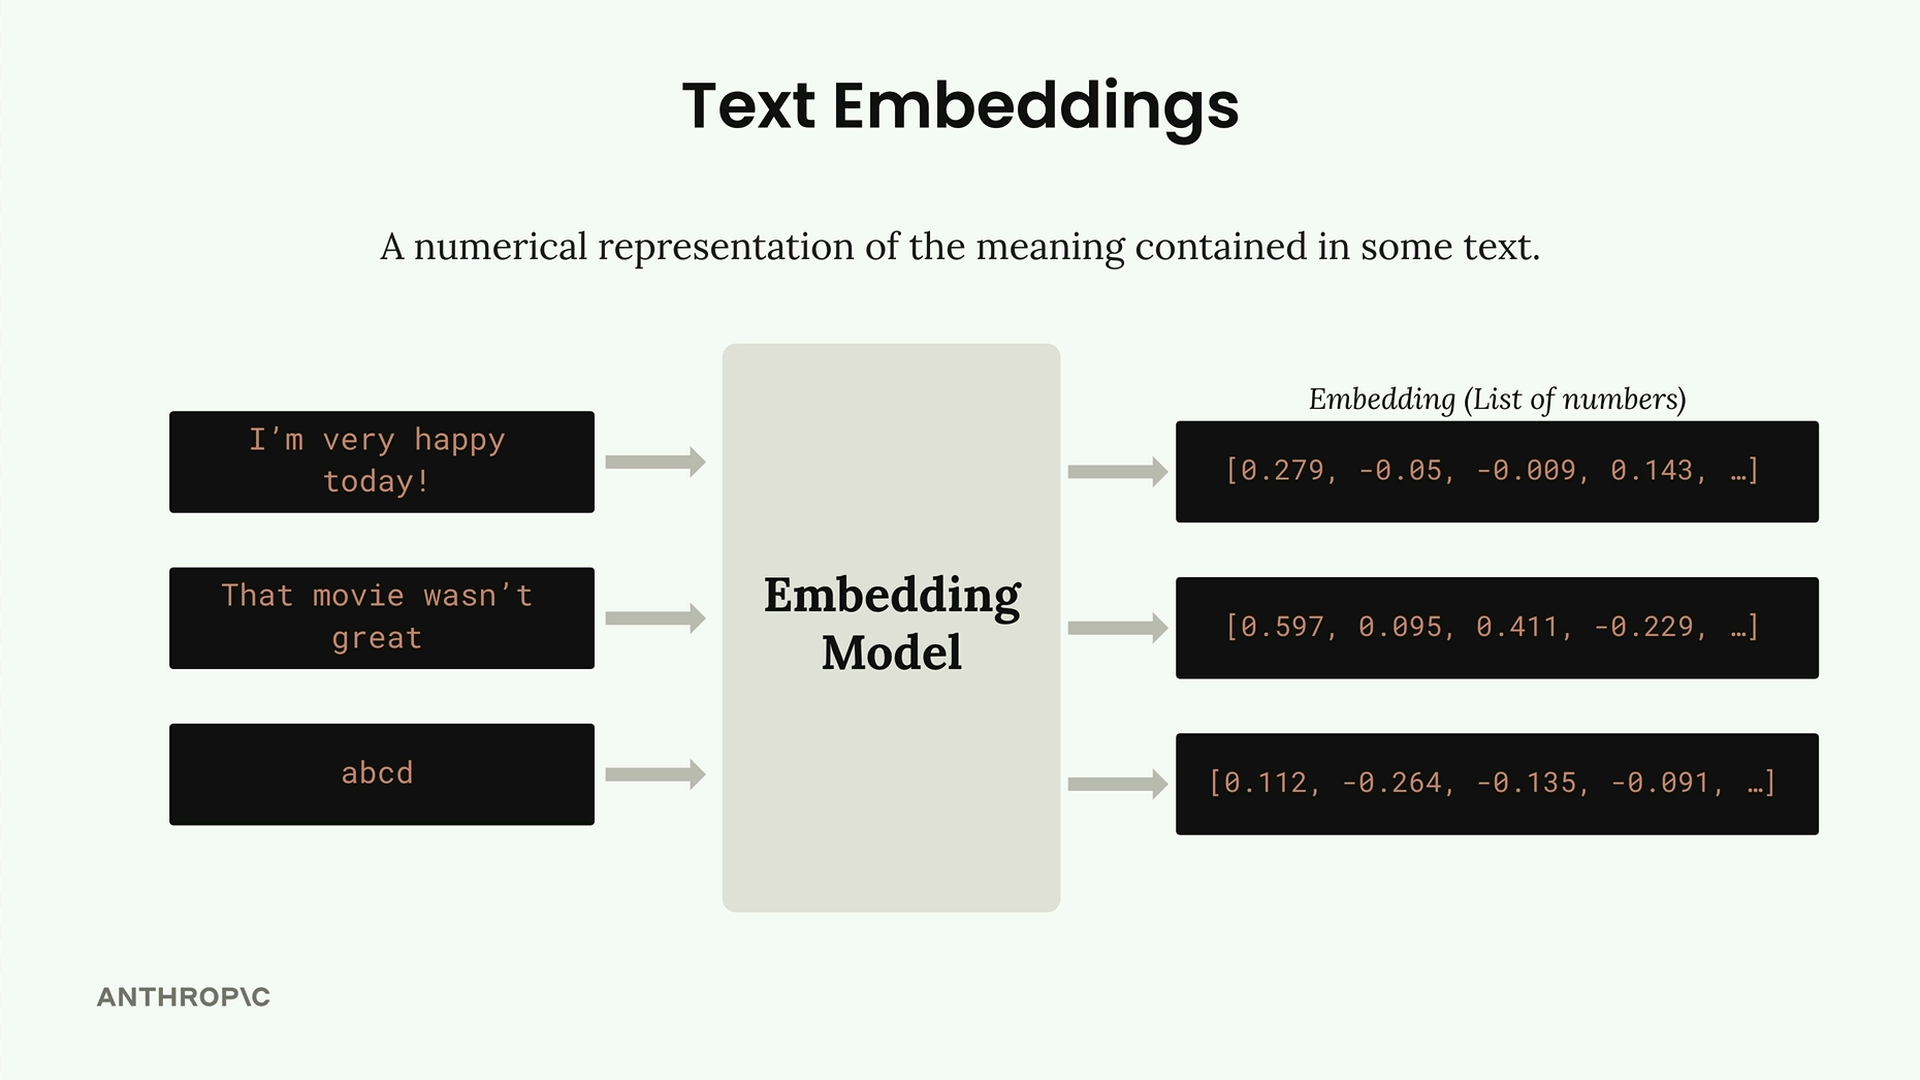
以下是该过程的工作原理:
- 您将文本输入到嵌入模型中
- 模型输出一长串数字(即嵌入)
- 每个数字的范围从 -1 到 +1
- 这些数字代表输入文本的不同特质或特征
理解这些数字
嵌入中的每个数字本质上都是输入文本某种特质的"分数"。然而,这里有一个重要的注意事项:我们实际上并不知道每个具体数字代表什么。
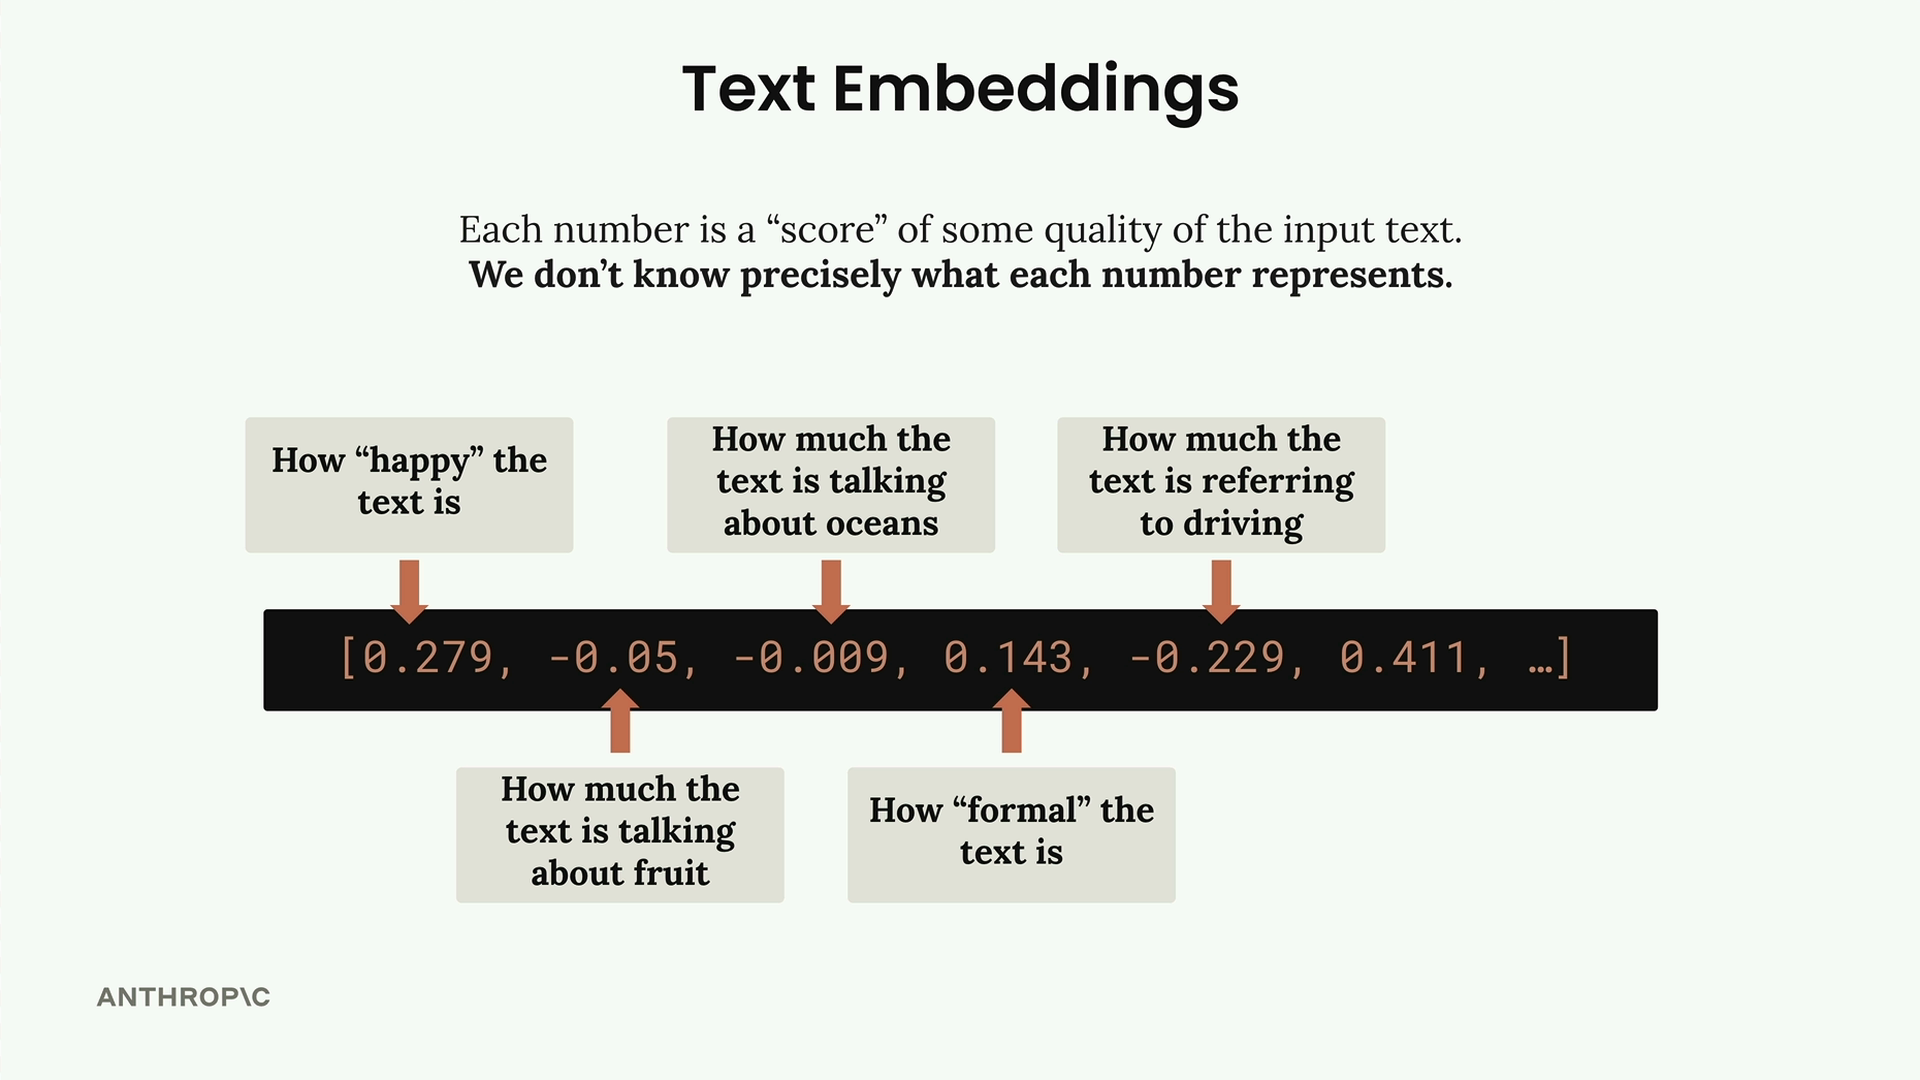
虽然设想某个数字可能代表"文本有多快乐",另一个数字可能代表"文本谈论海洋的程度"会很有帮助,但这些只是概念性的示例。嵌入模型在训练过程中学习这些特征,但它们并没有被明确标注,对我们来说也不具有可解释性。
尽管存在这种不透明性,嵌入仍然非常强大,因为它们以一种能够在不同文本片段之间进行数学比较的方式捕捉了语义含义。
Vertex AI 上的嵌入
Claude 无法直接生成嵌入。相反,您需要使用专门的嵌入模型。在 Vertex AI 上,我们将使用的模型称为 text-embedding-005。
实现
要在 Vertex AI 上使用嵌入,您需要安装 Google GenAI SDK:
bash
pip install google-genai以下是生成嵌入的基本设置:
python
from google import genai

client = genai.Client(
    project="YOUR_PROJECT_ID",
    location="global",
    vertexai=True
)

def generate_embedding(text):
    response = client.models.embed_content(
        model="text-embedding-005",
        contents=text
    )

    if not response.embeddings:
        return []

    return [e.values for e in response.embeddings]
当您使用一个文本块运行此函数时,您将得到一个浮点数列表,代表该文本的语义含义。这些嵌入构成了在您的 RAG 系统中实现语义搜索的基础。
下一步是理解如何使用这些嵌入来实际找到与用户问题最相关的文本块,这涉及通过数学方式比较嵌入以确定相似度。