Claude中的提示缓存(prompt caching)通过存储对消息所做的计算工作来实现,以便在后续请求中重复使用。这使得使用缓存内容的请求既更便宜又能更快地执行。
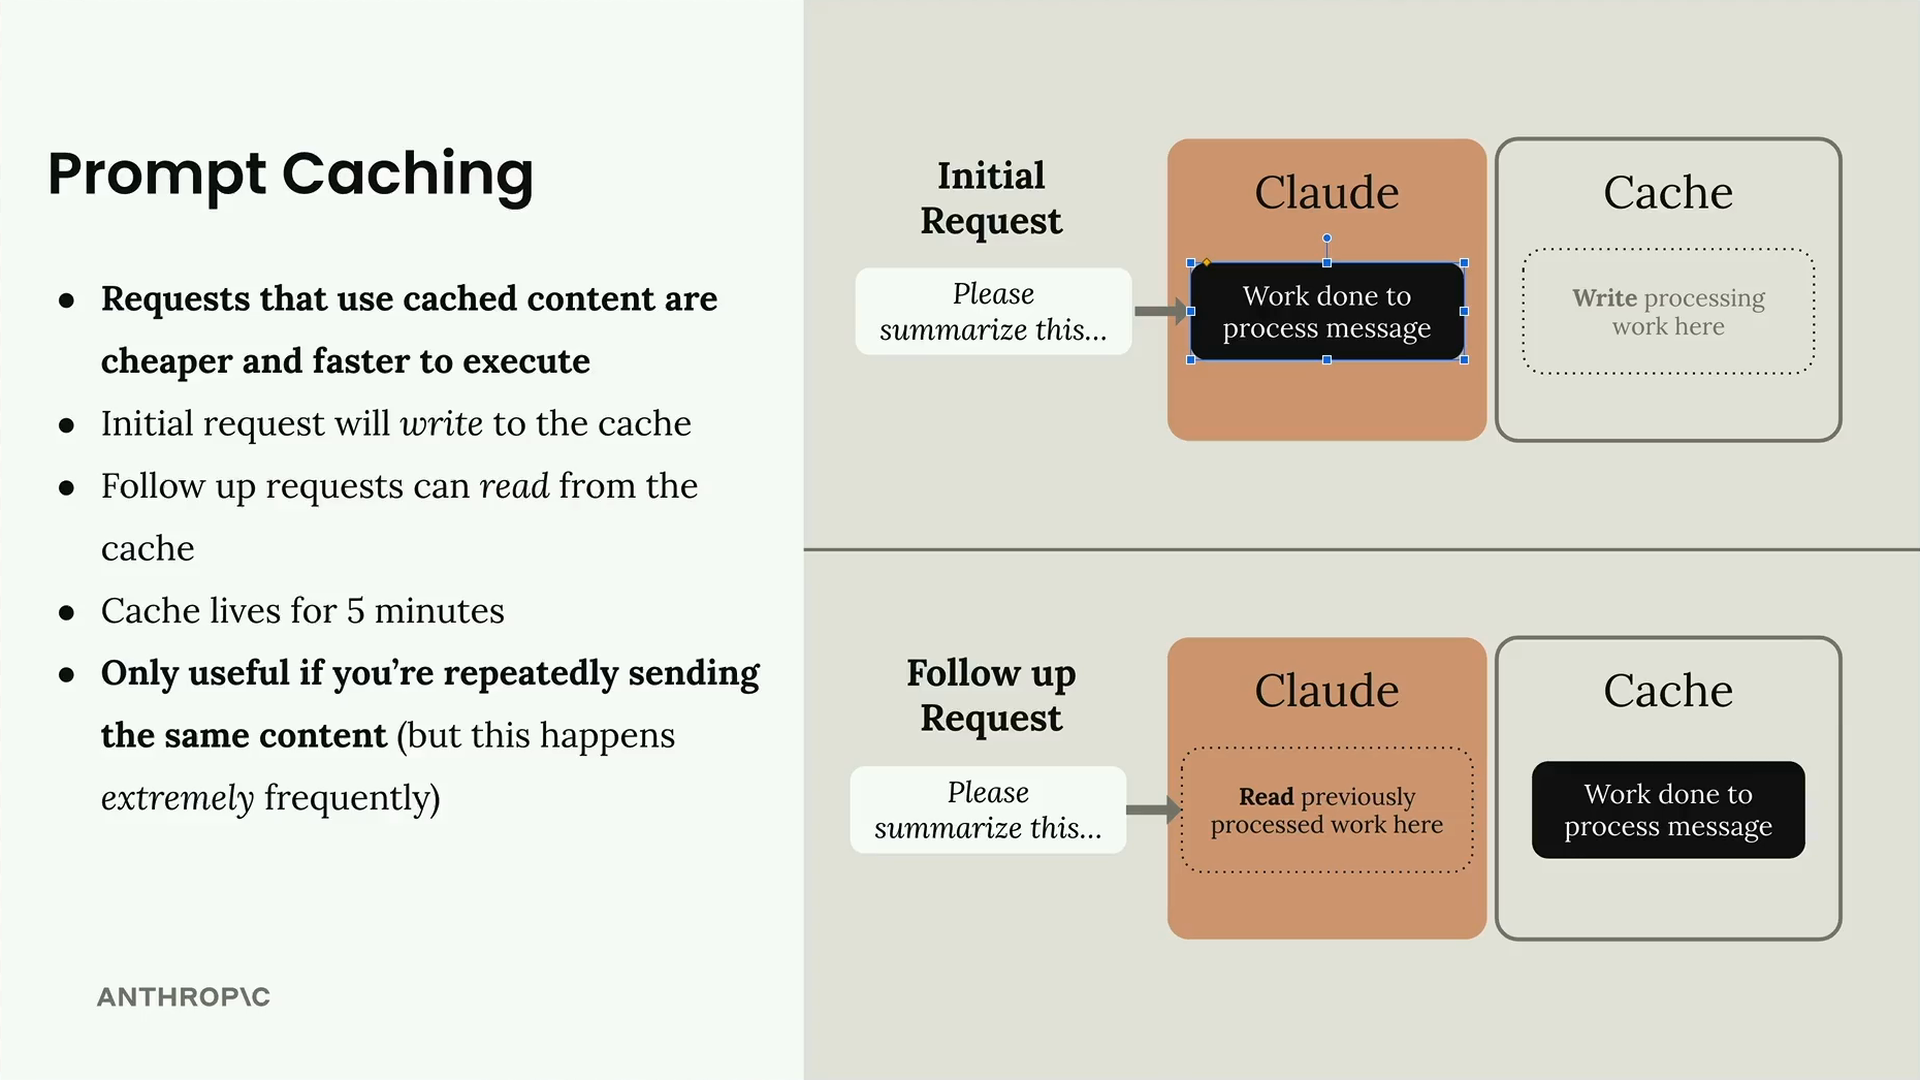
该过程遵循一个简单的模式:您的初始请求会写入缓存,而后续请求可以从缓存中读取。缓存的有效期为5分钟,因此此功能仅在您重复发送相同内容时才有用——但这种情况在实际应用中极为常见。
缓存断点
对消息所做的工作不会自动缓存。我们必须手动向某个区块添加"缓存断点(cache breakpoint)"。断点之前的所有工作都会被缓存,并且只有当断点之前(含断点)的内容完全相同时,后续请求才会使用该缓存。
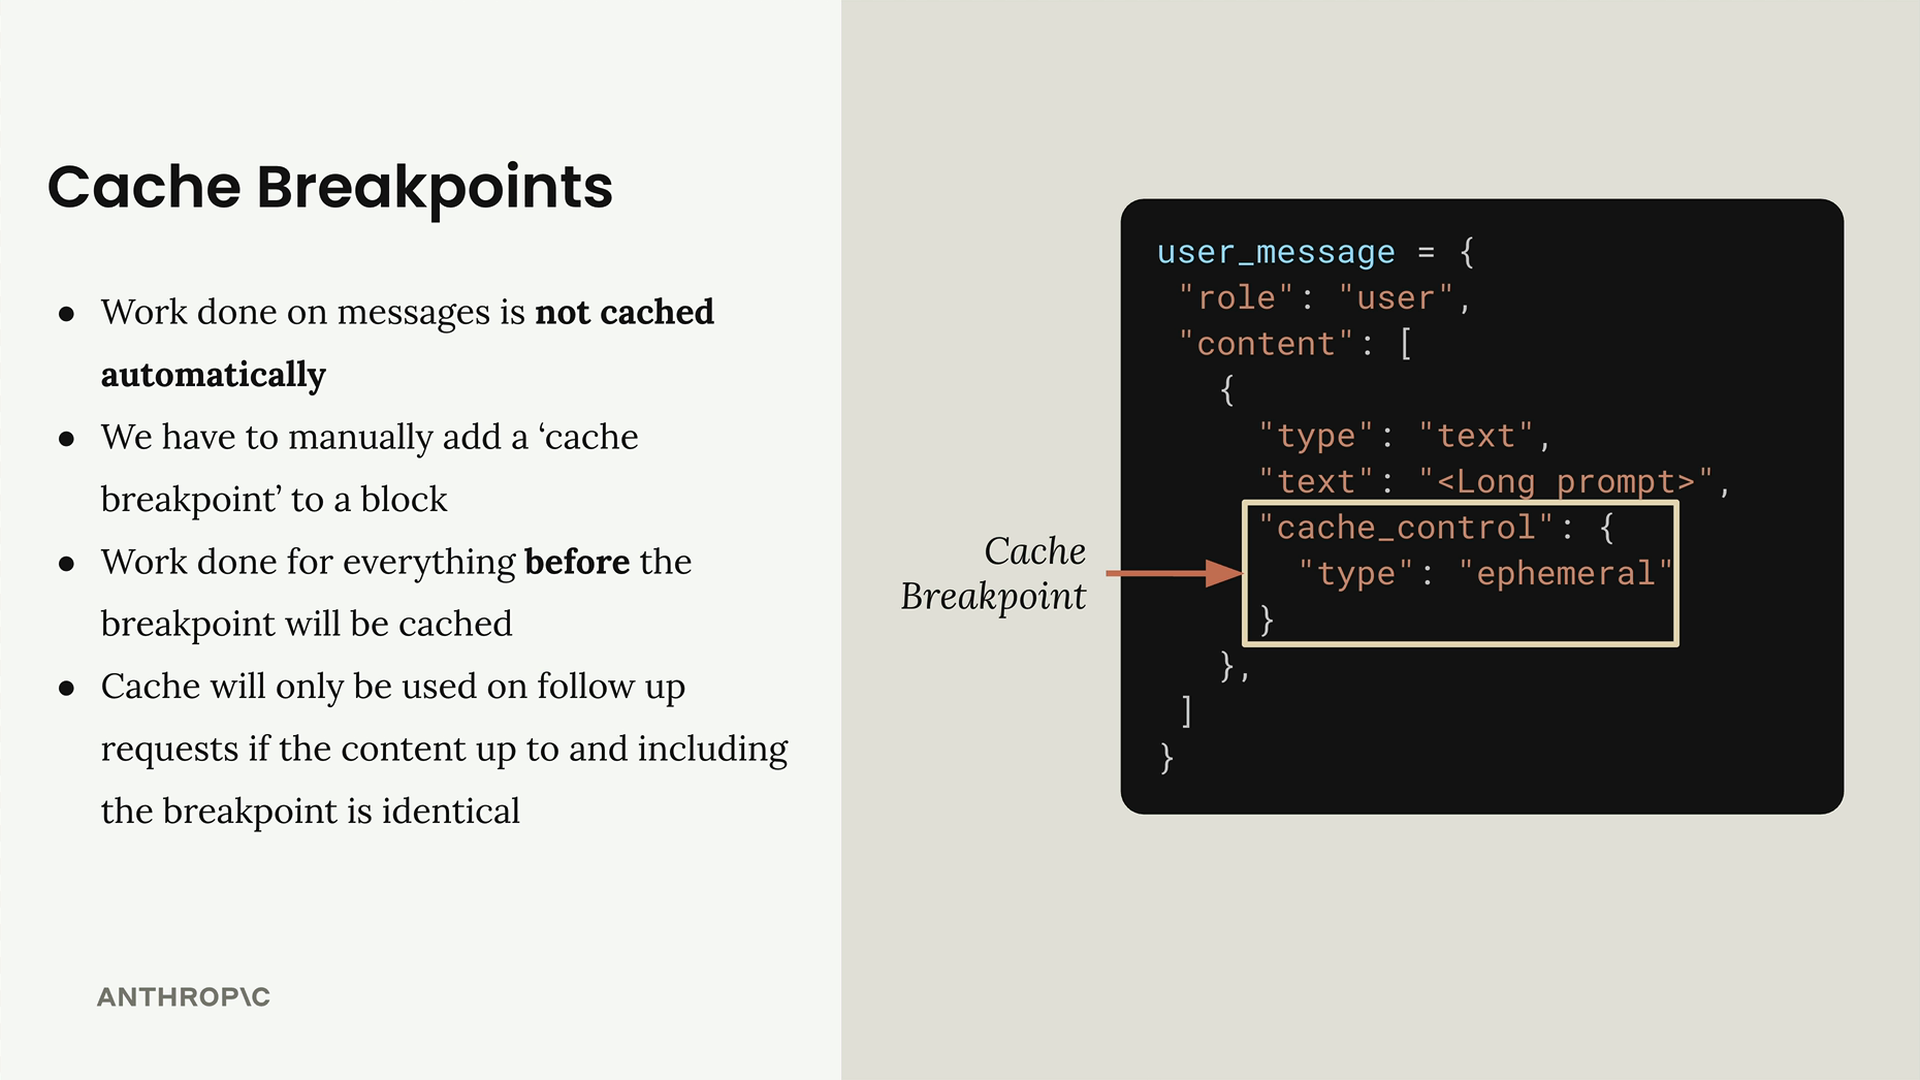
当您需要添加缓存断点时,必须使用完整形式来编写文本块,而不能使用简写形式。以下是两者的区别:
# 简写形式——无法添加缓存断点
user_message = {
  "role": "user",
  "content": "Hi there!"
}

# 完整形式——缓存断点必需使用
user_message = {
  "role": "user",
  "content": [
    {
      "type": "text",
      "text": "Hi there!",
      "cache_control": {
        "type": "ephemeral"
      }
    }
  ]
}
缓存断点的工作原理
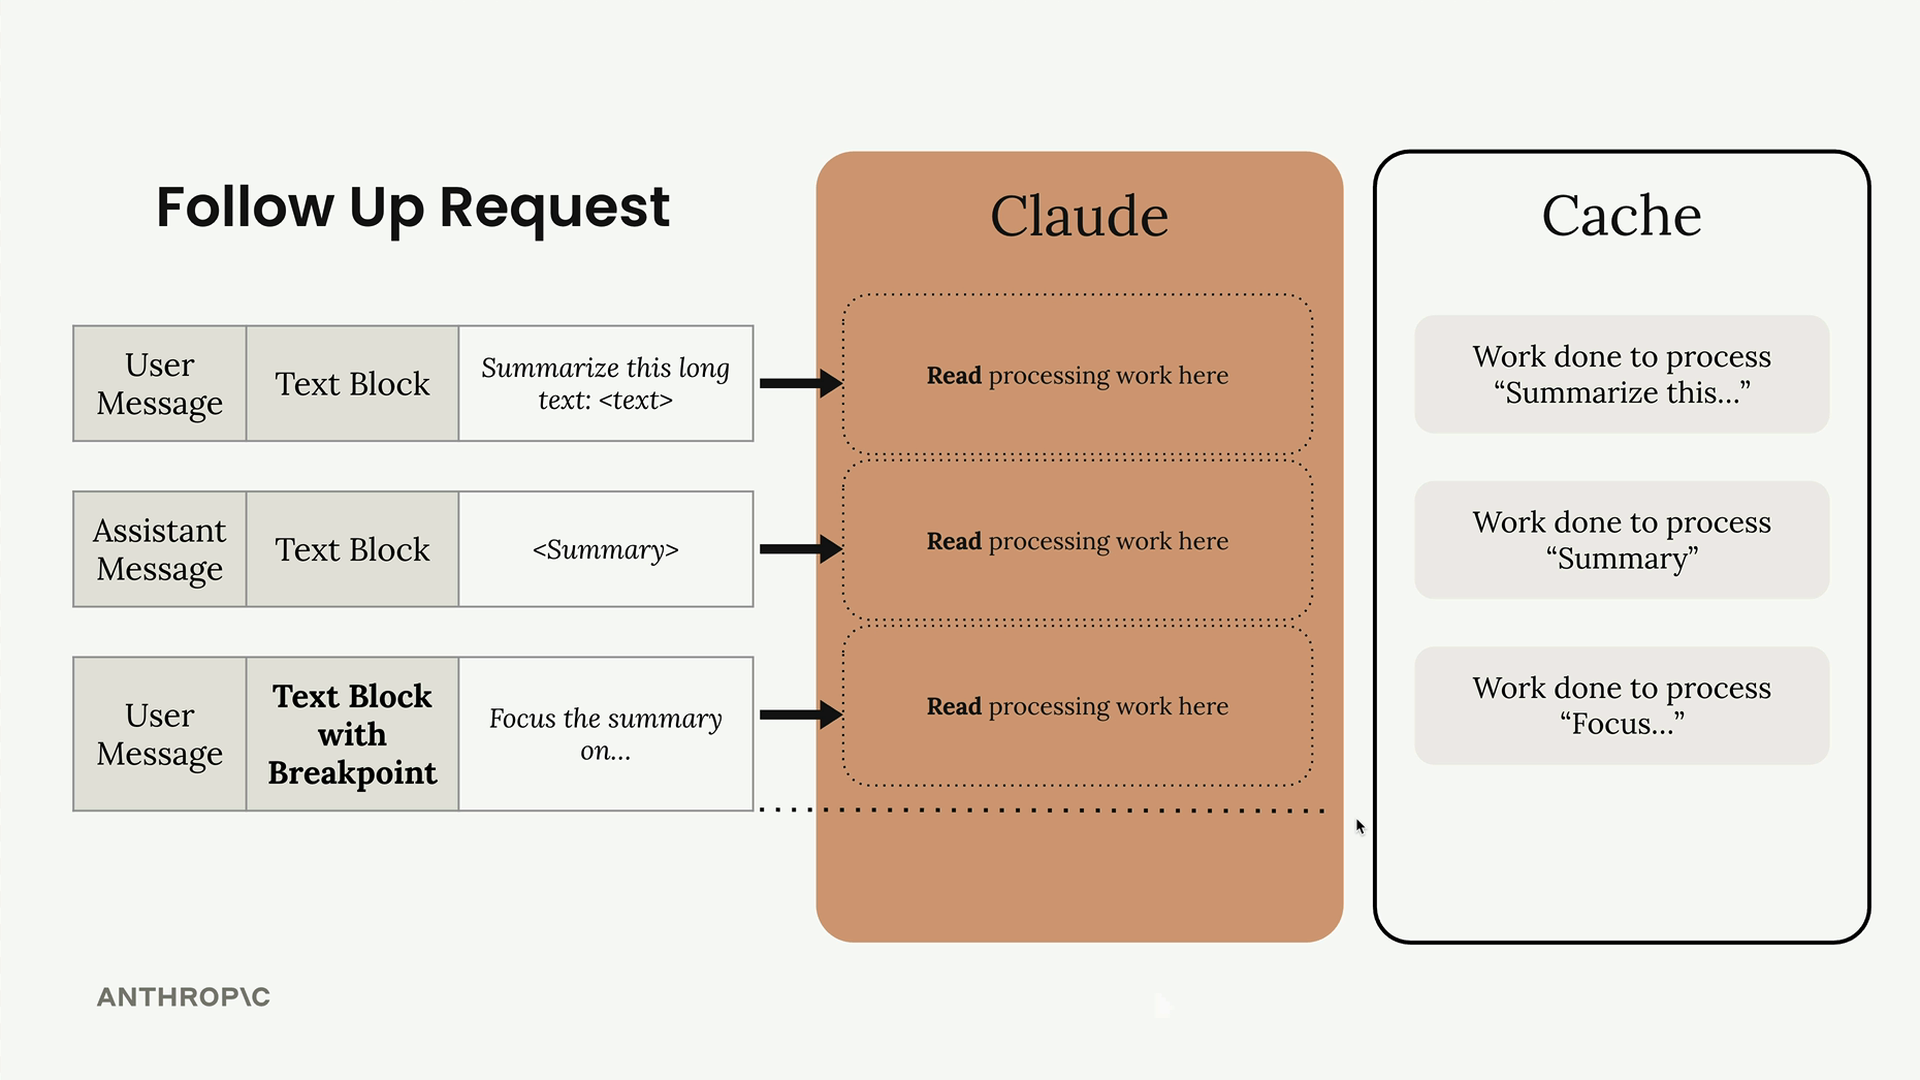
缓存断点可以跨越多条消息,也可以缓存助手(assistant)消息。当您放置一个断点时,该断点之前的所有内容都会被缓存。请记住,内容必须完全相同才能使用缓存!
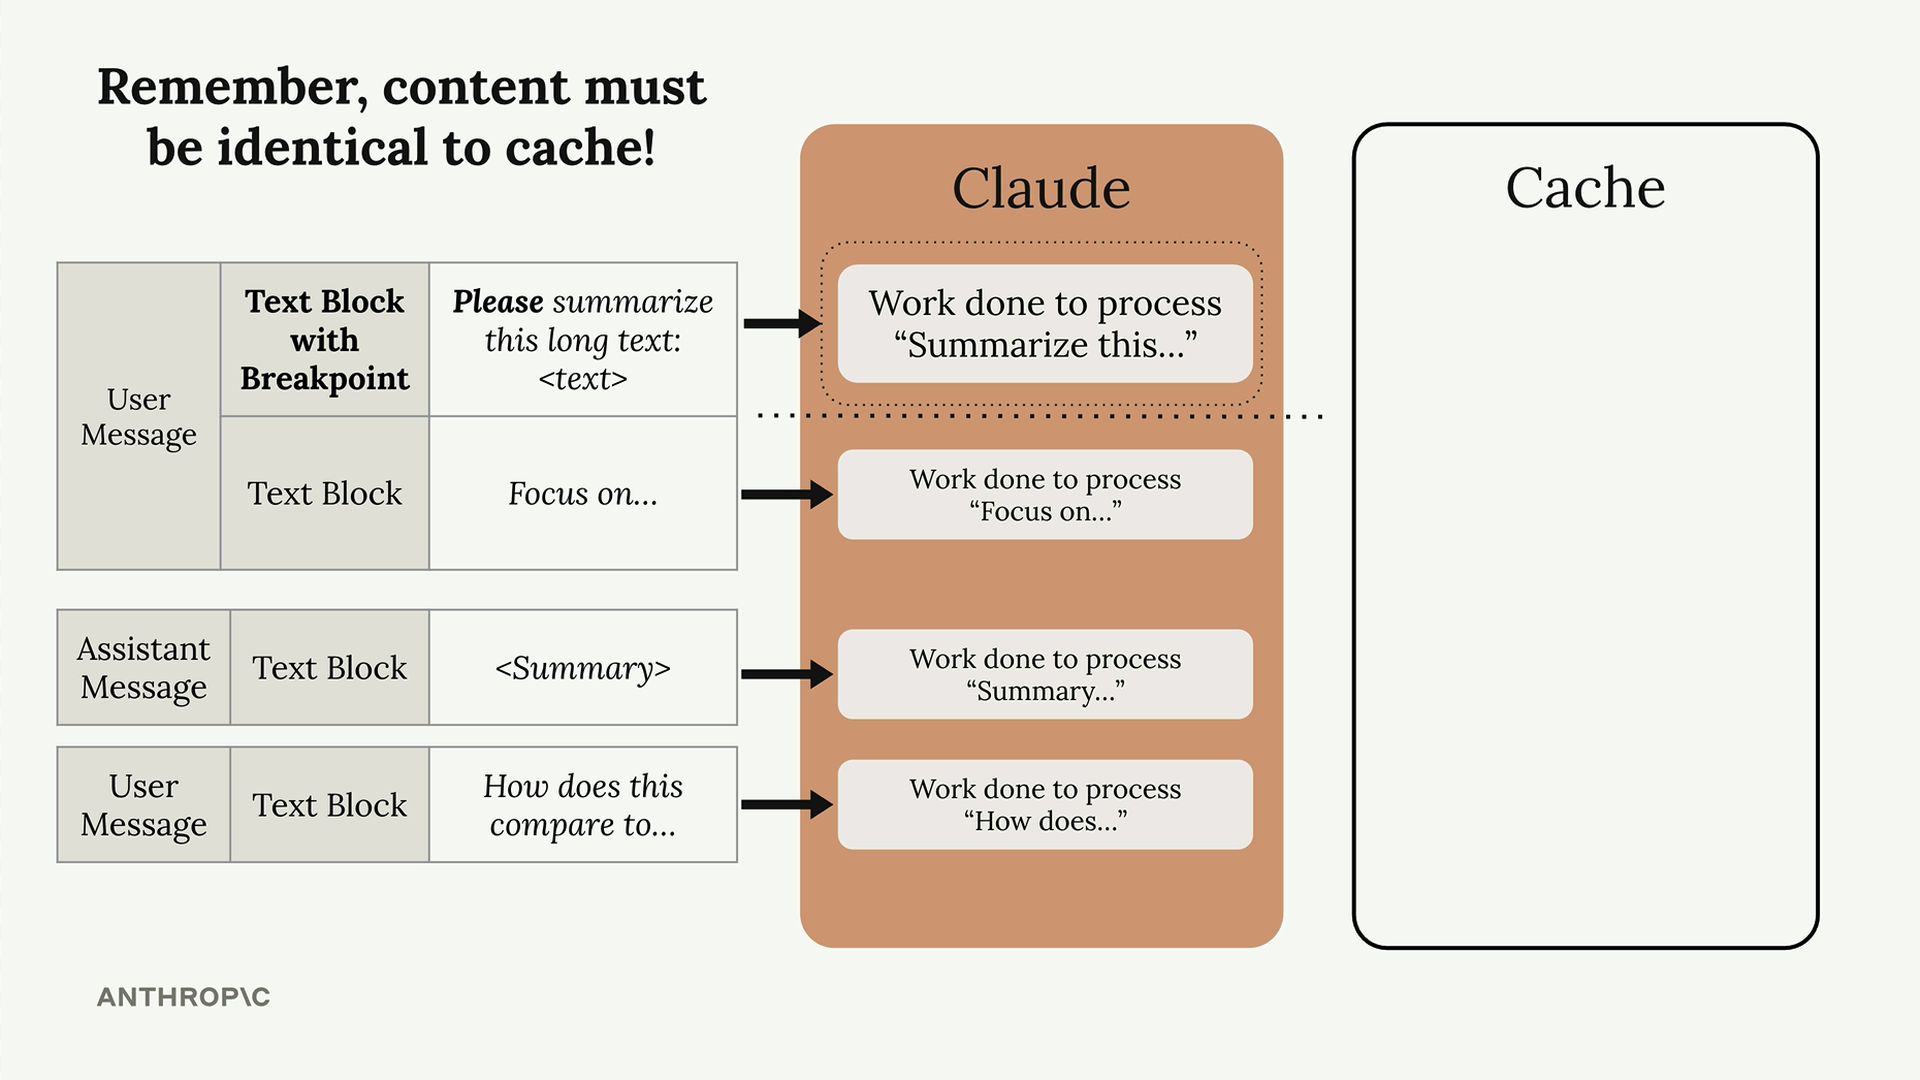
在后续请求中,Claude会从缓存中读取先前处理过的工作,而不是重新处理它:
断点位置
您并不局限于文本块!您可以在系统提示和工具定义中添加缓存断点。事实上,这些正是最常见的缓存机会,因为它们在请求之间很少发生变化。
# 带缓存断点的工具定义
tools = [
  add_duration_to_datetime_schema,
  get_current_datetime_schema,
  {
    "name": "set_reminder",
    "description": "Sets a reminder...",
    "input_schema": { ... },
    "cache_control": {"type": "ephemeral"}
  }
]

# 带缓存断点的系统提示
system = [
  {
    "type": "text",
    "text": "You are a senior software...",
    "cache_control": {"type": "ephemeral"}
  }
]
缓存排序
在后台,工具、系统提示和消息在输入Claude时会按特定顺序拼接在一起。这会影响缓存断点的工作方式。
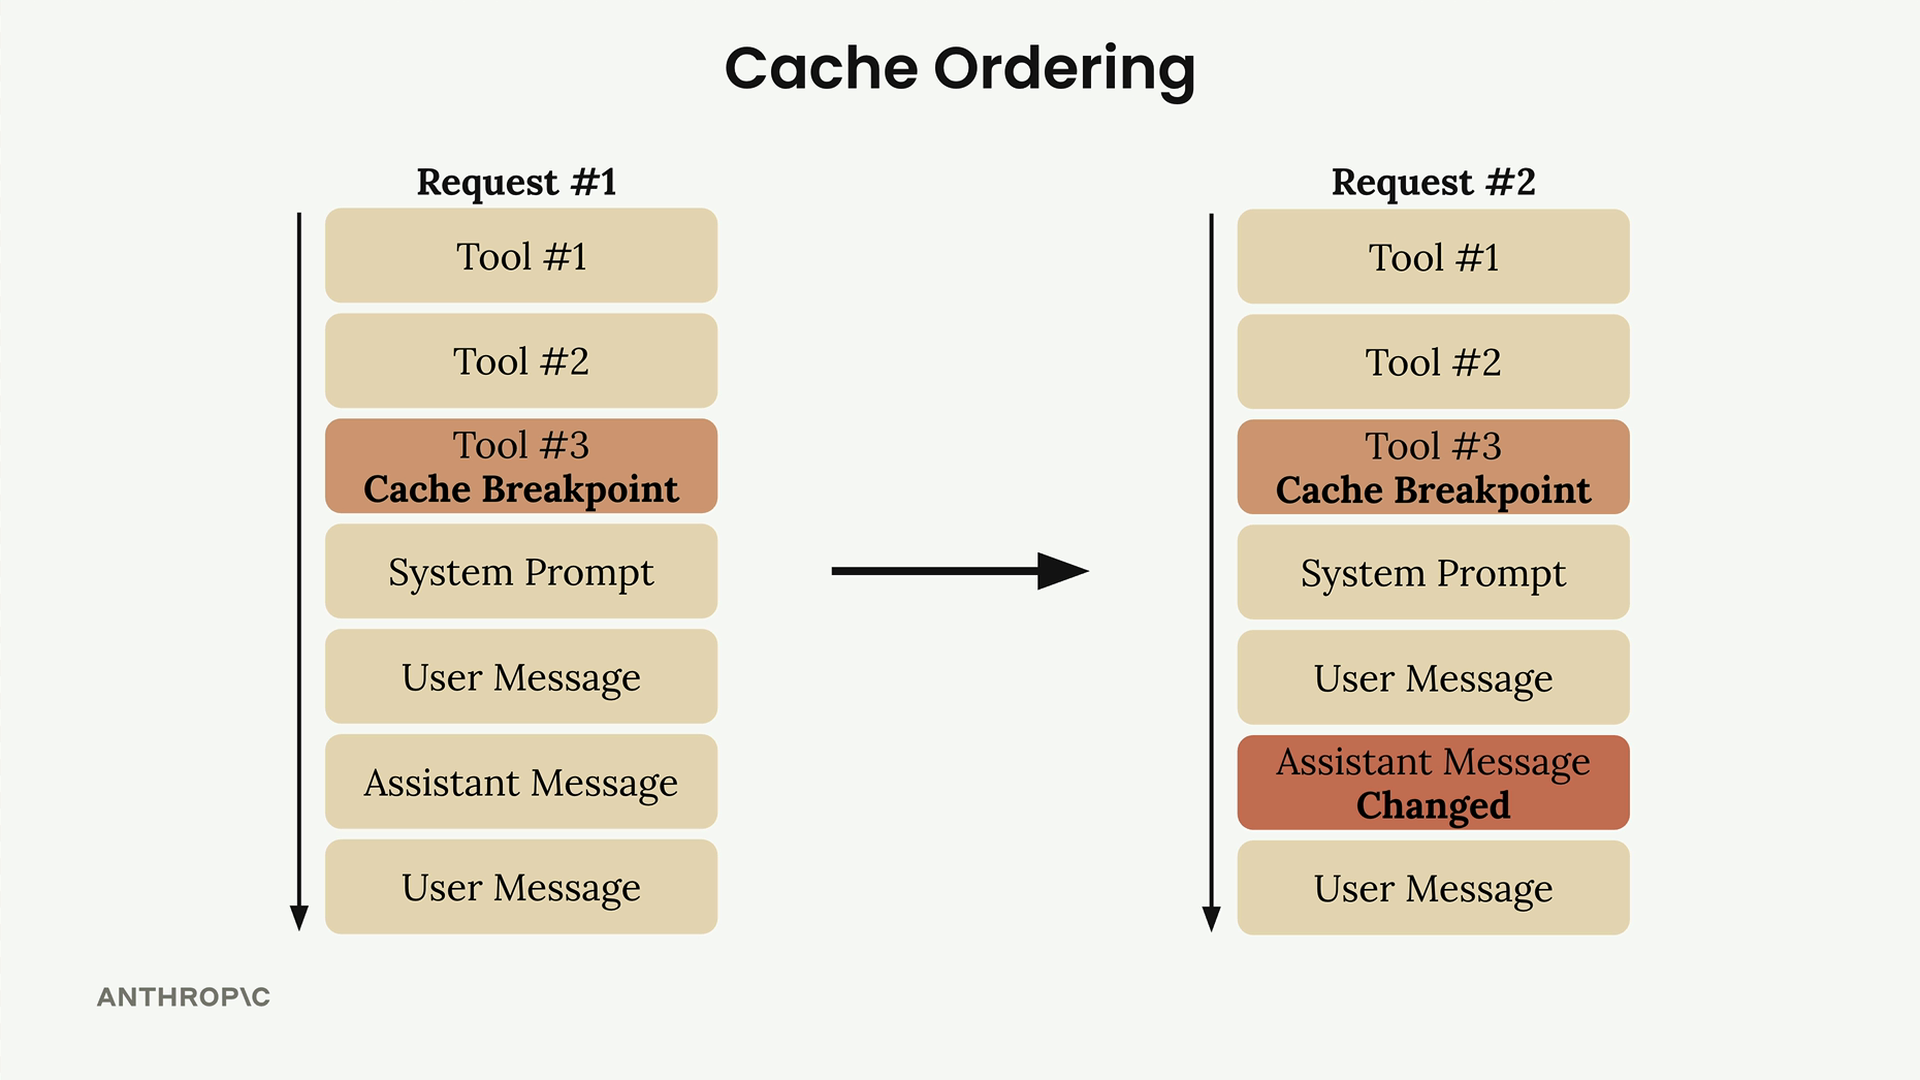
您总共最多可以添加四个缓存断点。如果您在最后一个工具上放置断点,则该工具之前的所有内容都会被缓存,但系统提示和消息不会被缓存。这使您可以根据应用程序中发生变化的内容,对缓存内容进行精细控制。
最小内容长度
缓存存在一个最小长度限制,该限制取决于模型。对于本课程使用的Claude Haiku 4.5模型而言,内容必须至少有4,096个令牌才能被缓存。这是您试图缓存的所有消息和区块的总和,而不是单个区块的长度。
像"Hi there!"这样的消息太短,无法被缓存,但一个真正冗长的提示则能达到最小长度。低于最小长度的内容只会被正常处理而不进行缓存,并且不会返回任何错误。要判断是否发生了缓存,请查看响应的用量信息:cache_creation_input_tokens和cache_read_input_tokens都将为0。
有效使用提示缓存的关键在于识别请求中保持一致的部分——通常是您的系统提示和工具定义——并战略性地放置断点,以最大化缓存命中率,同时最小化重新处理的工作量。