文本分块是构建 RAG(检索增强生成)管道中最关键的步骤之一。您如何拆分文档直接影响整个系统的质量。糟糕的分块策略会导致不相关的上下文被插入到您的提示中,从而使您的 AI 给出完全错误的答案。
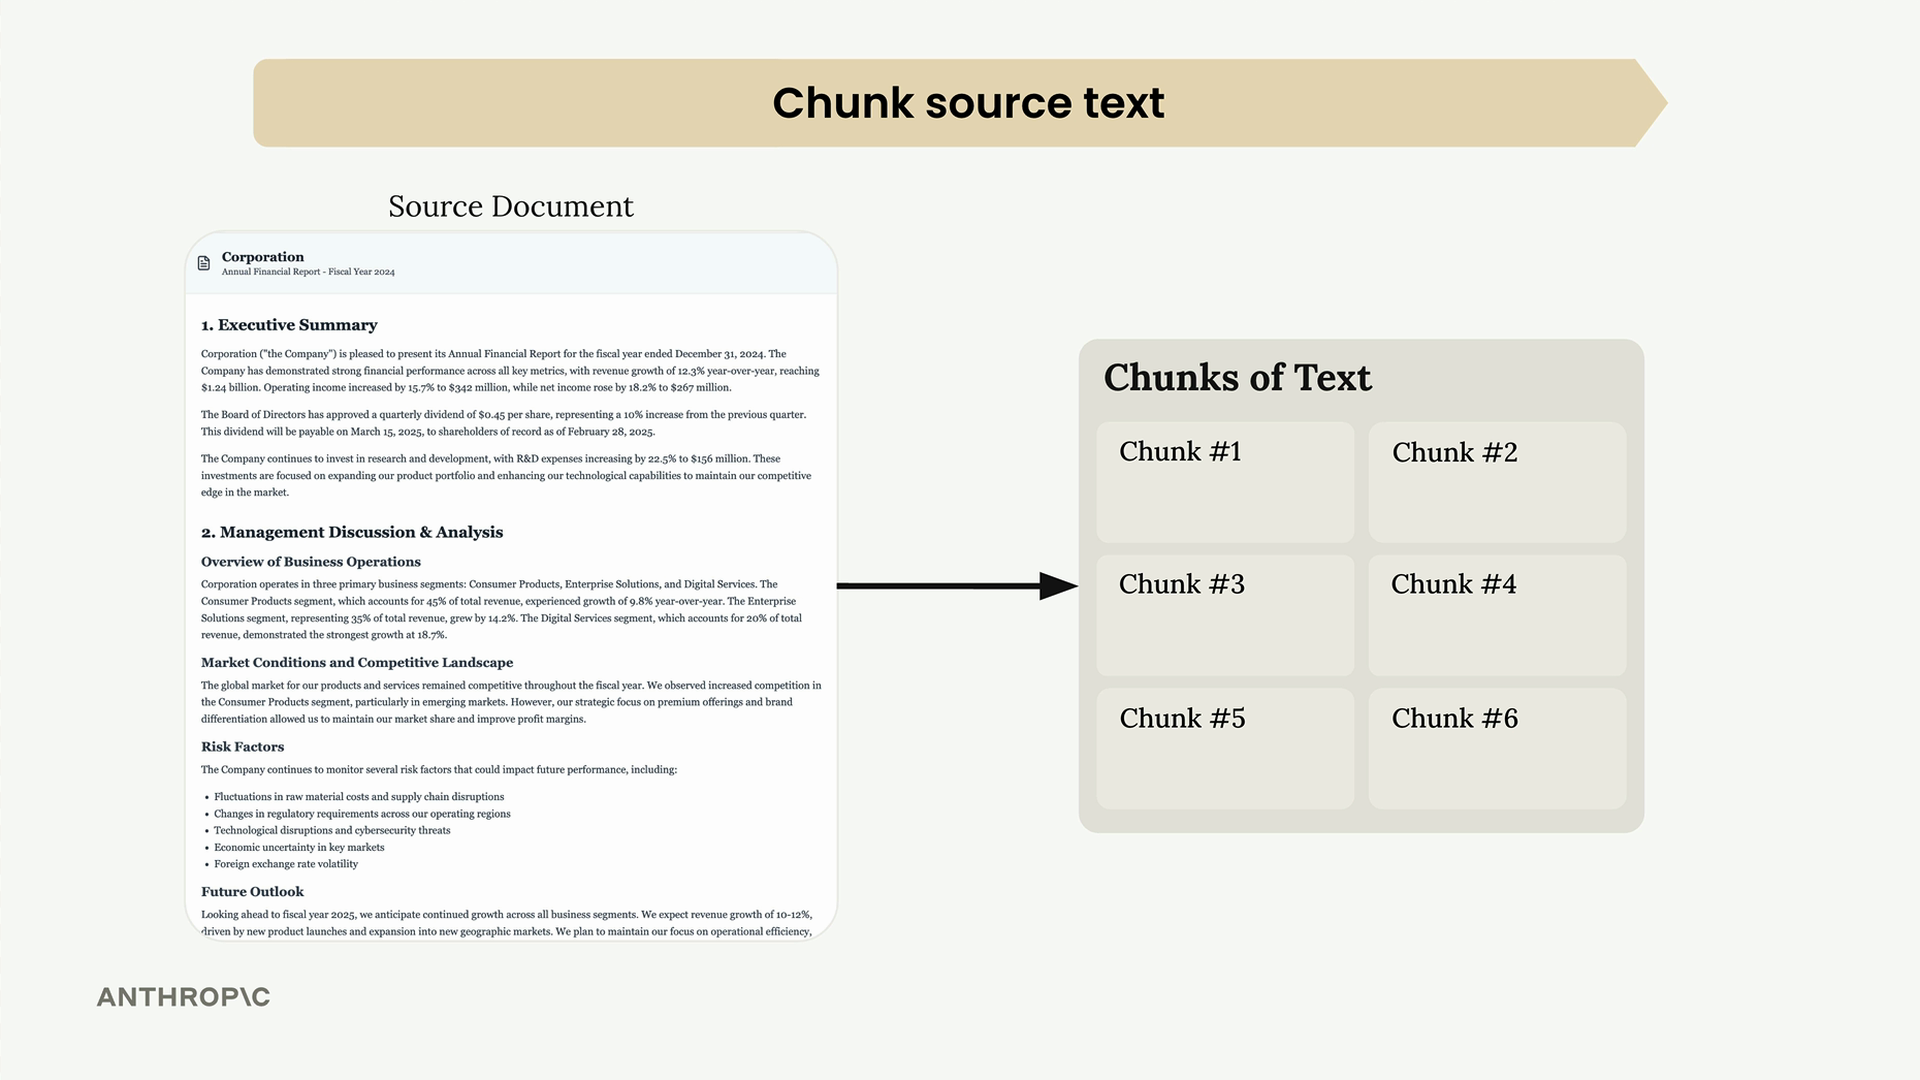
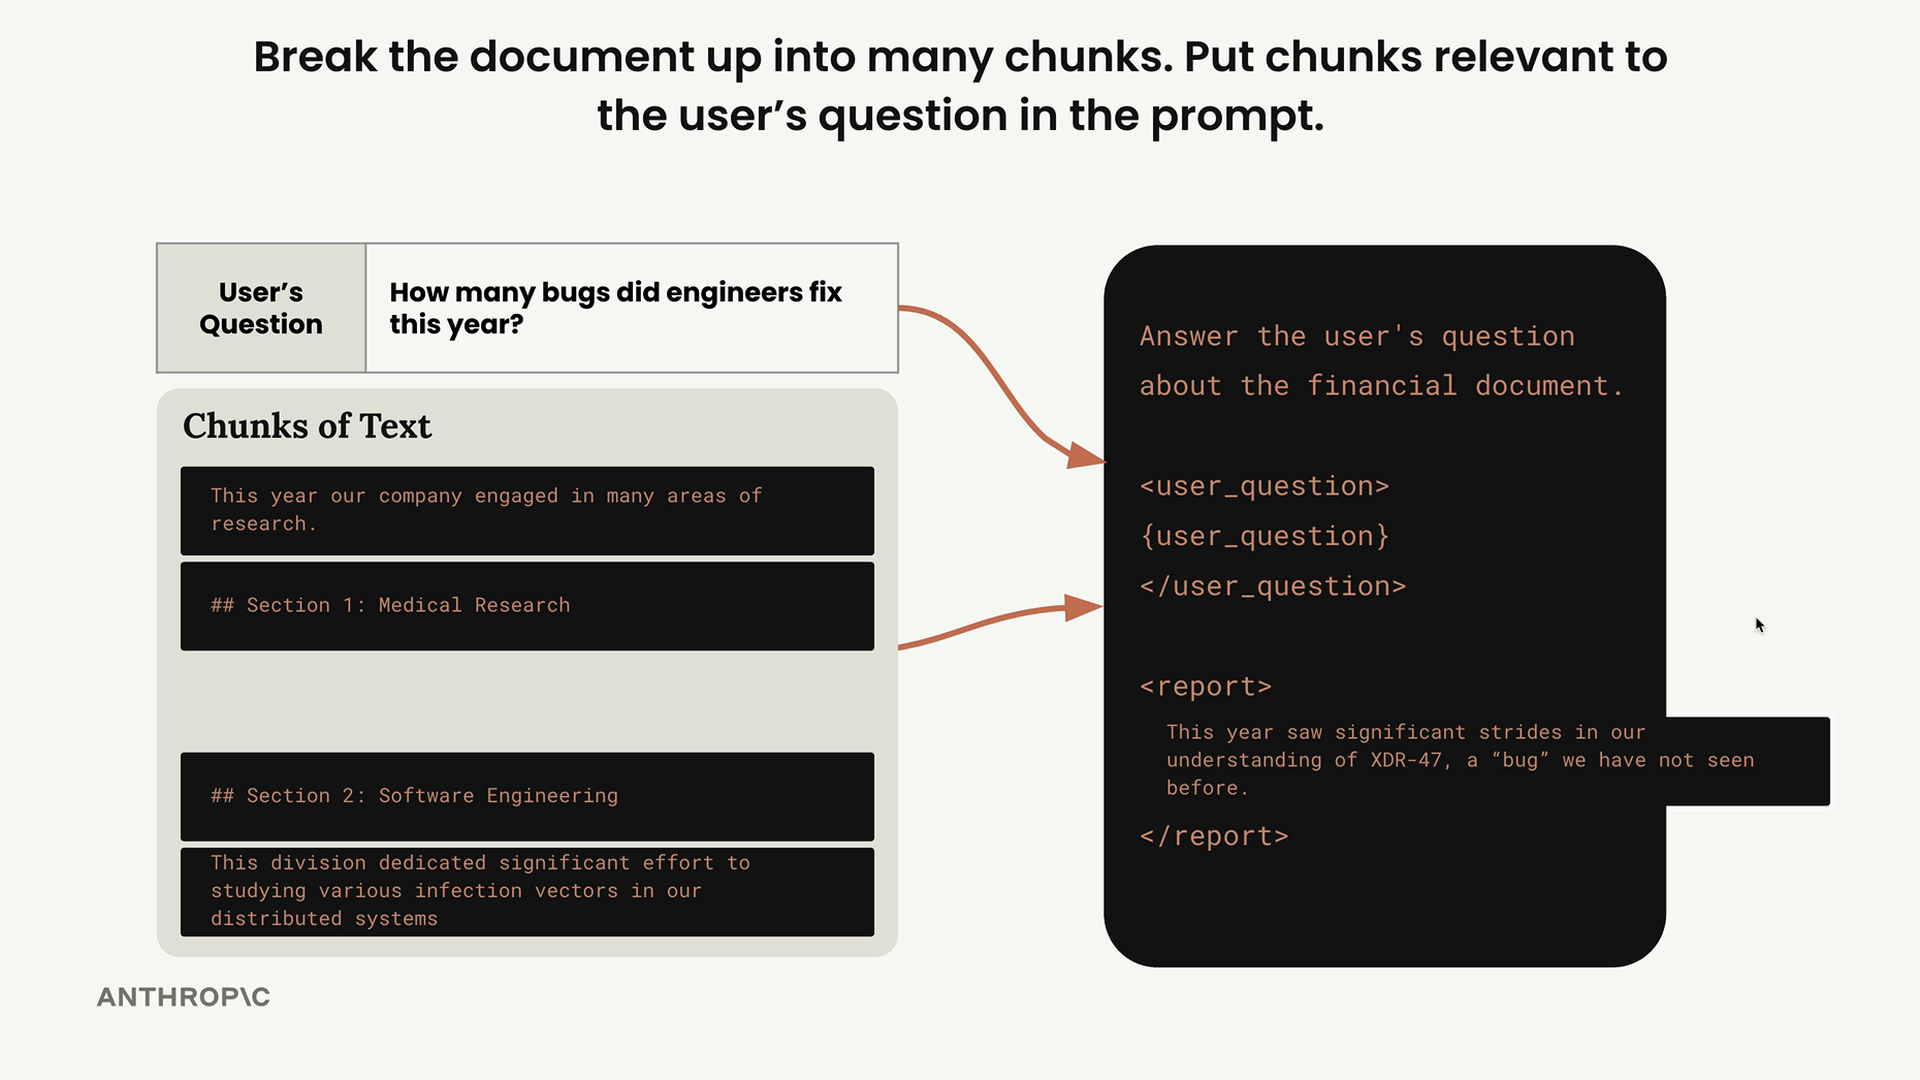
考虑这个例子:您有一份文档,其中包含医学研究和软件工程方面的章节。如果分块不当,用户询问"今年工程师修复了多少个 bug?"可能会得到关于医学研究的信息,而不是软件工程的信息,仅仅因为医学部分恰好在不同的上下文中包含了"bug"这个词。
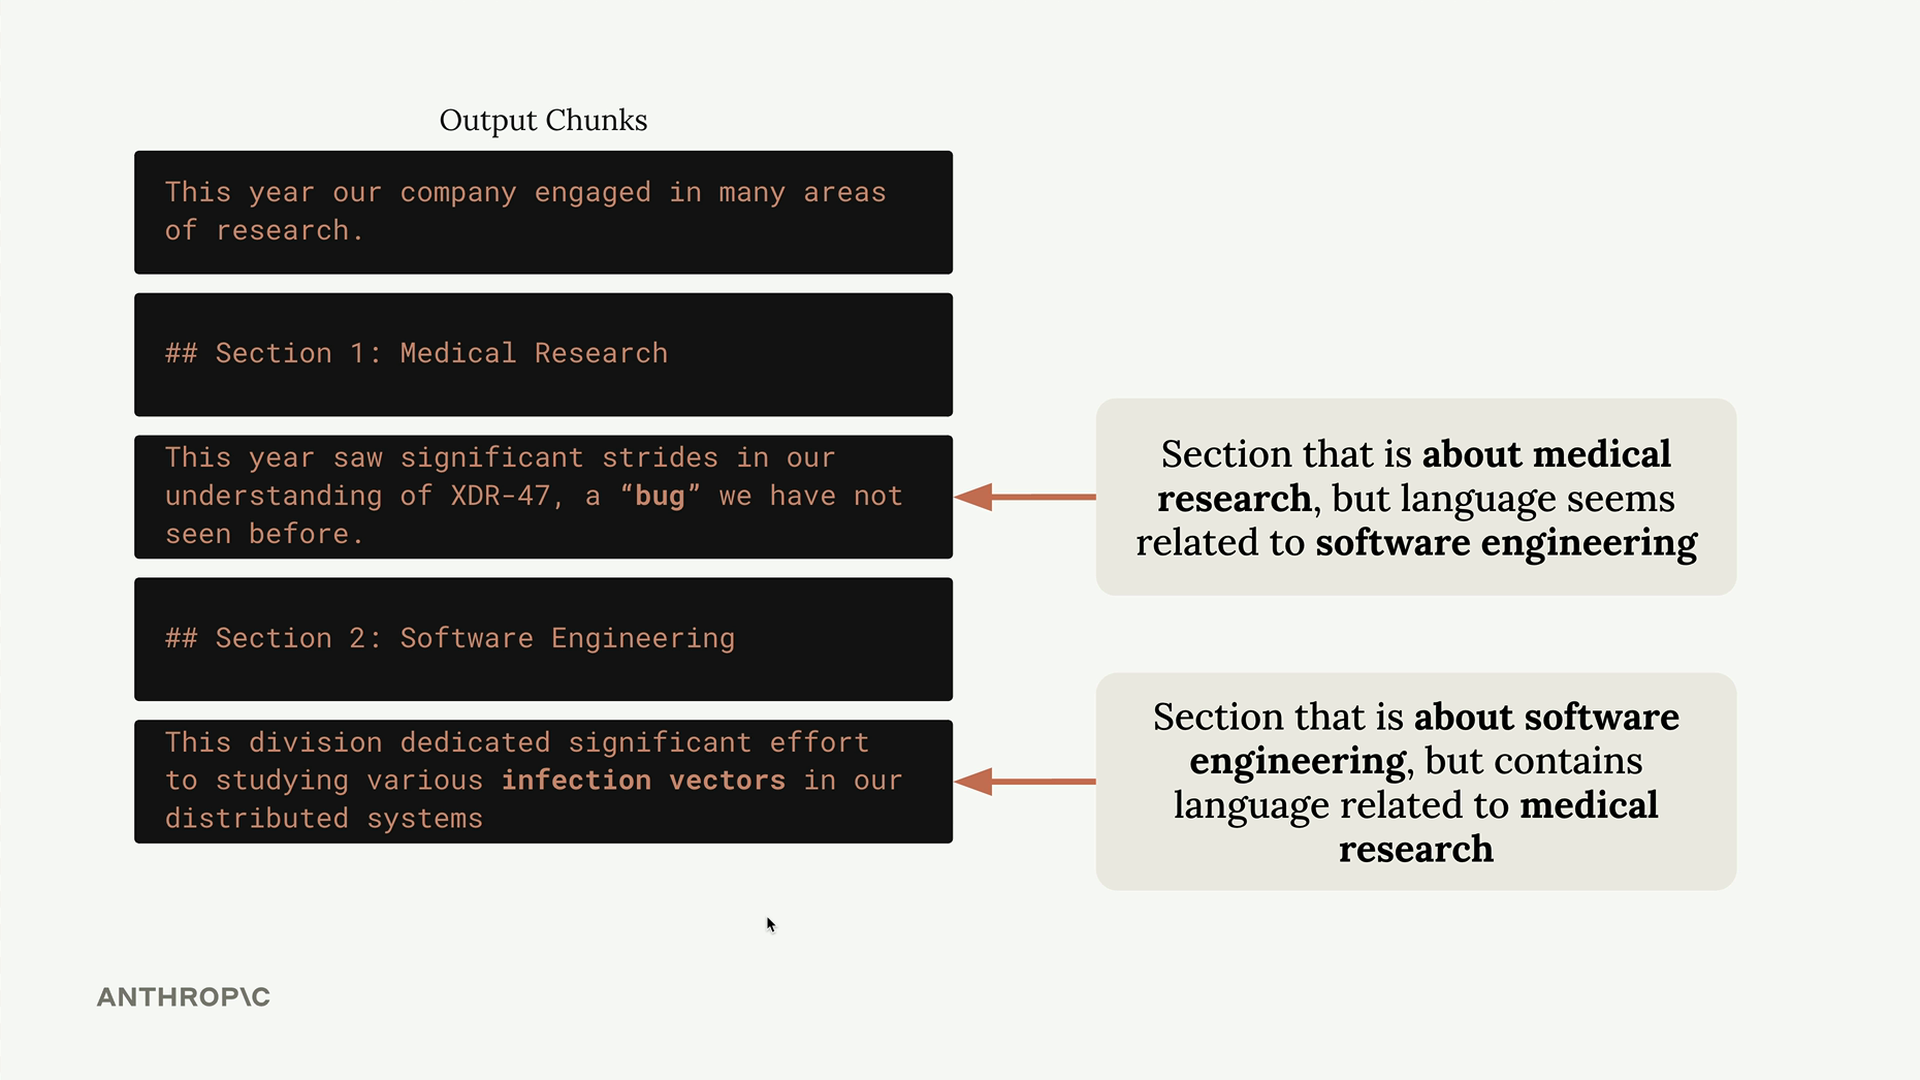
这说明了为什么分块策略如此重要。目标是创建保持语义连贯性的块,并在检索时提供有意义的上下文。
三种主要分块策略
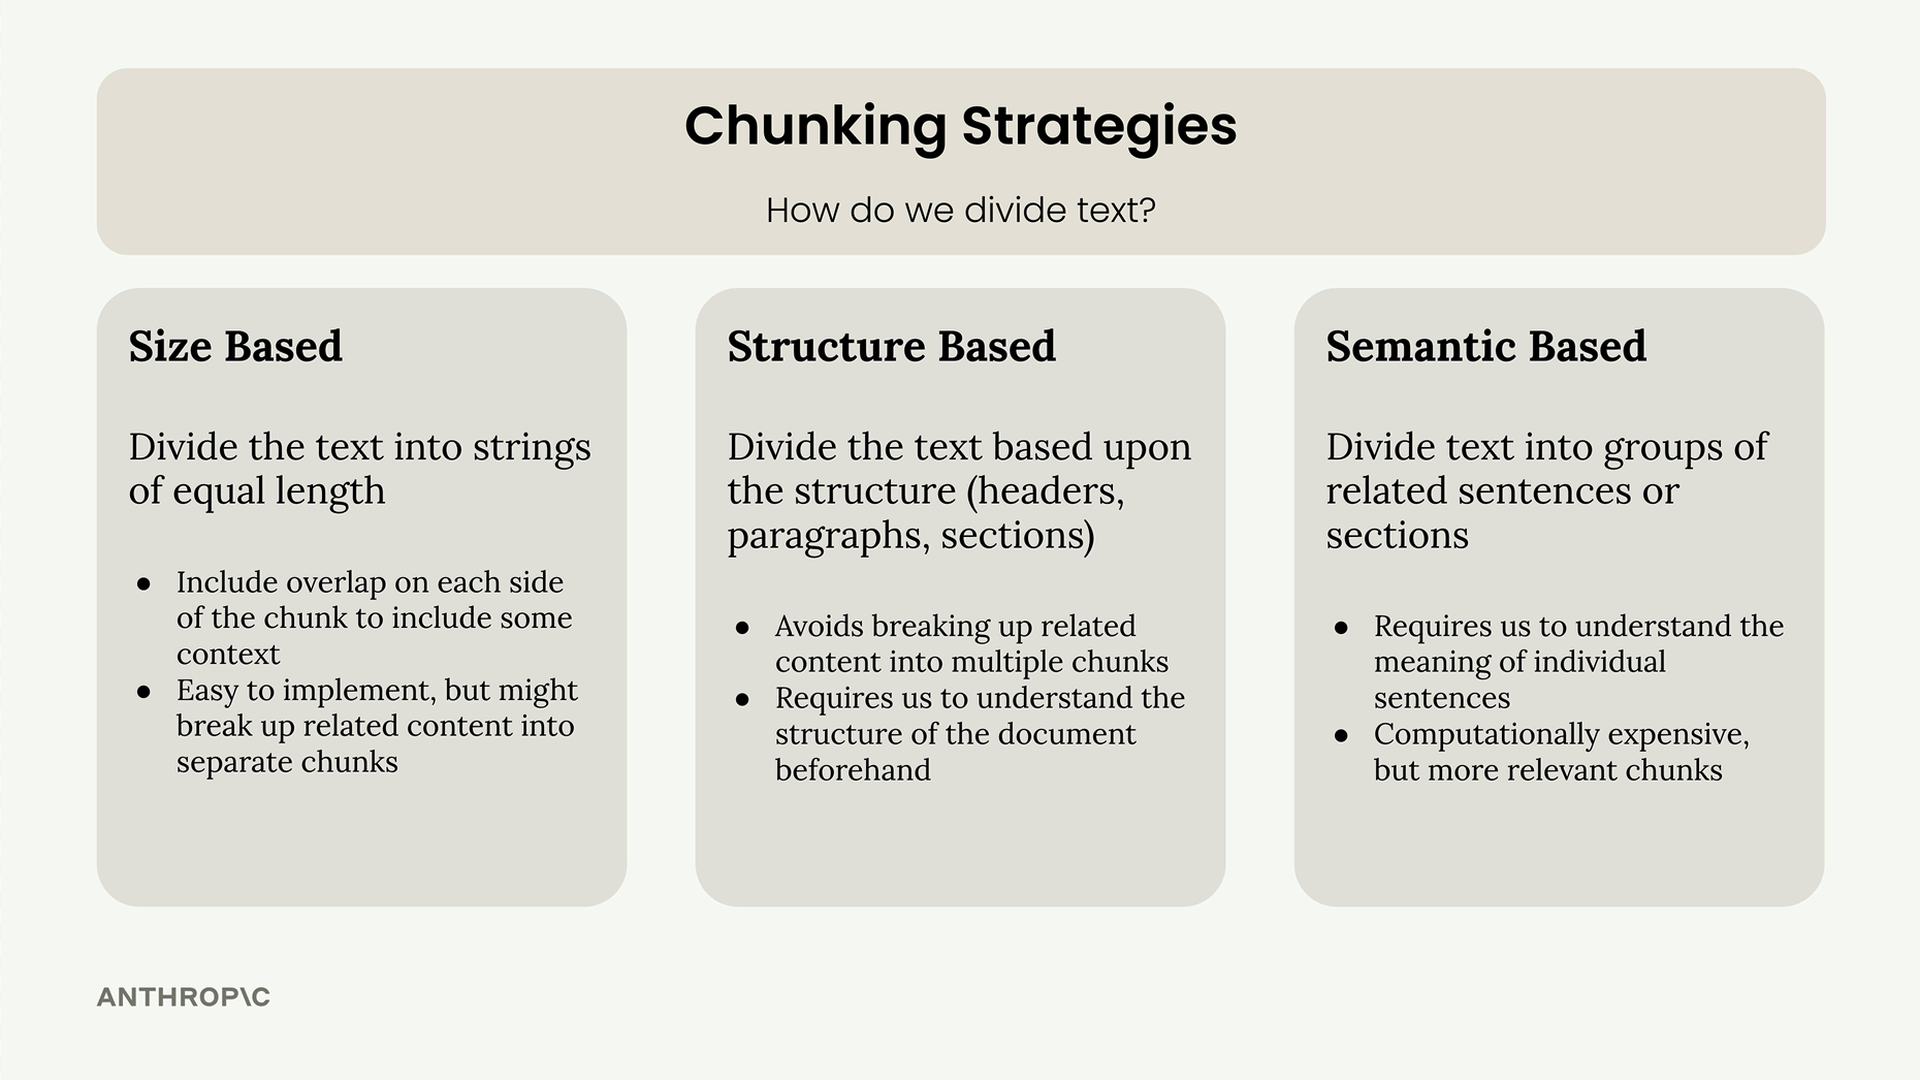
文本分块有三种主要方法,每种方法都有各自的优势和权衡:
- 基于大小: 将文本划分为等长的字符串
- 基于结构: 根据文档结构(标题、段落、章节)进行拆分
- 基于语义: 使用 NLP 技术将相关句子或章节分组
基于大小的分块
基于大小的分块是最直接的方法。您只需将文档划分为字符数或单词数大致相等的块。它易于实现,并且在不同文档类型中都能可靠地工作。
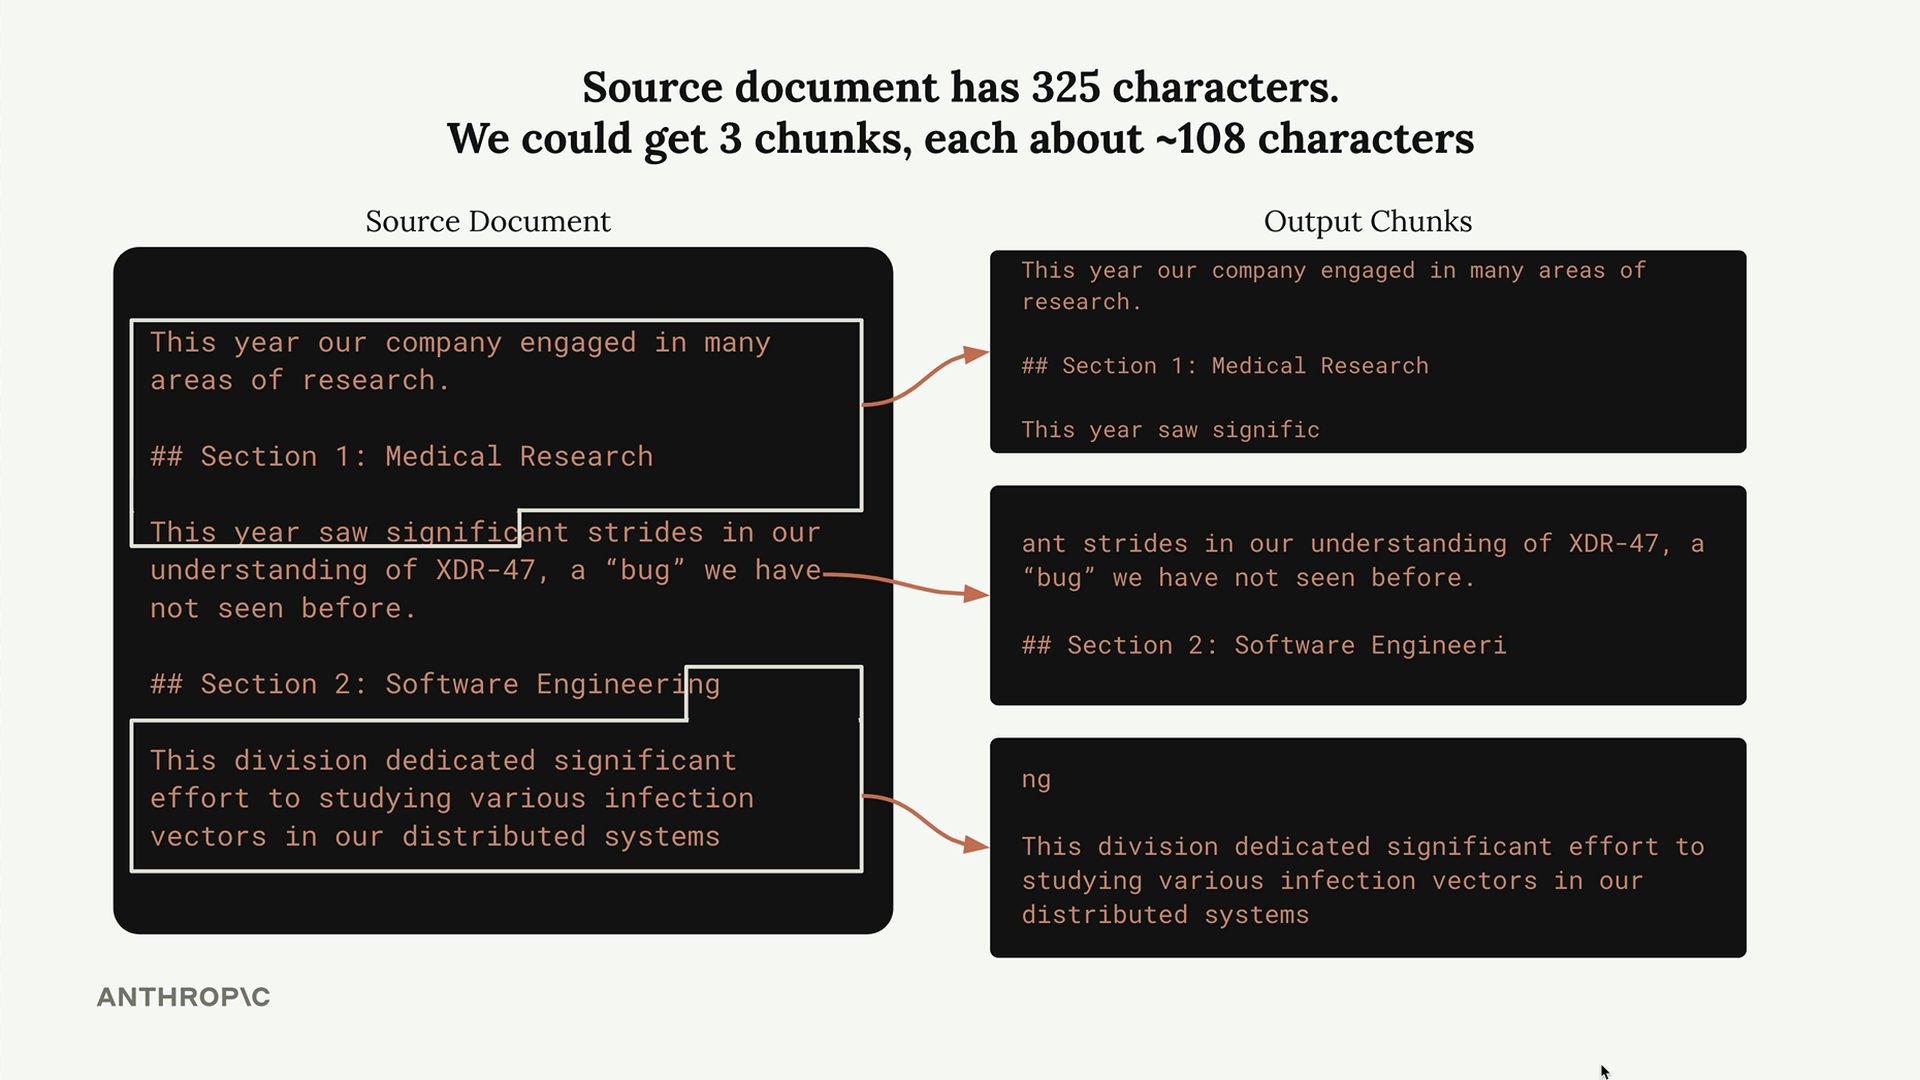
然而,这种方法有明显的缺点。单词会在句子中间被截断,块会丢失重要的上下文。例如,一个块可能不包含能够解释内容实际含义的章节标题。
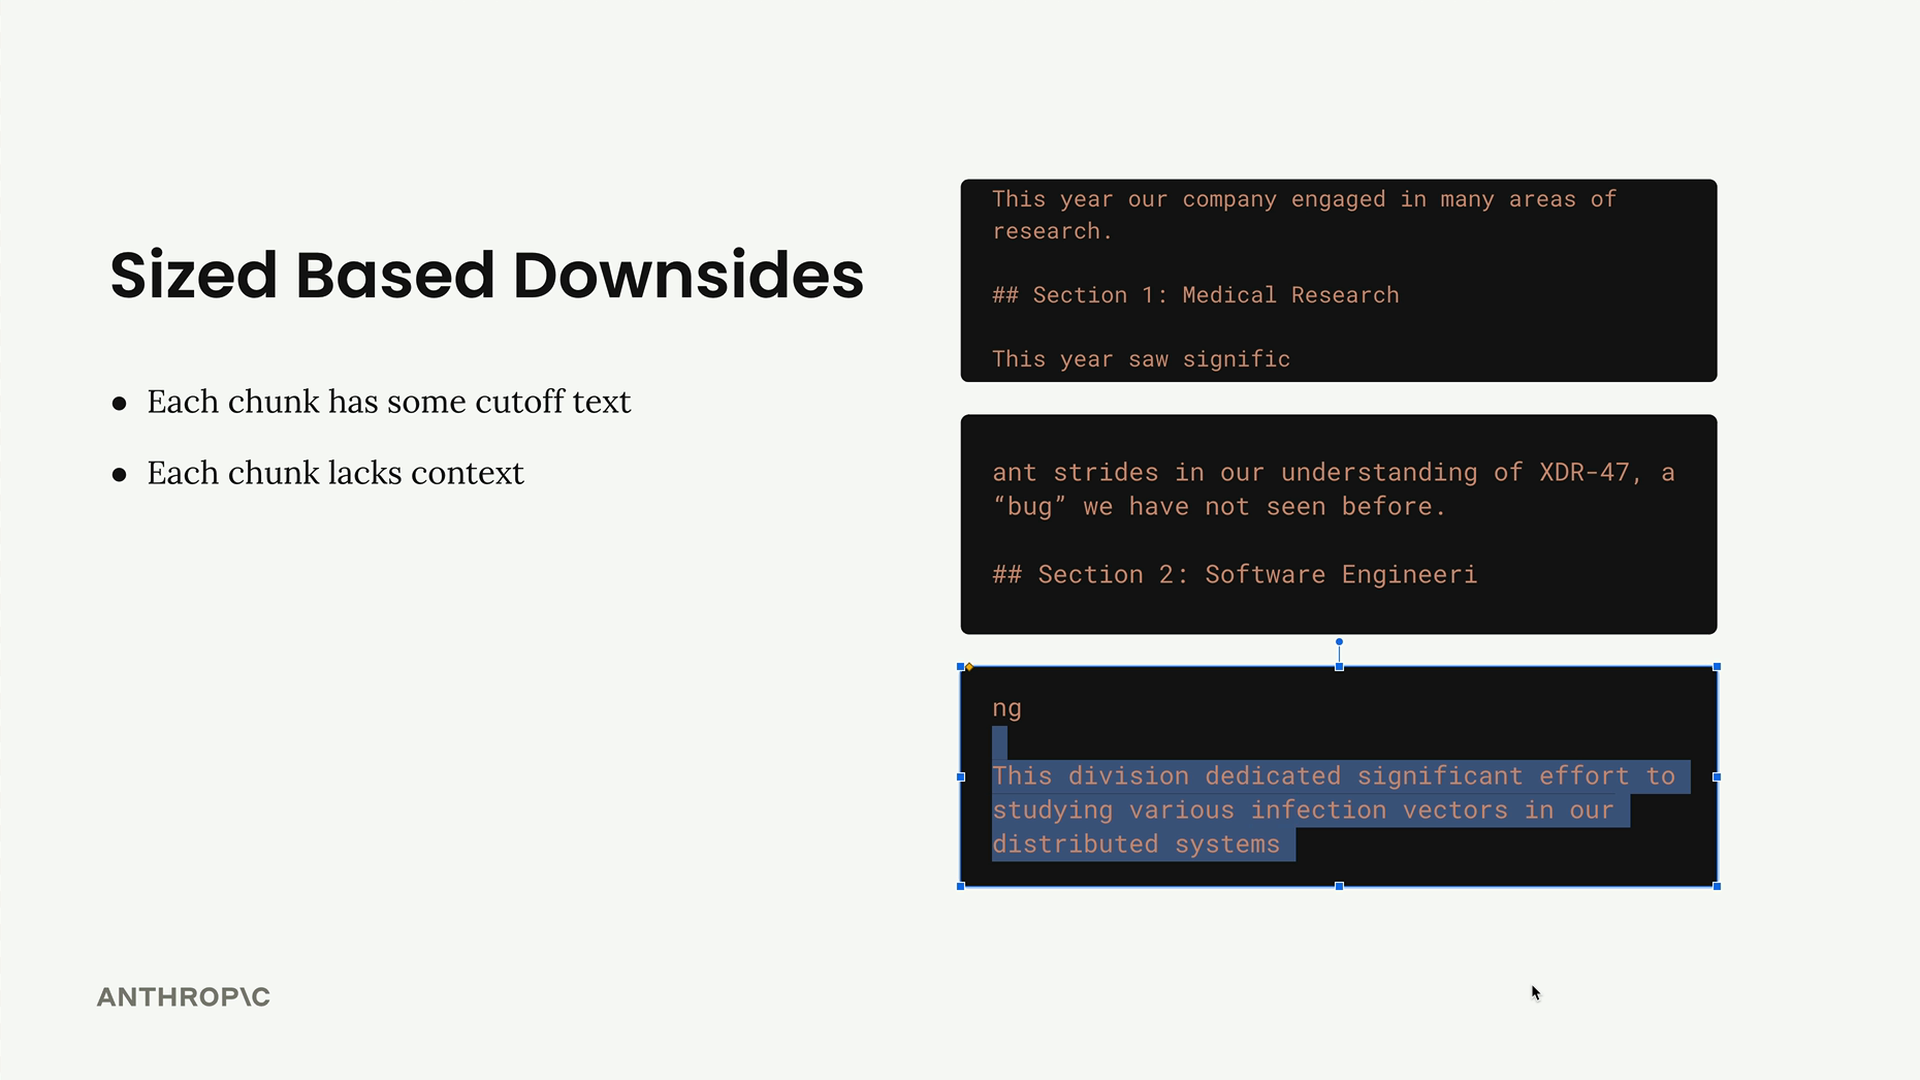
解决方案是在块之间添加重叠部分。每个块都包含来自相邻块的一些字符,从而确保更好地保留上下文并避免突然截断。
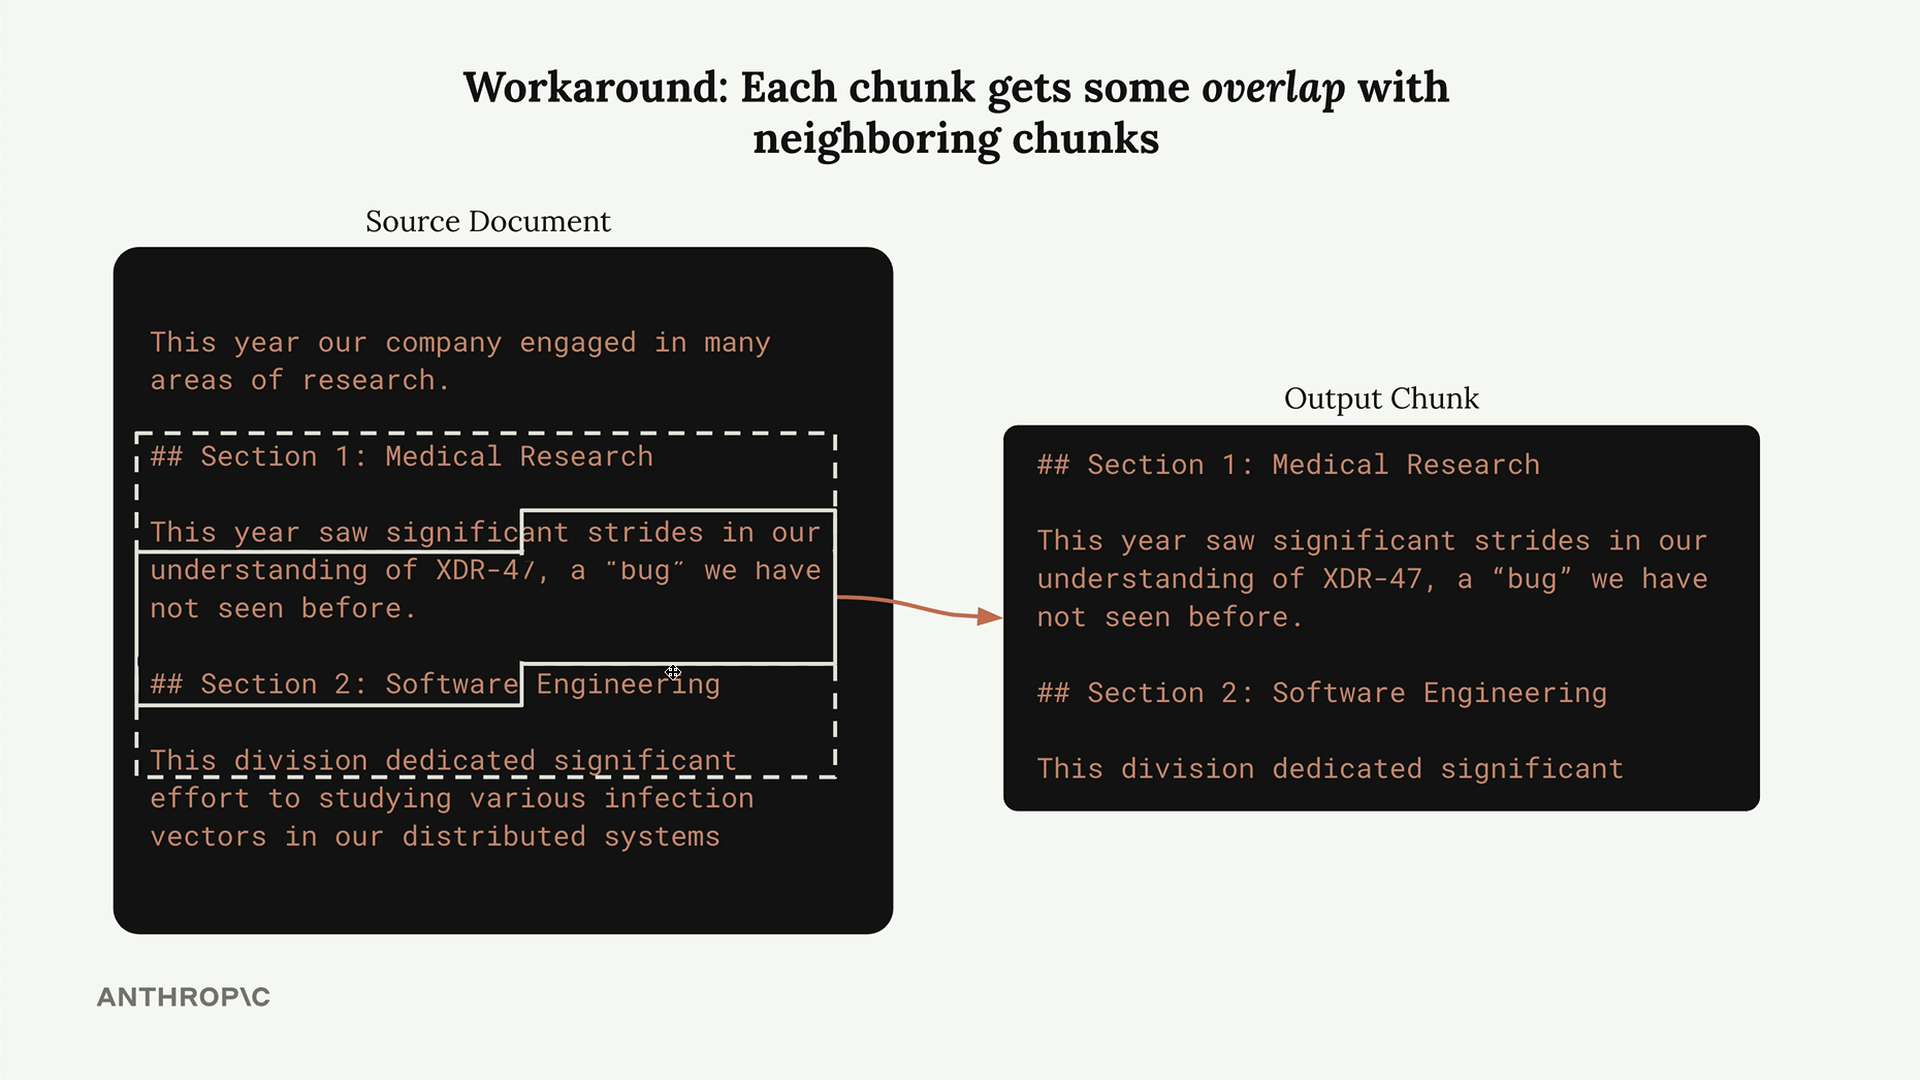
以下是带重叠的基于字符分块的基本实现:
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
基于结构的分块
基于结构的分块利用了文档的自然组织方式。如果您处理的是 markdown 文件,可以按标题拆分。对于其他格式,您可能会按段落或其他结构元素拆分。
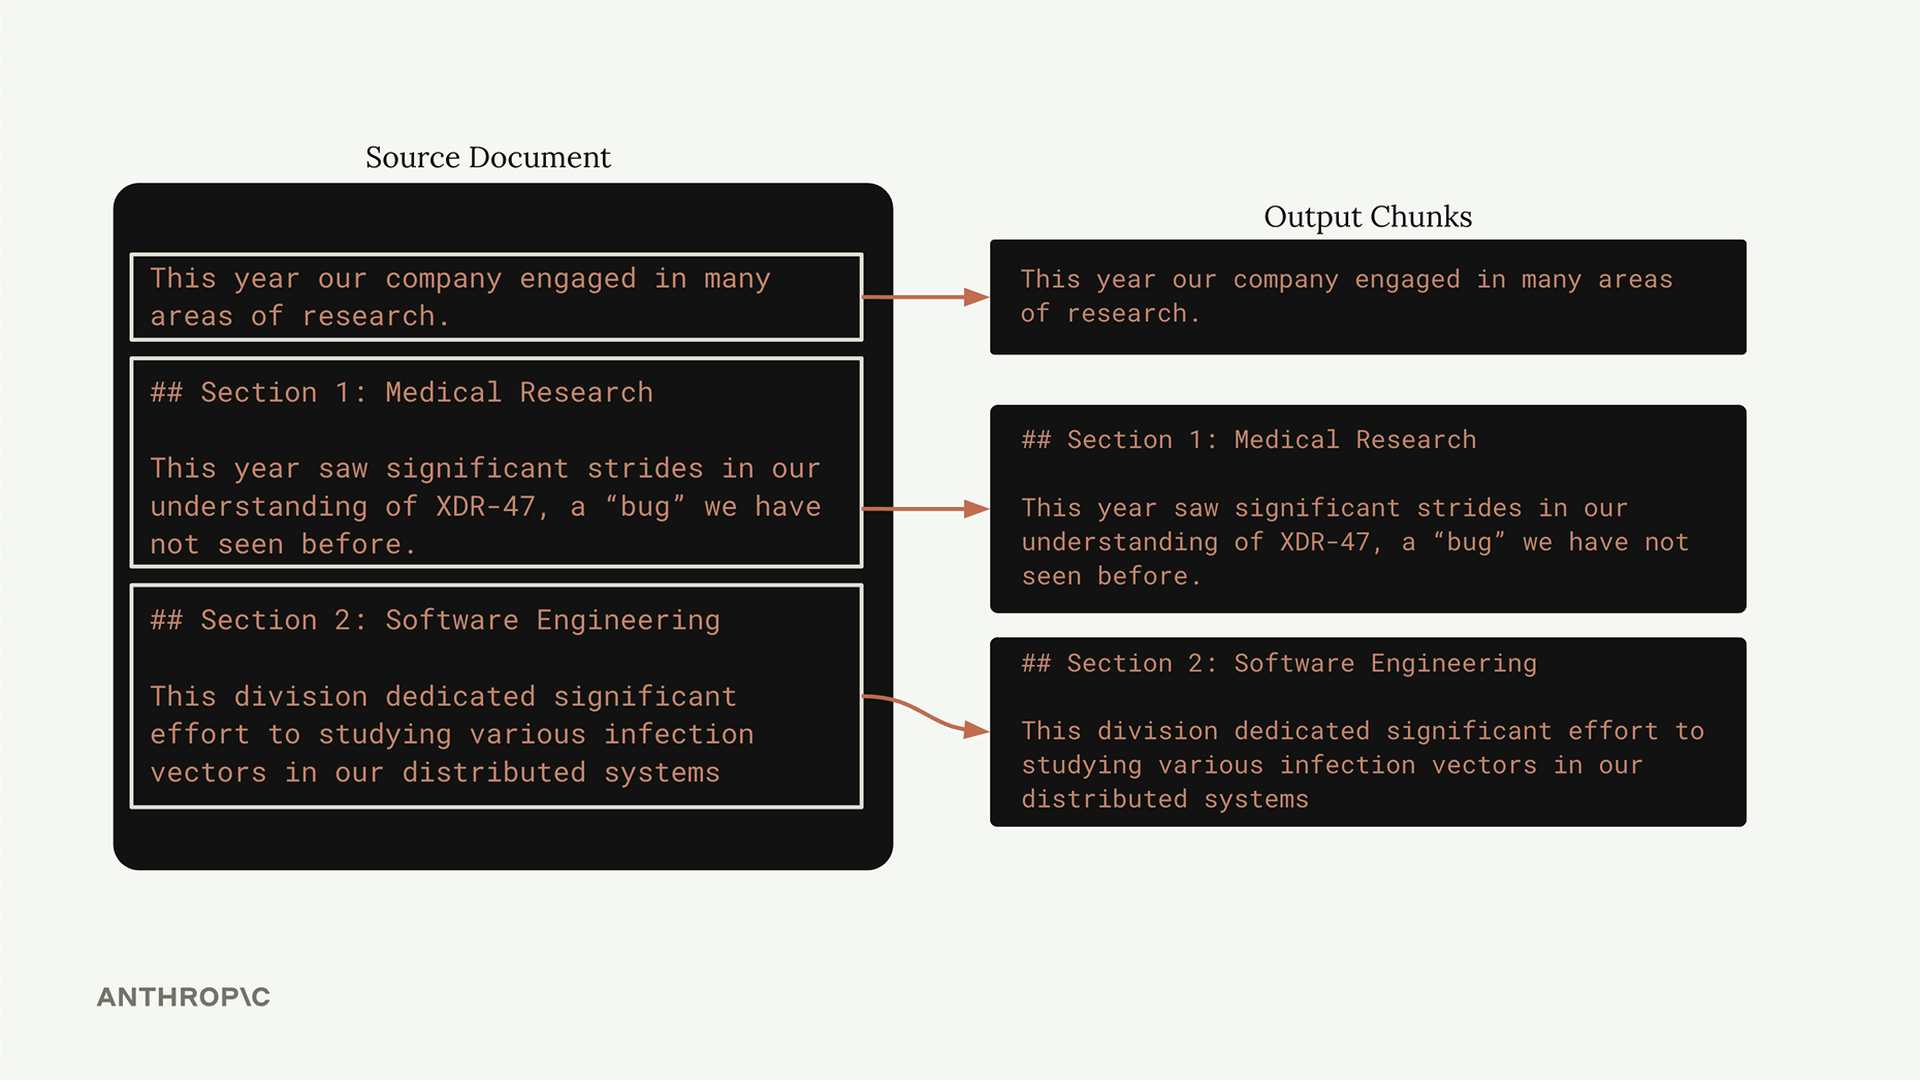
当您对文档结构有保证时,这种方法效果非常好。对于 markdown 文档,您可以按章节标题拆分:
def chunk_by_section(document_text):
    pattern = r'\n## '
    return re.split(pattern, document_text)
主要的限制是许多文档没有一致的结构。纯文本文件、PDF 或用户上传的文档可能没有明确的结构标记可供拆分。
基于语义的分块
基于语义的分块是最复杂的方法。它分析句子之间的含义和关系,将相关内容分组在一起。这通常涉及:
- 将文本拆分为句子
- 使用 NLP 技术衡量语义相似性
- 将相关句子分组为连贯的块
虽然这种方法可以产生最高质量的块,但它的计算成本高昂,实现也更复杂。对于大多数应用而言,更简单的方法已经足够好用。
实际实现
以下是一个基于句子的分块函数,它提供了一个很好的折中方案:
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r'(?<=[.!?])\s+', text)
    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(' '.join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
选择合适的策略
您选择的分块策略完全取决于您的具体使用场景:
- 一致的文档结构: 使用基于结构的分块以获得最干净的结果
- 混合文档类型: 基于句子的分块通常效果良好
- 代码或技术内容: 基于字符的分块最为可靠
- 未知文档格式: 基于字符的分块是您最安全的选择
请记住,分块通常是一个迭代过程。从简单的方法开始,用您的特定文档和使用场景进行测试,然后根据结果进行优化。"最佳"分块策略是能够可靠地适用于您特定数据和需求的策略。