프롬프트 평가 워크플로우를 구축할 때, 채점 시스템은 출력 품질에 대한 객관적인 신호를 제공합니다. 채점기(grader)는 모델 출력을 받아 측정 가능한 형태의 피드백을 반환합니다 - 일반적으로 1에서 10 사이의 숫자로, 10은 높은 품질을, 1은 낮은 품질을 나타냅니다.
채점기의 유형
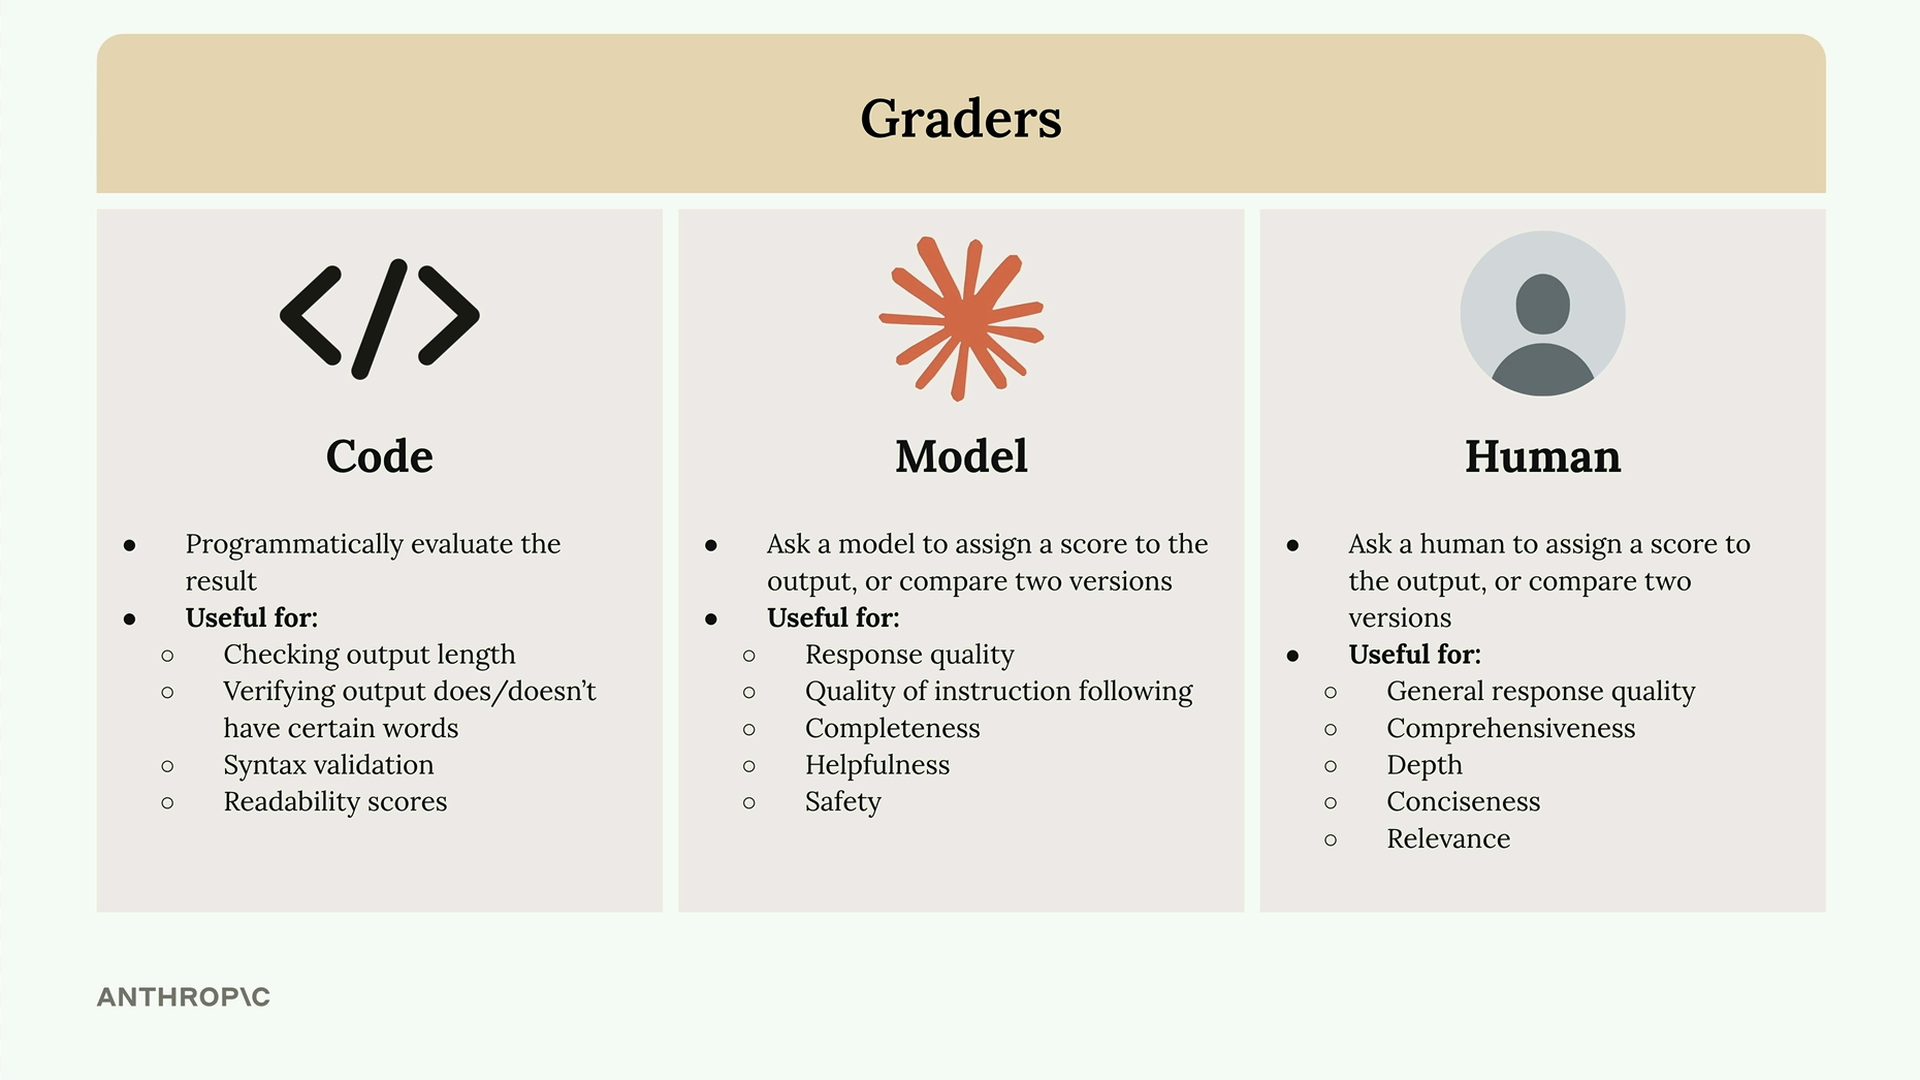
모델 출력을 채점하는 데는 세 가지 주요 접근 방식이 있습니다:
- 코드 채점기 - 커스텀 코드를 사용하여 프로그래밍 방식으로 출력을 평가합니다
- 모델 채점기 - 다른 AI 모델을 사용하여 품질을 평가합니다
- 인간 채점기 - 사람이 직접 출력을 검토하고 점수를 매깁니다
코드 채점기
코드 채점기를 사용하면 상상할 수 있는 모든 프로그래밍 방식의 검사를 구현할 수 있습니다. 일반적인 사용 사례는 다음과 같습니다:
- 출력 길이 확인
- 출력에 특정 단어가 포함되어 있는지 또는 포함되어 있지 않은지 확인
- JSON, Python 또는 정규식에 대한 구문 검증
- 적절한 읽기 수준을 보장하기 위한 가독성 점수
모델 채점기
모델 채점기는 추가 API 호출을 사용하여 출력을 평가함으로써 엄청난 유연성을 제공합니다. 다음과 같은 항목을 평가하는 데 유용합니다:
- 응답 품질
- 지시 사항 준수 품질
- 완전성
- 유용성
- 안전성
인간 채점기
인간 채점기는 가장 큰 유연성을 제공하지만 상당한 단점도 있습니다. 인간은 상상할 수 있는 모든 기준에 대해 응답을 평가할 수 있지만, 그 과정은 시간이 많이 걸리고 지루합니다.
평가 기준 정의하기
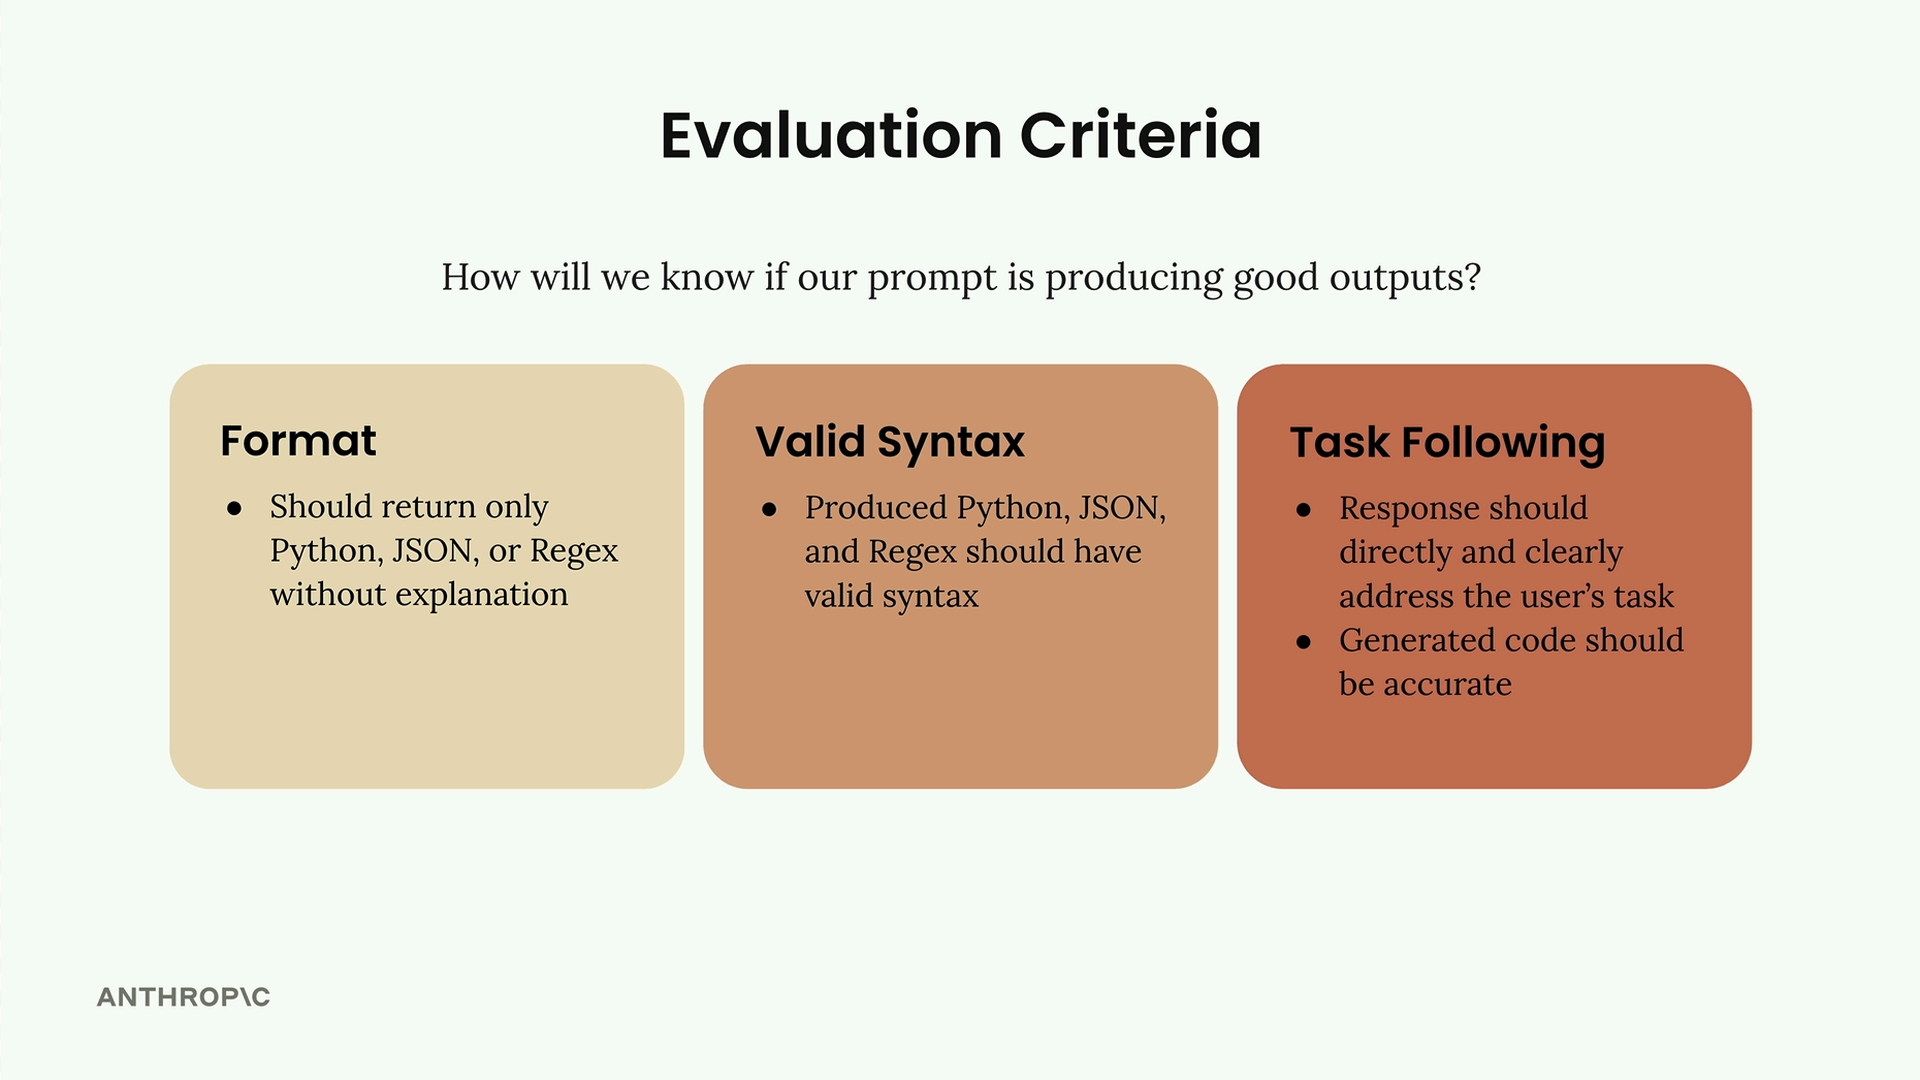
채점기를 구현하기 전에 명확한 평가 기준이 필요합니다. 코드 생성 프롬프트의 경우, 다음에 초점을 맞출 수 있습니다:
- 형식 - 설명 없이 Python, JSON 또는 정규식만 반환해야 합니다
- 유효한 구문 - 생성된 코드는 유효한 구문을 가져야 합니다
- 작업 준수 - 응답은 정확한 코드로 사용자의 작업을 직접적으로 다루어야 합니다
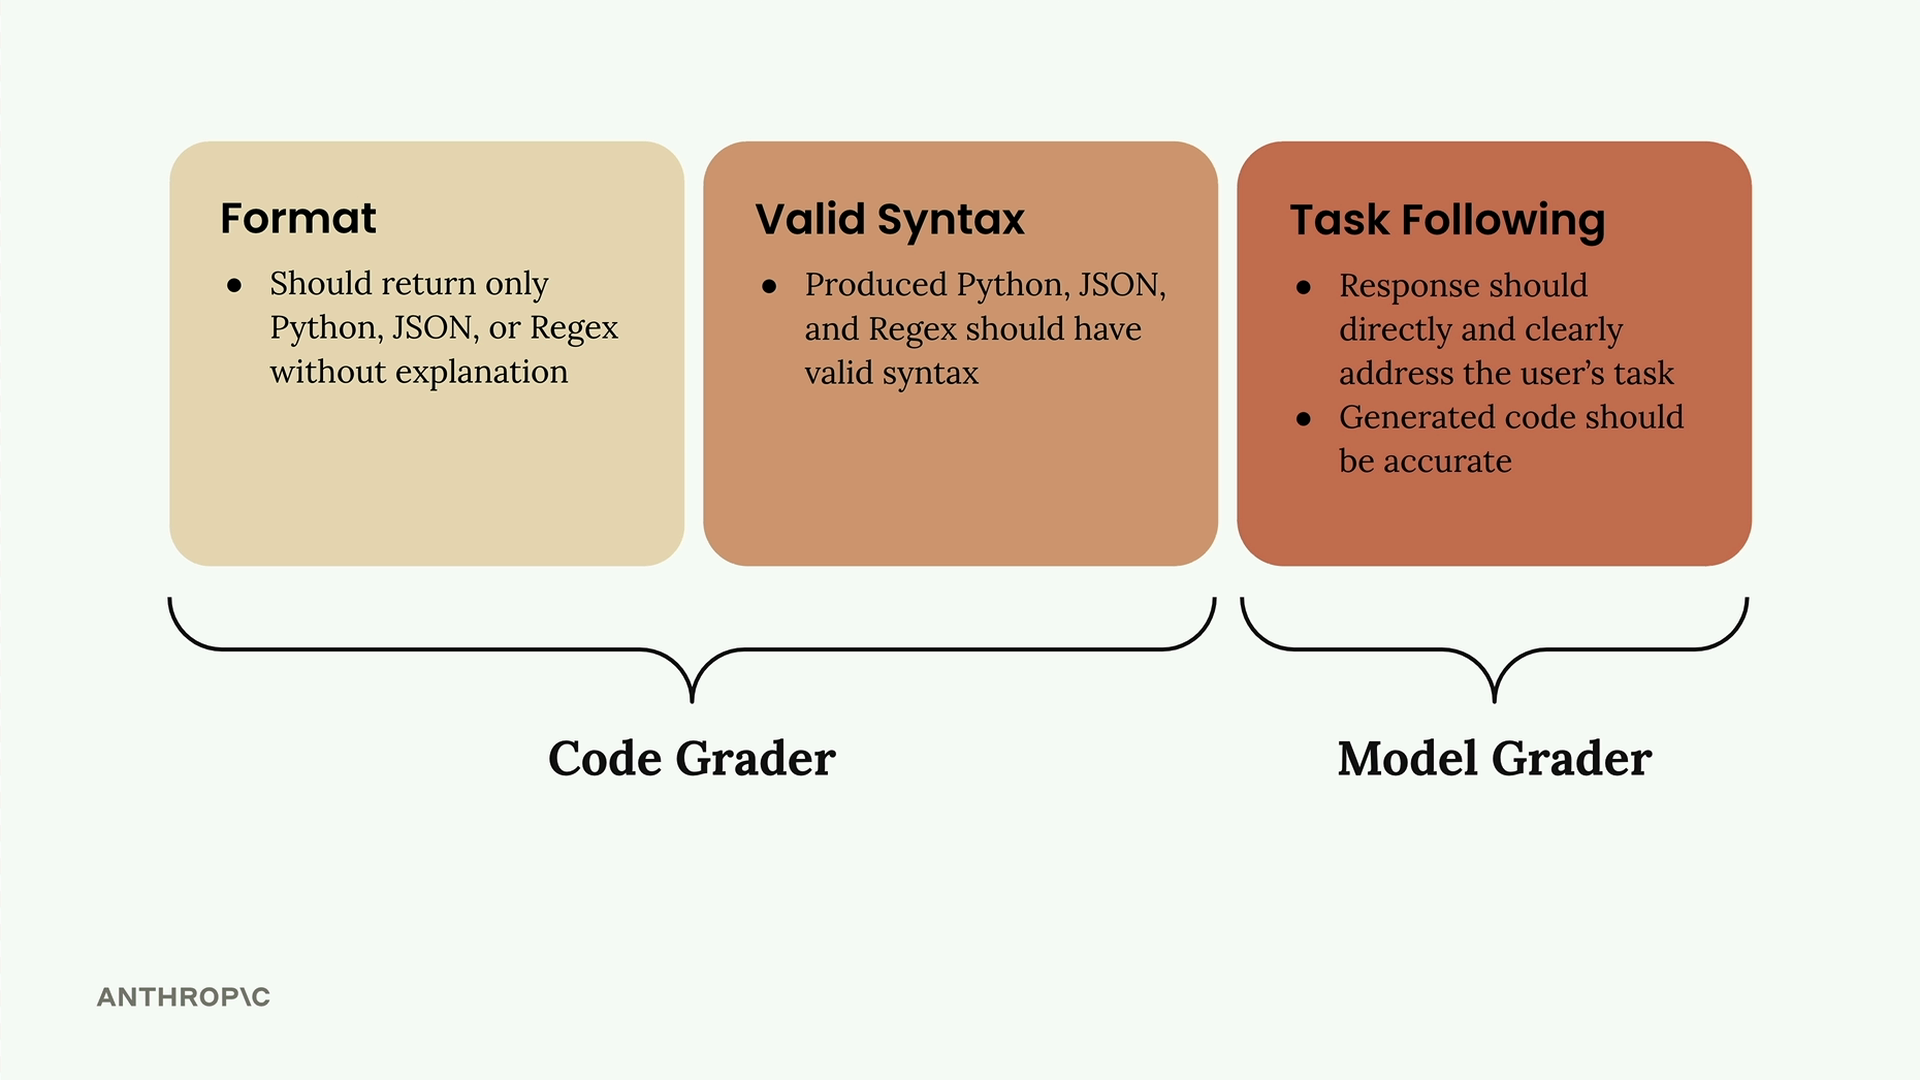
처음 두 기준은 코드 채점기와 잘 맞으며, 작업 준수는 유연성 때문에 모델 채점기에 더 적합합니다.
모델 채점기 구현하기
모델 채점기는 구현하기 가장 쉬운 경우가 많습니다. 기본 구조는 다음과 같습니다:
def grade_by_model(test_case, output):
    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")
    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)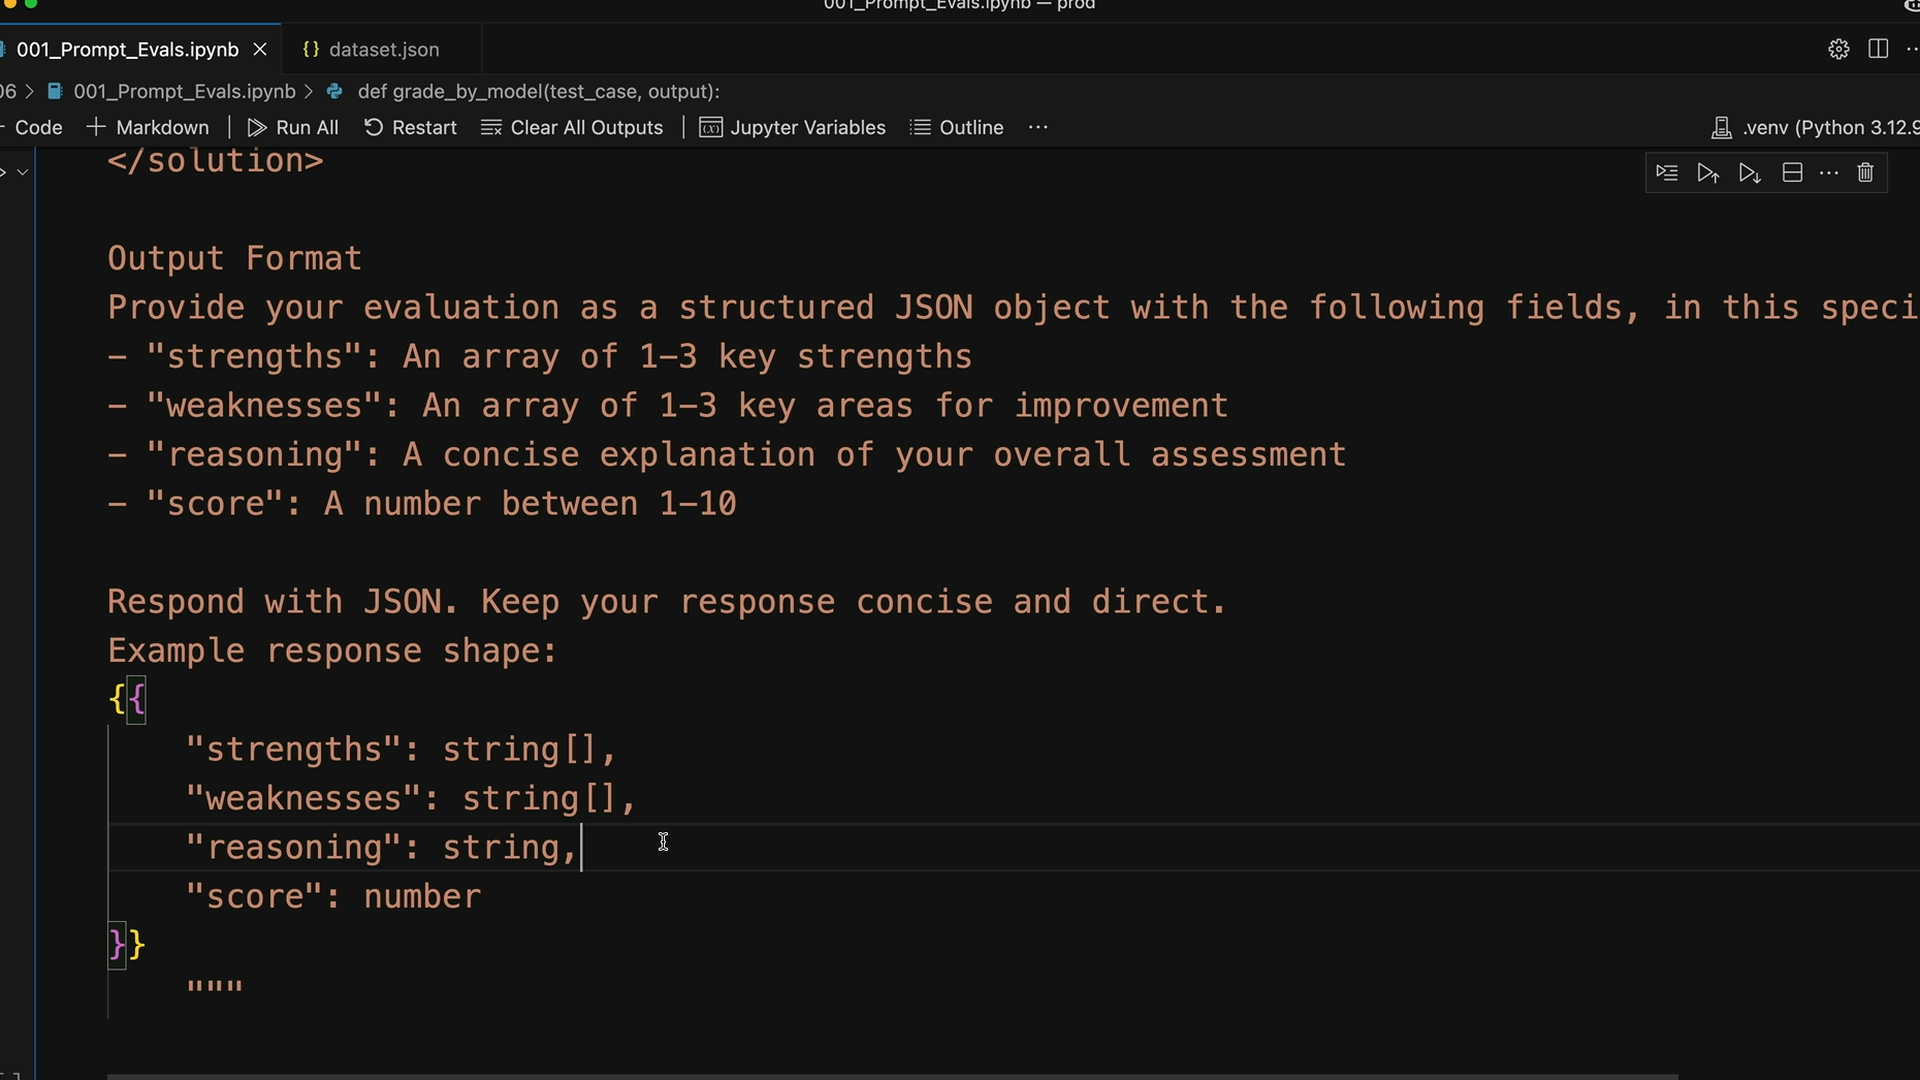
채점 프롬프트는 포괄적이어야 하며 다음을 포함해야 합니다:
- 채점기에 대한 명확한 역할 정의
- 원래의 작업
- 평가할 AI 생성 솔루션
- 구체적인 출력 형식 요구 사항
단순히 점수만 요청하지 마세요. 숫자 점수와 함께 강점, 약점, 그리고 근거를 요청하세요. 이는 모델이 6점과 같은 중간 점수로 기본값을 설정하는 것을 방지하고 더 신중한 평가를 강제합니다.
채점기를 워크플로우에 통합하기
채점기 함수를 갖추었다면, 이를 테스트 케이스 러너에 통합하세요:
def run_test_case(test_case):
    output = run_prompt(test_case)

    # 모델 채점기를 호출합니다
    model_grade = grade_by_model(test_case, output)
    score = model_grade["score"]
    reasoning = model_grade["reasoning"]

    return {
        "output": output,
        "test_case": test_case,
        "score": score,
        "reasoning": reasoning
    }
모든 테스트 케이스를 실행한 후, 평균 점수를 계산하여 프롬프트 성능에 대한 객관적인 지표를 얻으세요:
from statistics import mean

def run_eval(dataset):
    results = []
    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    average_score = mean([result["score"] for result in results])
    print(f"Average score: {average_score}")

    return results
이를 통해 개선에 집중할 수 있는 구체적인 숫자를 얻을 수 있습니다. 모델 채점기는 다소 변덕스러울 수 있고 더 나은 가이드가 필요할 수도 있지만, 반복하고 개선할 수 있는 객관적인 평가의 출발점을 제공합니다.