Was ist Denken?
Manche Aufgaben brauchen mehr als eine schnelle Antwort. Claude kann ein Problem durchdenken, bevor es antwortet — eine Funktion namens erweitertes Denken. In dieser Lektion schauen wir uns an, was Denken ist, wie es funktioniert und wann es tatsächlich hilft.
Hier ist der Fehlermodus, den wir vermeiden wollen. Stelle einem Modell eine mehrstufige Frage und lass es sofort antworten, und es kann die Antwort selbstbewusst falsch geben:
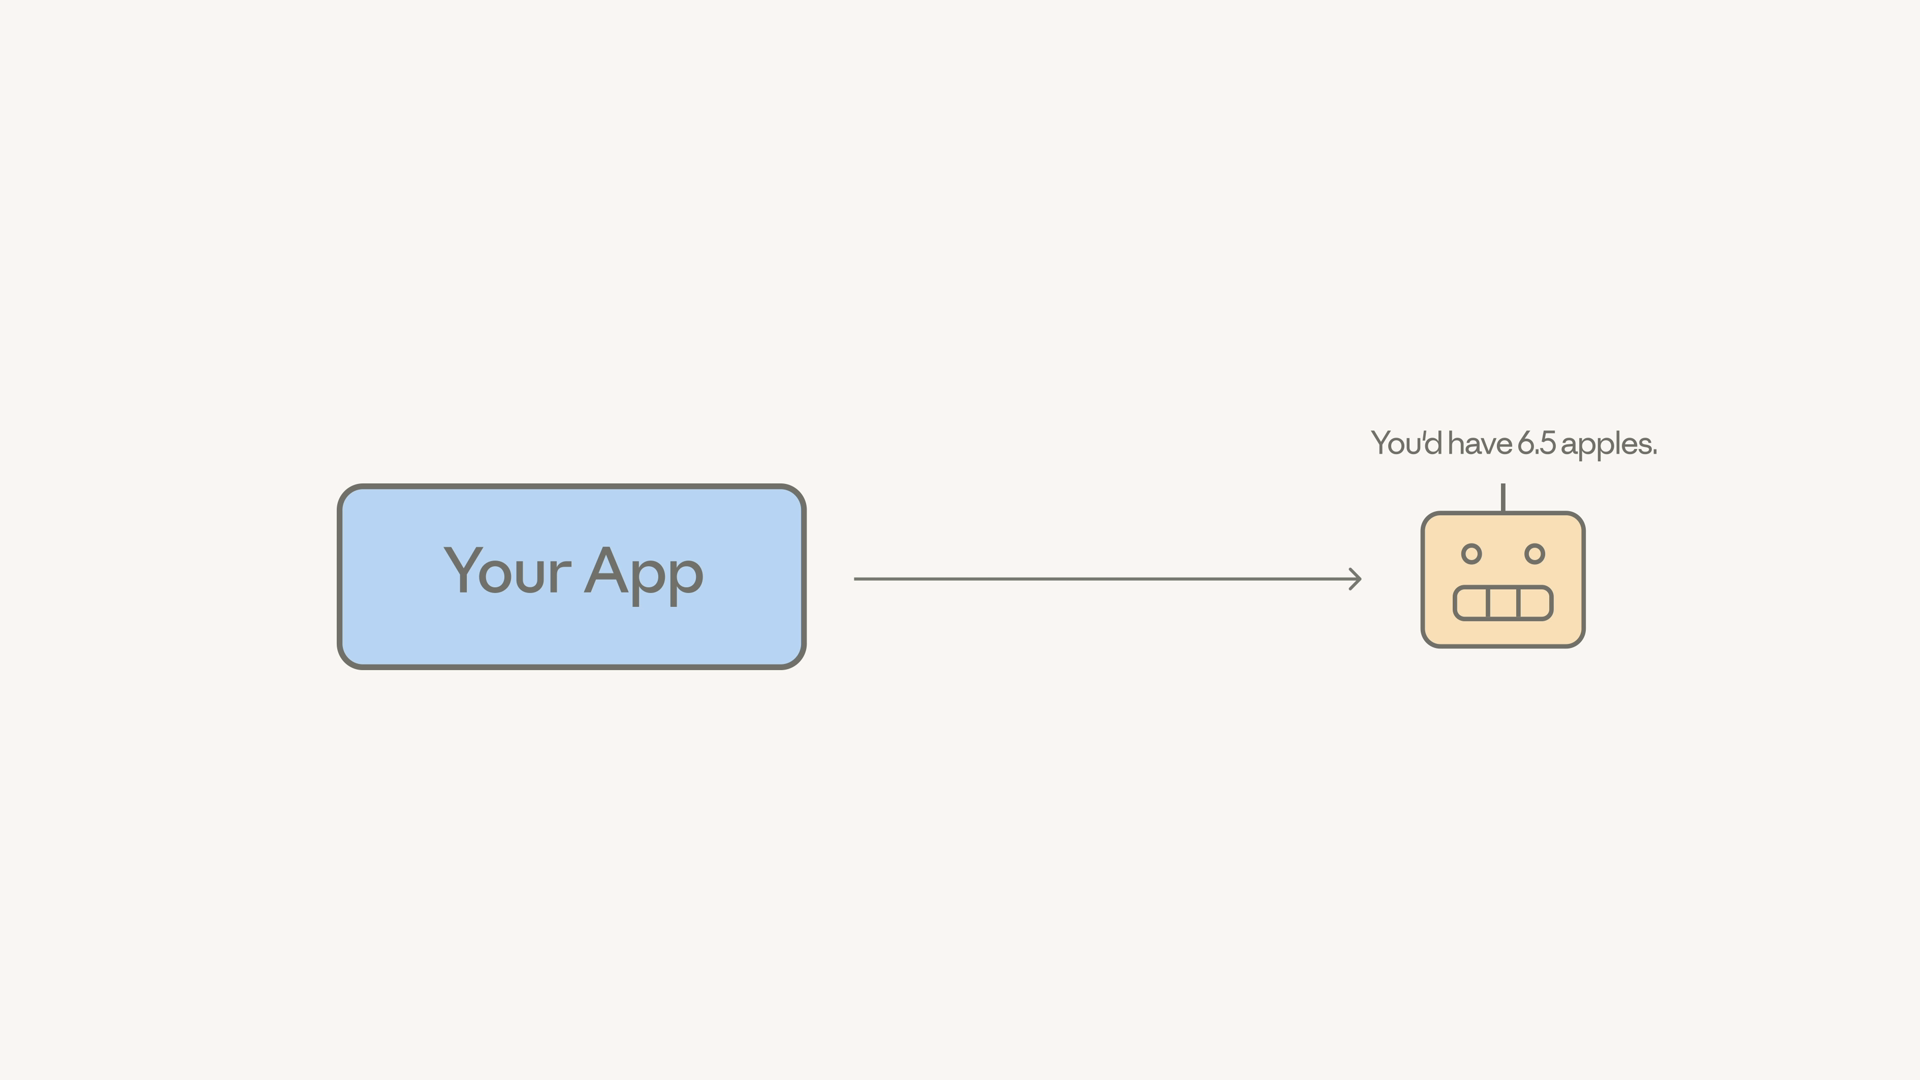
Was ist erweitertes Denken?
Erweitertes Denken lässt Claude Schritt für Schritt nachdenken, bevor es eine endgültige Antwort erstellt. Wenn es aktiviert ist, generiert Claude interne Reasoning-Tokens — oft als Chain of Thought bezeichnet — und liefert dann die Antwort. Bei Claude Opus 5 bleibt der Denktext verborgen, sofern die thinking-Einstellung deiner Anfrage nicht "display": "summarized" enthält, wie im folgenden Beispiel. Ist das der Fall, kommt zusammen mit dem endgültigen Text eine Zusammenfassung von Claudes Überlegungen in der Antwort zurück.
Adaptives Denken bei Claude Opus 5
Bei Opus 5 ist Denken adaptiv und standardmäßig aktiviert. Es gibt kein Token-Budget, das du festlegen musst: Claude entscheidet dynamisch, wann und wie viel es denkt.
Um zu steuern, wie viel Claude denkt, verwende den Parameter effort. Ein Haken dabei: Er gehört in output_config, nicht neben den thinking-Block. Die Stufen sind:
lowmediumhigh(Standard)xhigh(extra hoch)max
Wann man es verwendet (und wann man es überspringt)
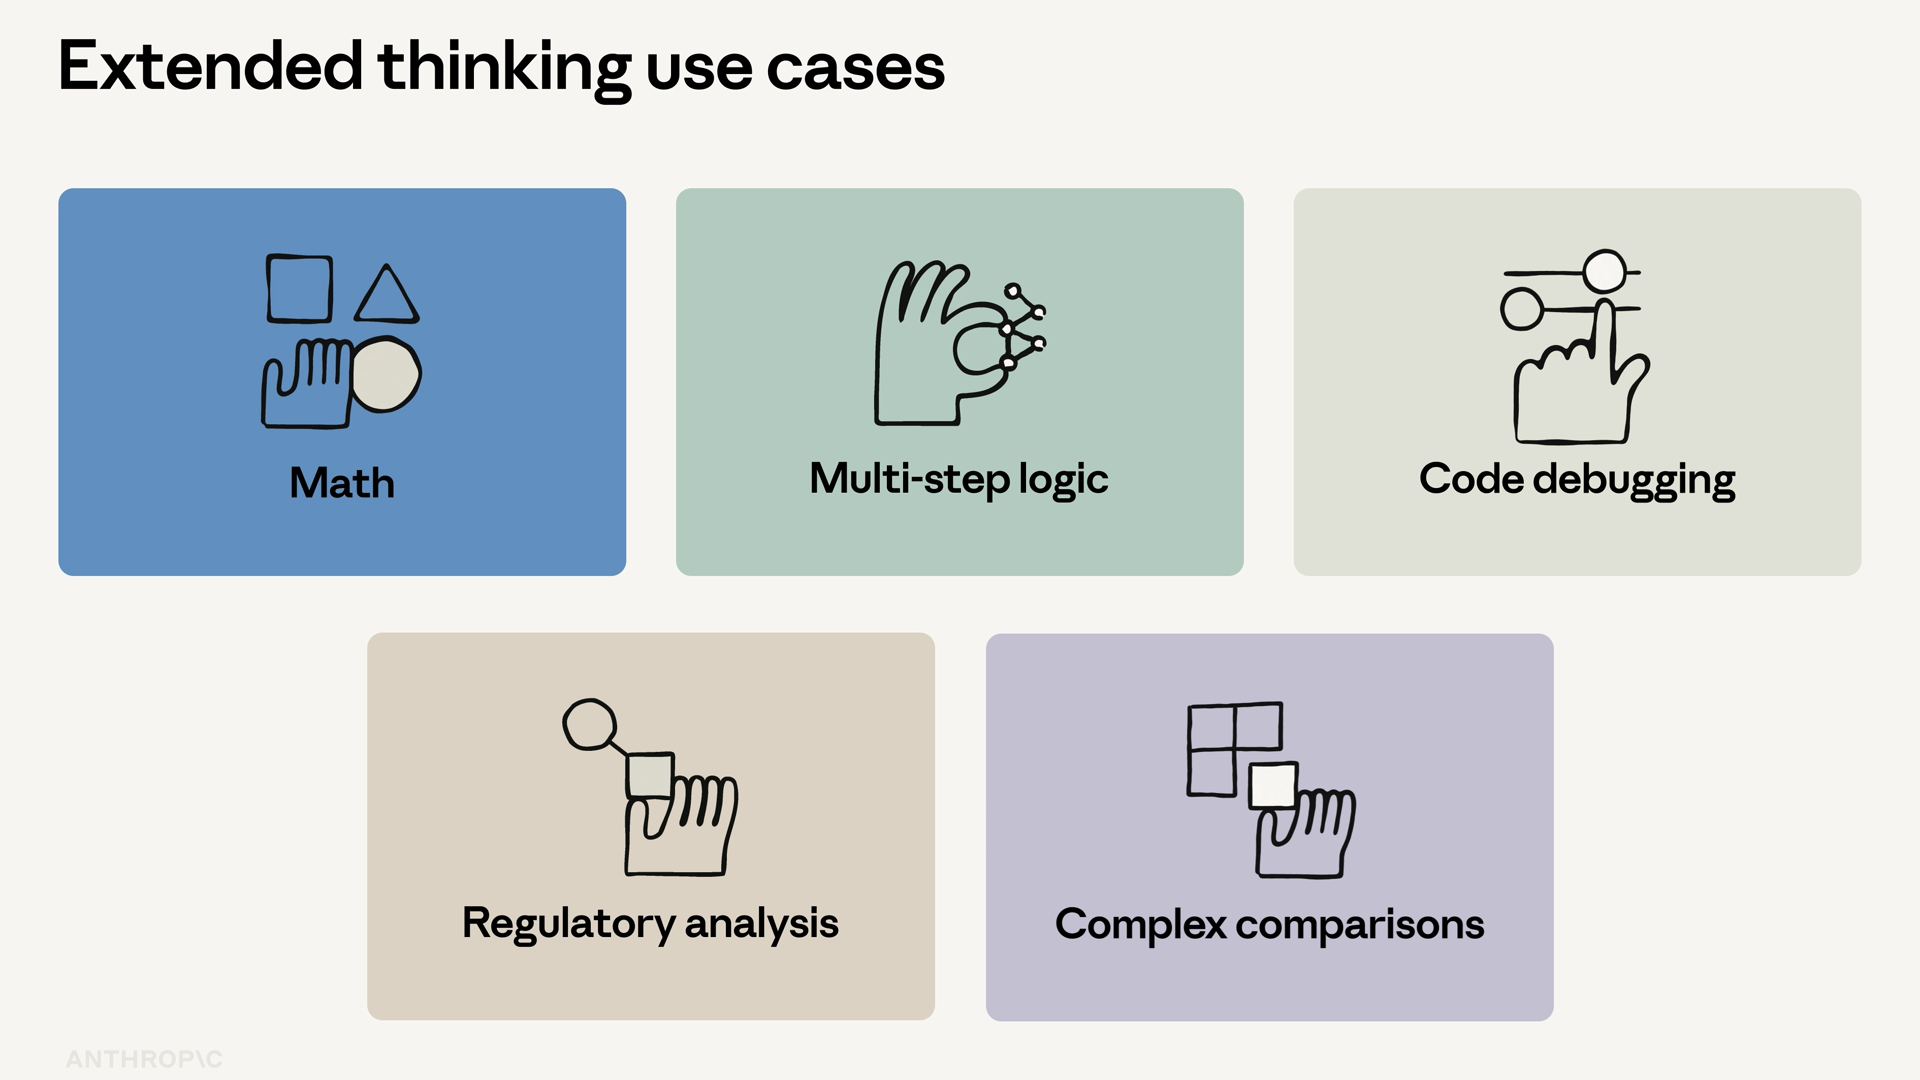
Erweitertes Denken hilft bei:
- Mathematik und mehrstufiger Logik
- Code-Debugging
- Regulatorischer Analyse
- Allem, was Trade-offs oder den Vergleich von Optionen beinhaltet
Überspringe es bei einfacher Klassifizierung, Extraktion oder Standardaufgaben. Bei solchen Aufgaben erhöht es nur Latenz und Kosten, ohne die Ergebnisse tatsächlich zu verbessern.
Denken in Aktion
Schauen wir es uns in Aktion an. Hier ist eine Agent-Loop mit einem Wetter-Tool, und wir bitten Claude, einen Roadtrip ab San Francisco zu planen — zwei Stopps, wobei Wetter und Fahrzeit abgewogen werden. Das ist ein echter Trade-off, die Art von Frage, bei der sich Denken auszahlt.
import anthropic

client = anthropic.Anthropic()

weather_tool = {
    "name": "get_weather",
    "description": "Get the current weather for a city.",
    "input_schema": {
        "type": "object",
        "properties": {
            "city": {"type": "string", "description": "City name"}
        },
        "required": ["city"],
    },
}

response = client.messages.create(
    model="claude-opus-5",
    max_tokens=16000,
    thinking={"type": "adaptive", "display": "summarized"},  # summarized = return the reasoning text
    output_config={"effort": "high"},  # low | medium | high | xhigh | max
    tools=[weather_tool],
    messages=[
        {
            "role": "user",
            "content": "Plan a road trip out of San Francisco with two stops, "
                       "weighing weather and drive time.",
        }
    ],
)
Wenn du das ausführst, ist die Ausgabe interessanter als gewöhnlich. Du siehst Thinking-Blöcke, in denen Claude die Trade-offs durcharbeitet, gefolgt von Tool-Aufrufen zur Überprüfung jeder Stadt und schließlich einem Textblock mit der eigentlichen Empfehlung.
Die Überlegungen sind sichtbar — genau das ist der Sinn der Sache.
Warum das in der Produktion wichtig ist
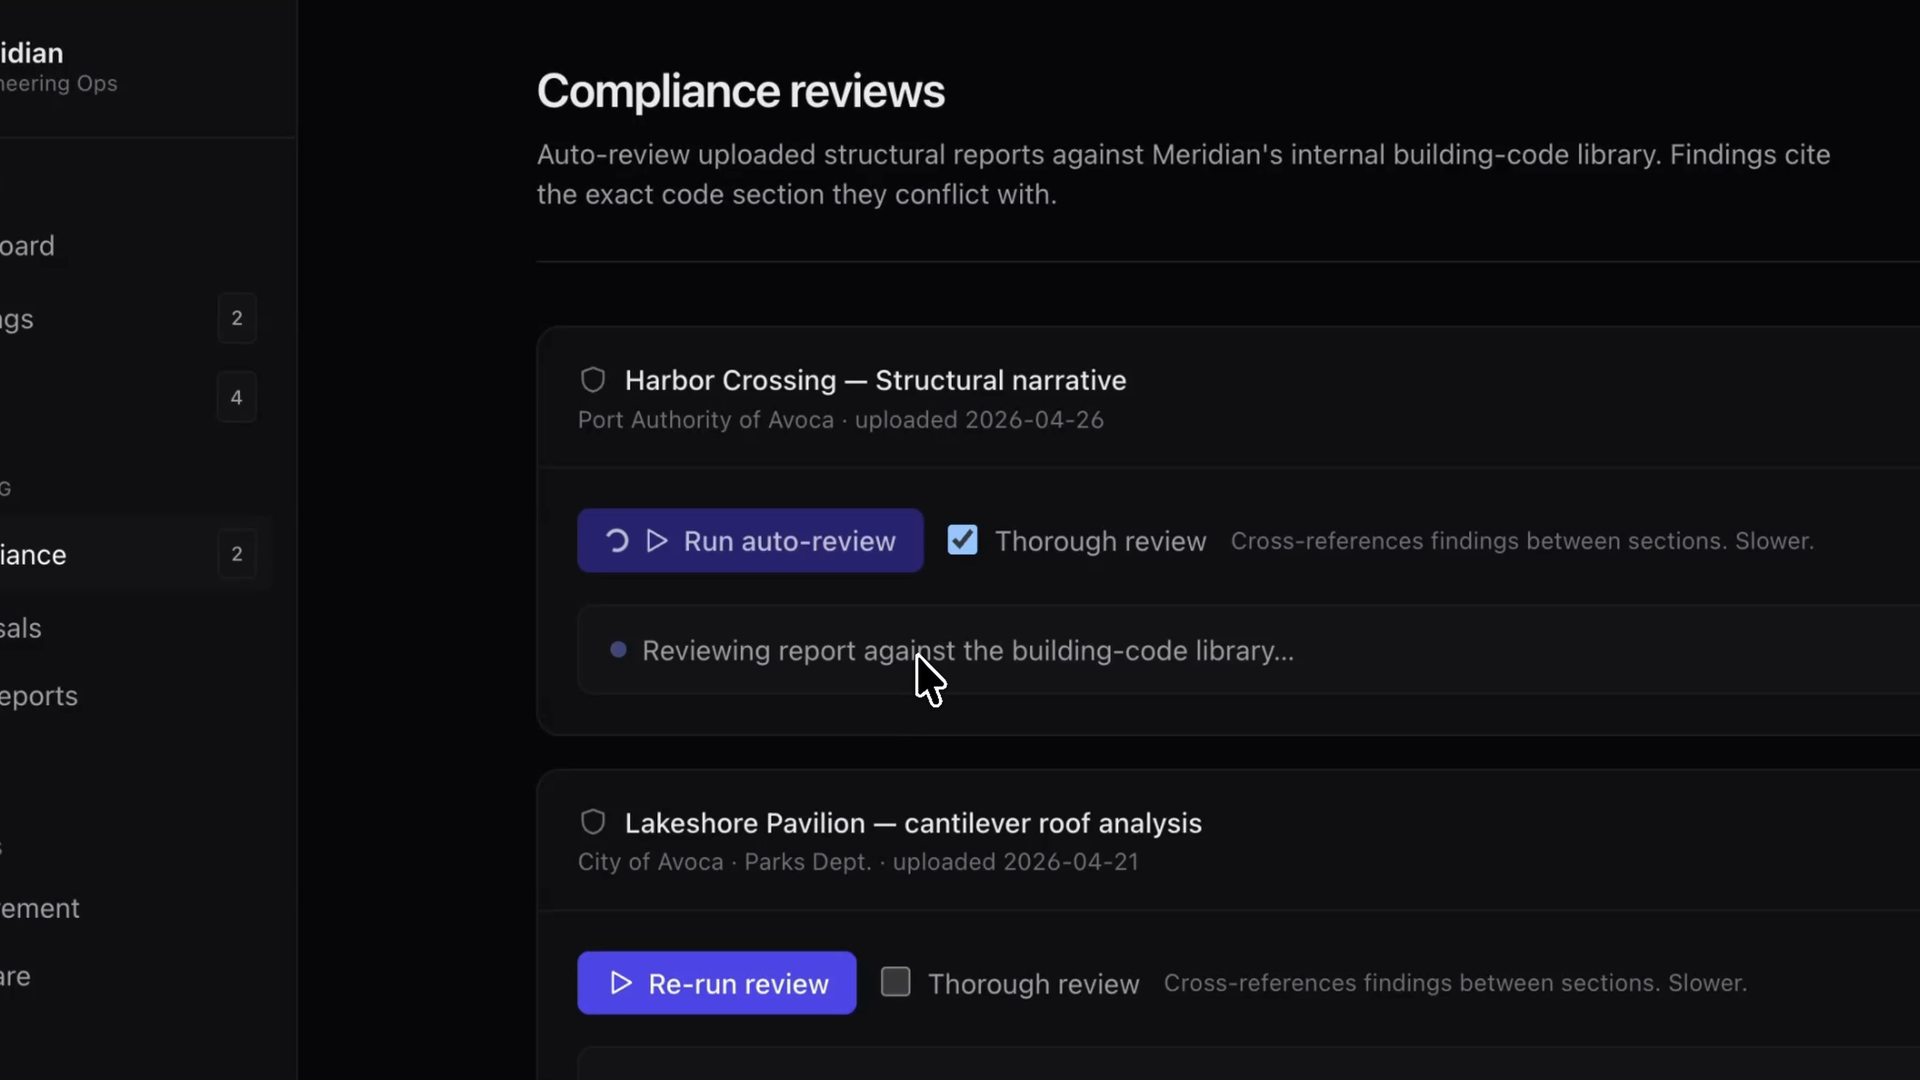
In einer Produktionsanwendung ist das der Unterschied zwischen einem Agenten, der Probleme einzeln findet, und einem Agenten, der sie miteinander verknüpft. Nimm eine Compliance-Review-App: Das Aktivieren von adaptivem Denken beim Auto-Review-Aufruf ermöglicht es dem Agenten, über Berichtsabschnitte hinweg zu schlussfolgern — und so Dinge zu erkennen wie eine Windlastspezifikation in Abschnitt drei, die im Widerspruch zur Materialspezifikation an anderer Stelle im Dokument steht.
Zusammenfassung
- Erweitertes Denken gibt Claude Raum, um nachzudenken, bevor es antwortet. Bei Opus 5 enthält die Antwort eine Zusammenfassung dieser Überlegungen nur, wenn du danach fragst.
- Bei Opus 5 ist adaptives Denken standardmäßig aktiviert — kein Token-Budget erforderlich. Füge
"display": "summarized"hinzu, um die Überlegungen in der Antwort zu sehen. - Stelle die Tiefe mit dem Parameter effort innerhalb von
output_configein:low,medium,high(Standard),xhighodermax. - Verwende es für schwierige, trade-off-intensive Probleme. Überspringe es bei einfachen — dort kostet es nur Latenz und Tokens.