Das richtige Modell auswählen
Du lieferst eine App mit Claude aus. Welches Modell wählst du? Wenn du standardmäßig das intelligenteste nimmst, wird dich deine API-Rechnung überraschen. Wählst du das günstigste, hält die Ausgabe vielleicht nicht stand. Jedes Modell hat andere Kompromisse, und die richtige Wahl beeinflusst sowohl Qualität als auch Kosten.
Die Modell-Stufen
Anthropic bietet derzeit vier Modell-Stufen an, zwischen denen du mit dem Parameter model in deinem API-Aufruf wählst.
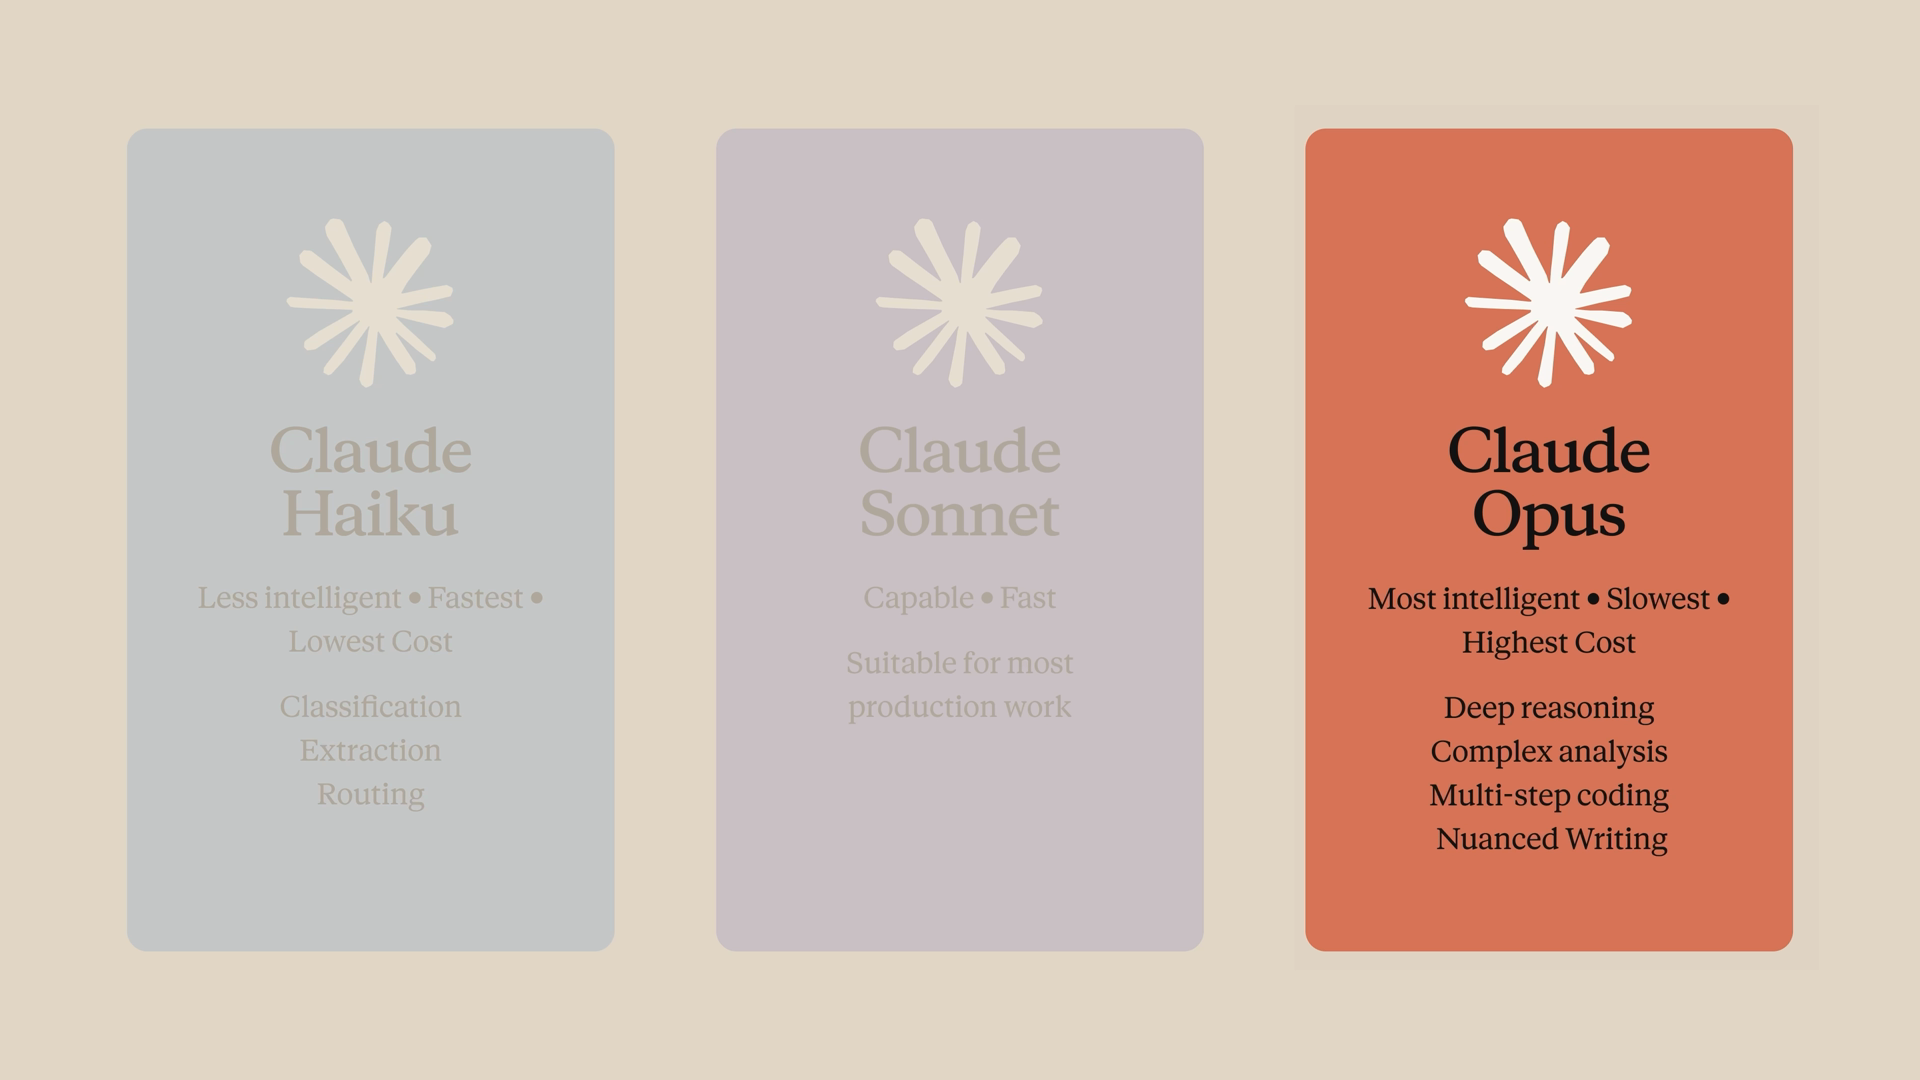
- Claude Fable ist unser bisher leistungsfähigstes Modell — eine neue Stufe, die über Opus angesiedelt ist und für deine anspruchsvollsten Herausforderungen entwickelt wurde. Es kommt mit höheren Kosten als Opus, also spare es dir für Arbeiten auf, bei denen sich diese zusätzliche Leistungsfähigkeit lohnt. Das aktuelle Fable-Modell ist Claude Fable 5.1 (
claude-fable-5-1). - Claude Opus ist das leistungsfähigste der drei Kernmodell-Familien, aber auch das langsamste und teuerste der drei. Nutze es für tiefgehendes Reasoning, komplexe Analysen, mehrstufiges Coding und nuancierte Texte. Das aktuelle Opus-Modell ist Claude Opus 5.5 (
claude-opus-5-5). - Claude Haiku ist das schnellste und kostengünstigste Modell, optimiert für Geschwindigkeit und Kosteneffizienz statt maximaler Intelligenz. Nutze es für hochvolumige, wenig komplexe Arbeiten wie Klassifizierung, Extraktion und Routing. Das aktuelle Haiku-Modell ist Claude Haiku 4.5 (
claude-haiku-4-5). - Claude Sonnet liegt im Sweet Spot: eine ausgewogene Kombination aus Intelligenz, Geschwindigkeit und Kosten, die für die meisten Produktionsaufgaben gut funktioniert. Das aktuelle Sonnet-Modell ist Claude Sonnet 5 (
claude-sonnet-5).
Beginne mit einer einfachen Evaluation
Bevor du Produktionscode schreibst, richte eine einfache Evaluation ein: eine Reihe von Beispiel-Eingaben, die du durch jedes Modell laufen lässt und anhand dessen bewertest, was eine gute Ausgabe für deinen Anwendungsfall bedeutet. Du brauchst nichts Ausgefallenes — 20 oder 30 repräsentative Beispiele aus deiner tatsächlichen Arbeitslast reichen zum Einstieg.
Arbeite dich dann die Stufen hoch:
- Lasse deine Beispiele zuerst durch Haiku laufen. Wenn die Qualität stimmt, bist du fertig — und hast gerade eine Menge Geld gespart.
- Wenn nicht, steige auf Sonnet um.
- Greife nur dann zu Opus, wenn die Aufgabe es erfordert.
Die Stufen im direkten Vergleich
Schauen wir uns den Unterschied zwischen den Stufen an, statt nur darüber zu reden. Wir schicken denselben Prompt durch alle drei Modelle und beobachten Latenz und Token-Anzahl:
models = ["claude-haiku-4-5", "claude-sonnet-5", "claude-opus-5-5"]

for model in models:
    response = client.messages.create(
        model=model,
        max_tokens=300,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, response.usage)
Hier passieren zwei Dinge:
- Die Schleife tauscht bei jeder Anfrage das Feld
modelaus. Gleicher Prompt, gleiche maximale Token-Anzahl — nur das Modell ändert sich. response.usageliefert dir die Eingabe- und Ausgabe-Token direkt von der API zurück — genau darauf basiert deine Rechnung.
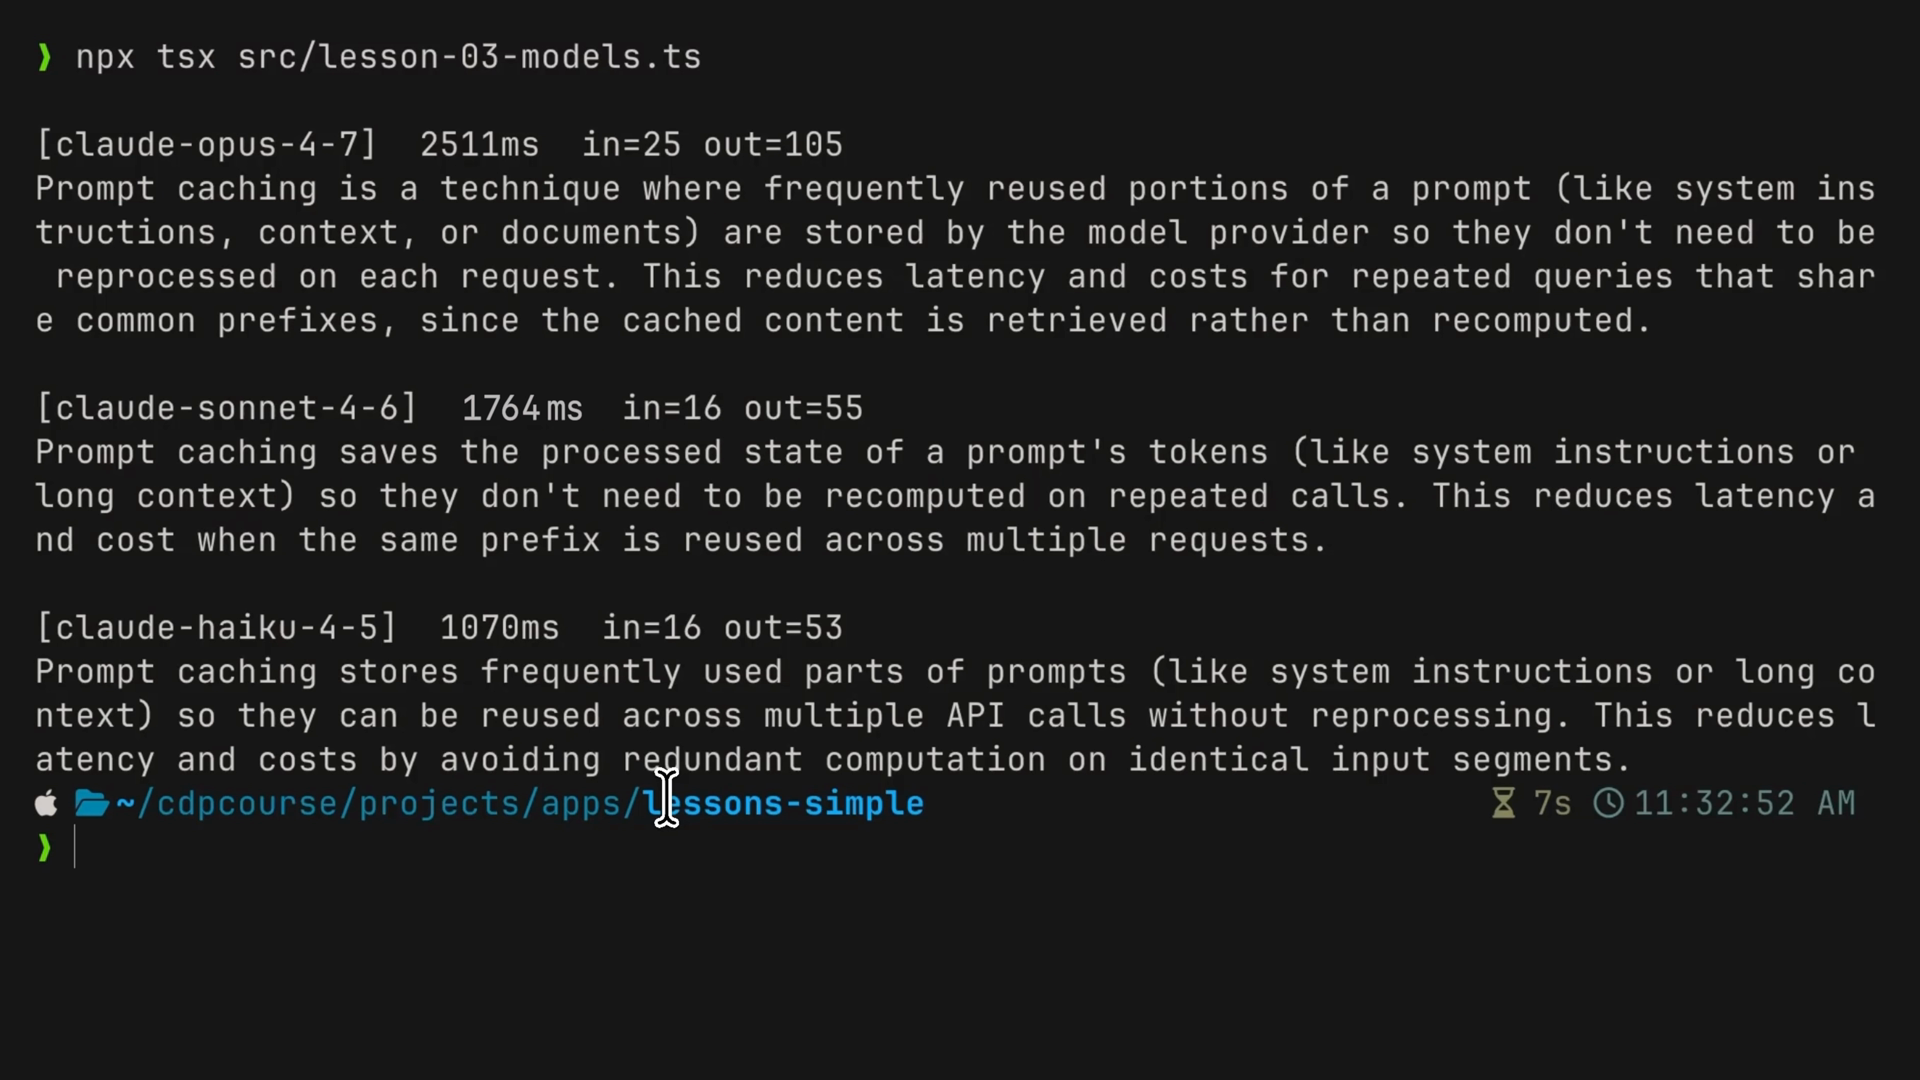
Führe es aus, und du siehst drei Modelle und drei Zahlensätze. Opus braucht am längsten und liest sich am ausgefeiltesten — aber für eine zweisätzige Definition ist dieser Feinschliff verschwendet. Sonnet strafft den Text etwas. Und Haiku antwortet oft in unter einer Sekunde mit einer durchaus kompetenten zweisätzigen Antwort zurück. Ehrlich gesagt ist es für diese Art von Szenario perfekt.
Und genau darum geht es: Das richtige Modell ist das günstigste, dessen Ausgabe du tatsächlich ausliefern würdest. Für eine Definition reicht Haiku völlig aus. Für den Entwurf einer regulatorischen Stellungnahme würdest du denselben Vergleich durchführen und würdest wahrscheinlich bei Opus landen. Die Evaluation hat jedes Mal dieselbe Form.
Unterschiedliche Arbeit an unterschiedliche Modelle weiterleiten
In einer echten App würdest du unterschiedliche Arten von Arbeit innerhalb desselben Endpunkts an unterschiedliche Modelle weiterleiten. Nimm ein Operations-Dashboard mit einer Route zur Dokumentenverarbeitung:
- Jede eingehende Datei wird mit Haiku klassifiziert.
- Kunden-Updates werden mit Sonnet entworfen.
- Nur RFP-Antworten greifen auf Opus zurück.
Eine Warteschlange, drei Modelle, ausgewählt pro Aufgabe.
Zusammenfassung
- Anthropic bietet vier Modell-Stufen: Fable für die höchste verfügbare Leistungsfähigkeit, Opus für schwierige Probleme, Sonnet für die tägliche Arbeit und Haiku für hohes Volumen.
- Richte eine einfache Evaluation ein — 20 oder 30 repräsentative Beispiele aus deiner echten Arbeitslast — bevor du Produktionscode schreibst.
- Führe die Evaluation von Haiku aufwärts aus und halte beim günstigsten Modell an, dessen Ausgabe du tatsächlich ausliefern würdest.
response.usagemeldet Eingabe- und Ausgabe-Token, worauf deine Rechnung basiert.- Leite in der Produktion unterschiedliche Aufgaben innerhalb desselben Endpunkts an unterschiedliche Modelle weiter, statt ein Modell für alles zu wählen.