上下文管理
您发送给Claude的每一个请求都有一个上下文窗口。一百万个令牌听起来很多,但一旦您开始构建真正的智能体,它消耗的速度会比您想象的更快。这就是上下文管理发挥作用的地方:它能帮助您在不超出窗口限制的同时,不丢失重要内容。
什么算作上下文
上下文是Claude在某一轮对话中所看到的一切:
- 系统提示
- 消息历史
- 工具定义和工具结果
- 附加的文件和技能
- 思考块
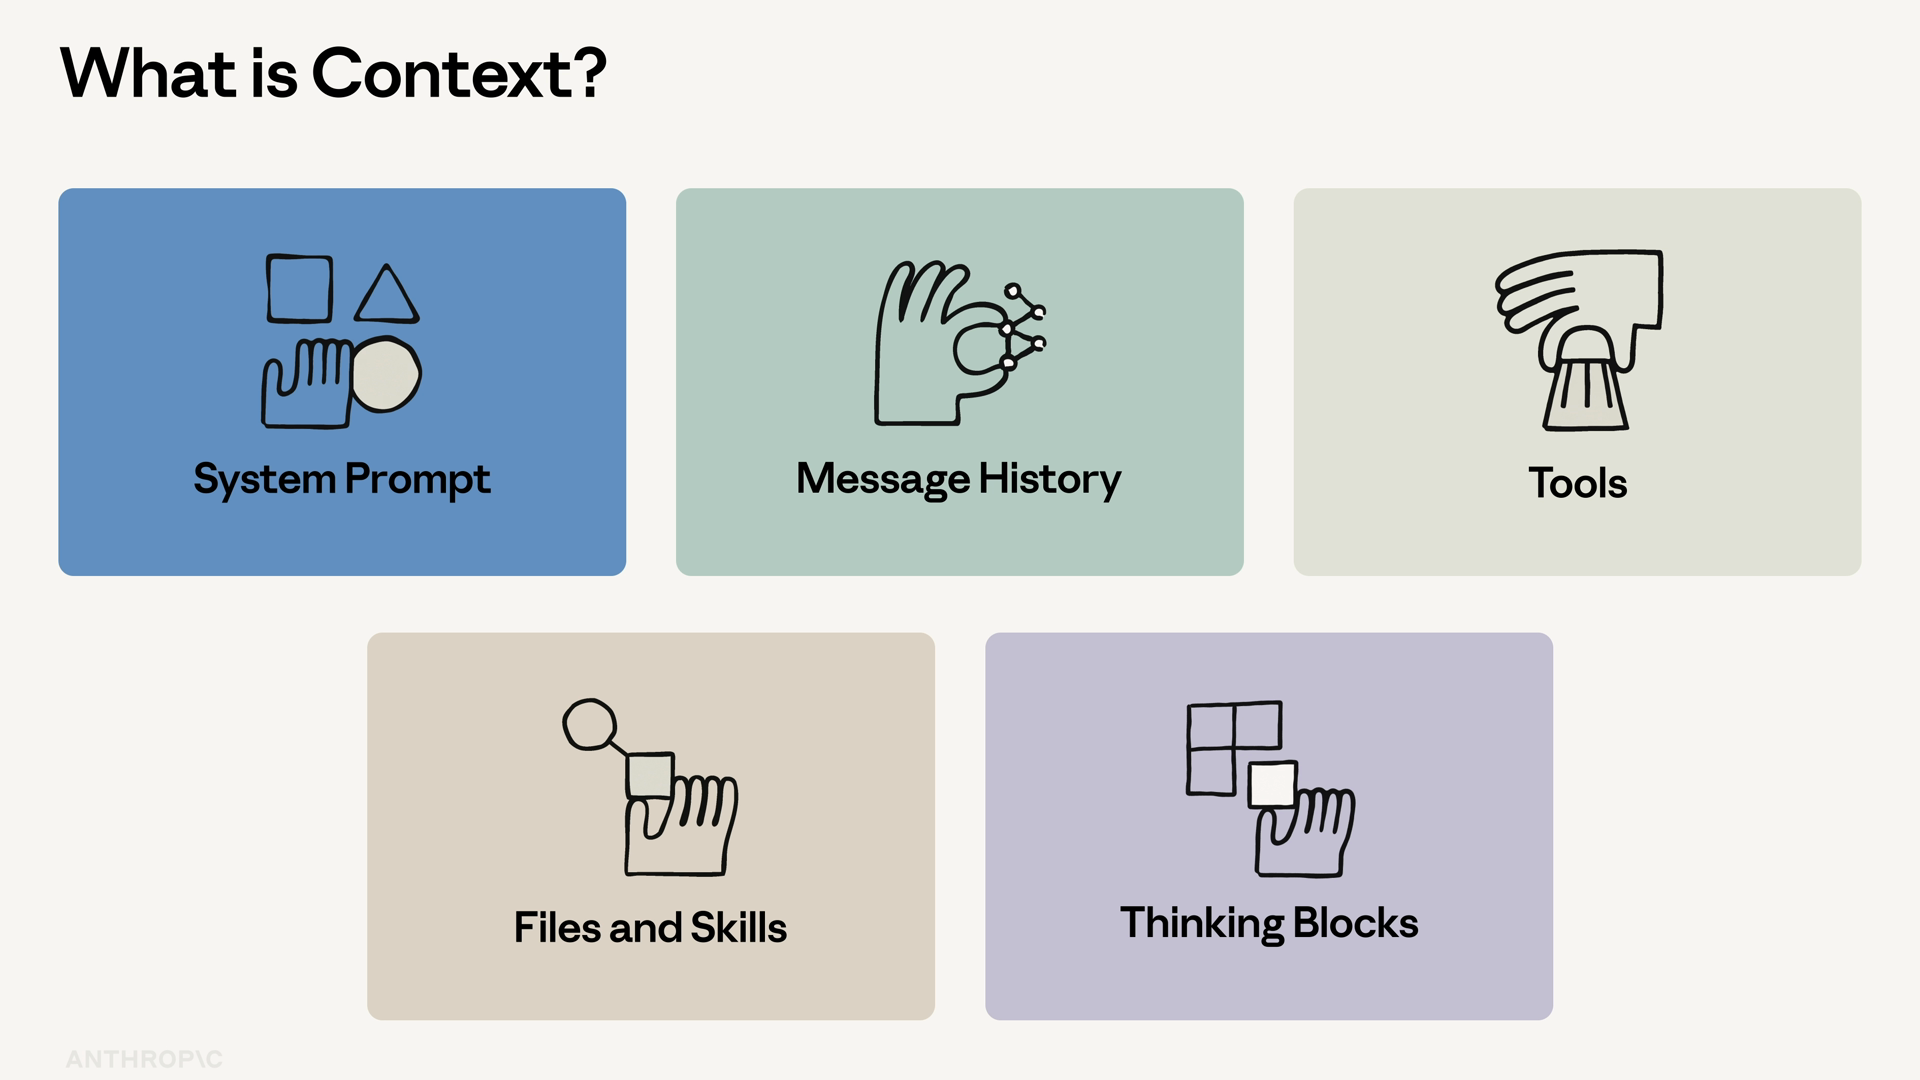
它是每一次API调用的输入。您在输入时为它付费,在输出时也为它付费。而一旦窗口被填满,请求就会失败。
所以目标不是把所有东西都塞进去,而是把正确的东西放进去。
Anthropic发布了四种模式,用于管理长时间运行的智能体中的上下文。其中三种是一流的API功能,一种是设计模式。
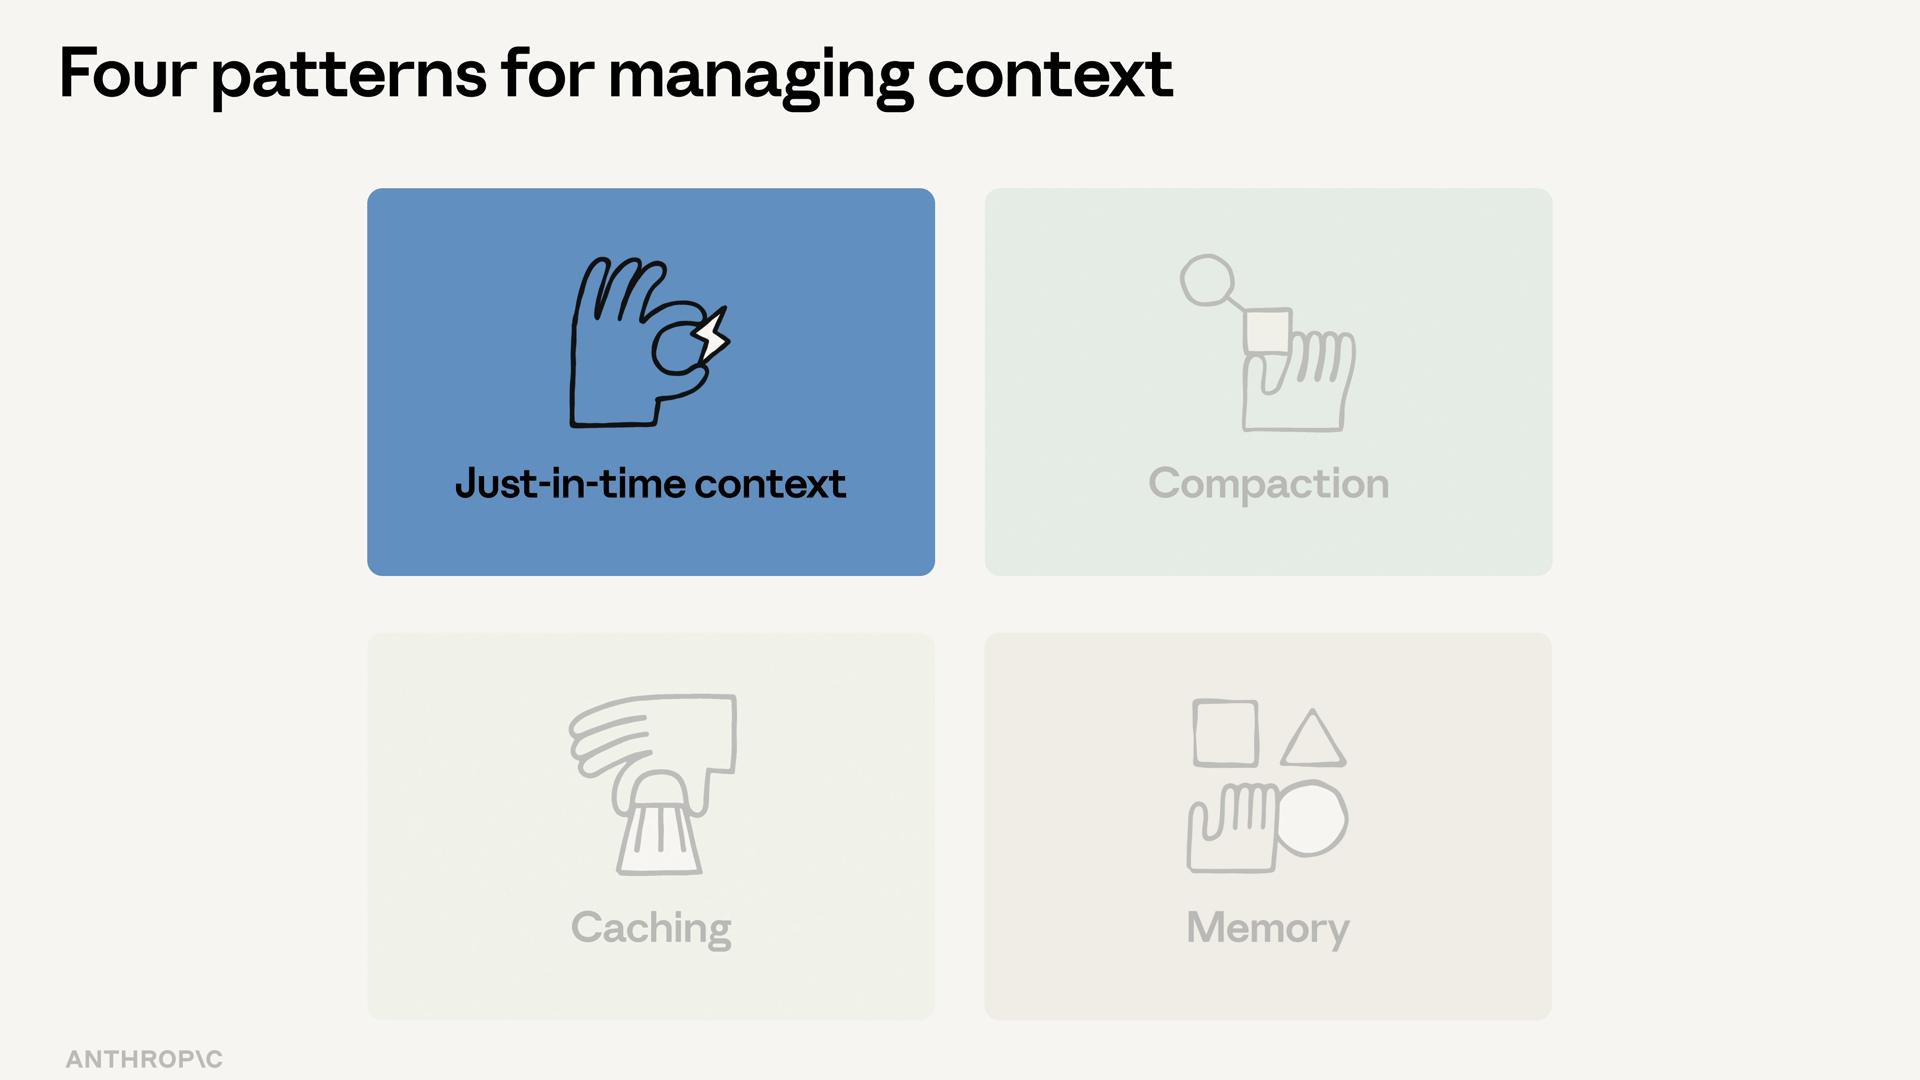
模式一:即时上下文
不要预先加载所有内容。只加载智能体现在需要的内容,并让它在需要时通过工具拉取更多内容。
想象一个合规审查智能体。它不会把整本建筑规范手册塞进系统提示中——而是在需要特定章节时调用lookup_building_code工具。这是四种模式中的设计模式:API中没有任何特殊之处,只是对加载内容和时机做出的刻意选择。
模式二:服务器端压缩
当对话变得很长时,Anthropic的服务器端压缩会将旧的对话轮次总结为一个单独的块。您可以通过在请求中添加一个context_management键来启用此功能,该键包含一个带有类型的编辑:
response = client.beta.messages.create(
    betas=["compact-2026-01-12"],
    model="claude-opus-5",
    max_tokens=1024,
    context_management={
        "edits": [
            {"type": "compact_20260112"}
        ]
    },
    messages=messages,
)
当输入超过触发阈值时,API会自动进行总结。您不必自己跟踪对话长度。
模式三:提示缓存
提示缓存让您可以标记请求中稳定不变的部分——系统提示、工具定义、一份长文档——并在多次调用中以极低的成本重复使用它们。
这笔账比看起来更重要。如果您的系统提示有4,000个令牌,而您每小时调用100次,缓存将决定账单是否可控,还是会招来财务部门的电话。
模式四:记忆工具
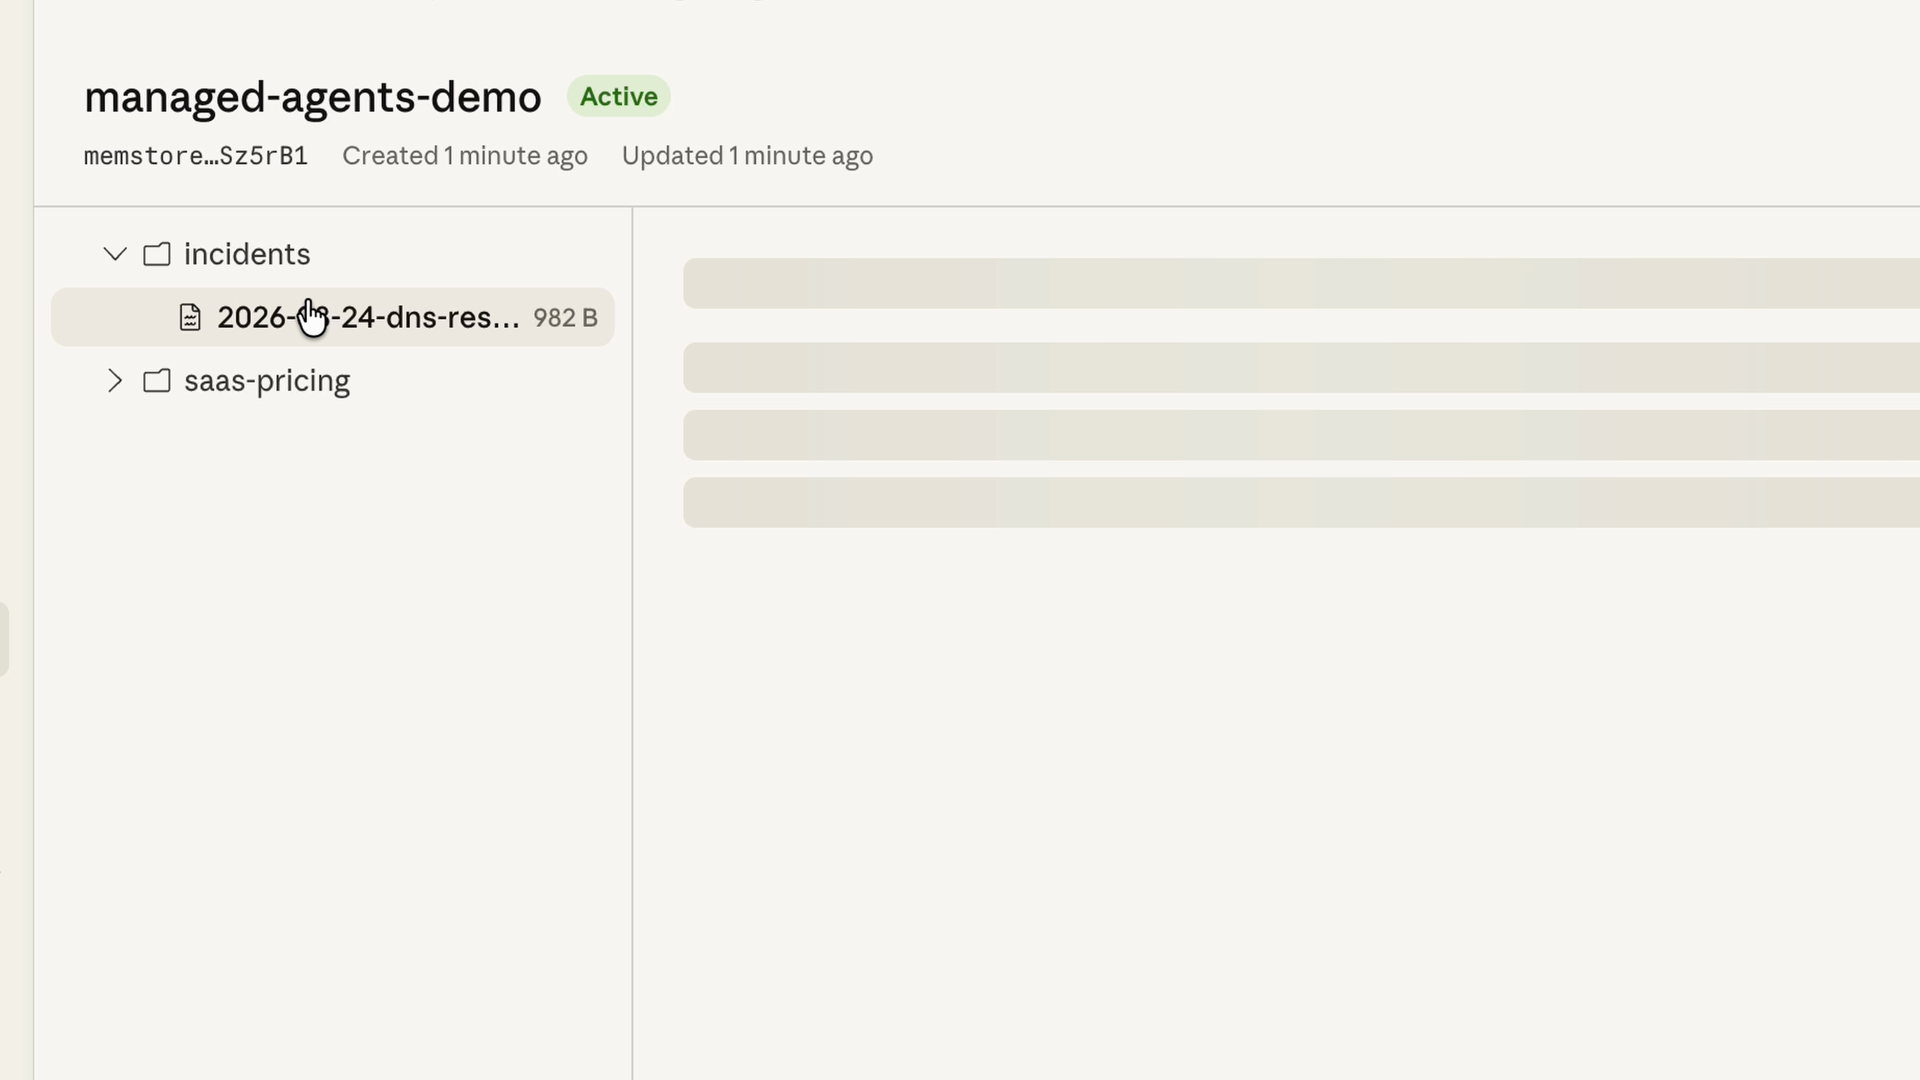
有些上下文需要跨会话保留:用户偏好、智能体的持续记录、上周做出的决定。推荐用于此目的的基本组件是记忆工具。
它的工作方式如下:
- Claude通过工具调用读写一个记忆目录。
- 您在客户端实现存储后端——可以是文件系统、数据库、加密存储,任何您想要的方式。
- Anthropic会自动注入一条系统指令,告诉Claude在开始工作前检查记忆目录。
叠加使用这些模式
在生产应用中,您通常会同时叠加使用全部四种模式。合规审查智能体会缓存其系统提示和工具定义,并通过lookup_building_code即时拉取建筑规范章节。
每种模式处理不同的失败模式:成本、窗口大小、无状态性。选择与您所遇到的问题相匹配的模式。
回顾
- 上下文是Claude在某一轮对话中所看到的一切——它既不是免费的,也不是无限的。一旦窗口被填满,请求就会失败。
- 即时上下文:加载当前所需的内容,让工具拉取其余部分。这是四种模式中的设计模式。
- 服务器端压缩:添加一个
context_management键,当输入超过触发阈值时,API会自动总结旧的对话轮次。 - 提示缓存:标记请求中稳定的部分,并在多次调用中以极低的成本重复使用它们。
- 记忆工具:Claude通过工具调用读写记忆目录;您拥有存储后端,因此上下文可以跨会话保留。
- 四种模式,一个目标。您可以手动搭建它们,也可以使用Claude托管的智能体,它们默认就内置了缓存和压缩功能。