加载中
选择合适的模型
您正在用Claude发布一款应用。您该选择哪个模型?如果默认使用最智能的那个,您的API账单会让您大吃一惊。选择最便宜的那个,输出质量又可能不达标。每个模型都有不同的权衡取舍,选择合适的模型会同时影响质量和成本。
模型层级
Anthropic目前提供四个模型层级,您可以通过API调用中的model参数在它们之间进行选择。
- Claude Fable 是我们迄今为止能力最强的模型——一个位于Opus之上的全新层级,专为您面临的最棘手挑战而打造。它的成本高于Opus,因此请将它留给那些值得为额外能力付费的工作。当前的Fable模型是Claude Fable 5.1(
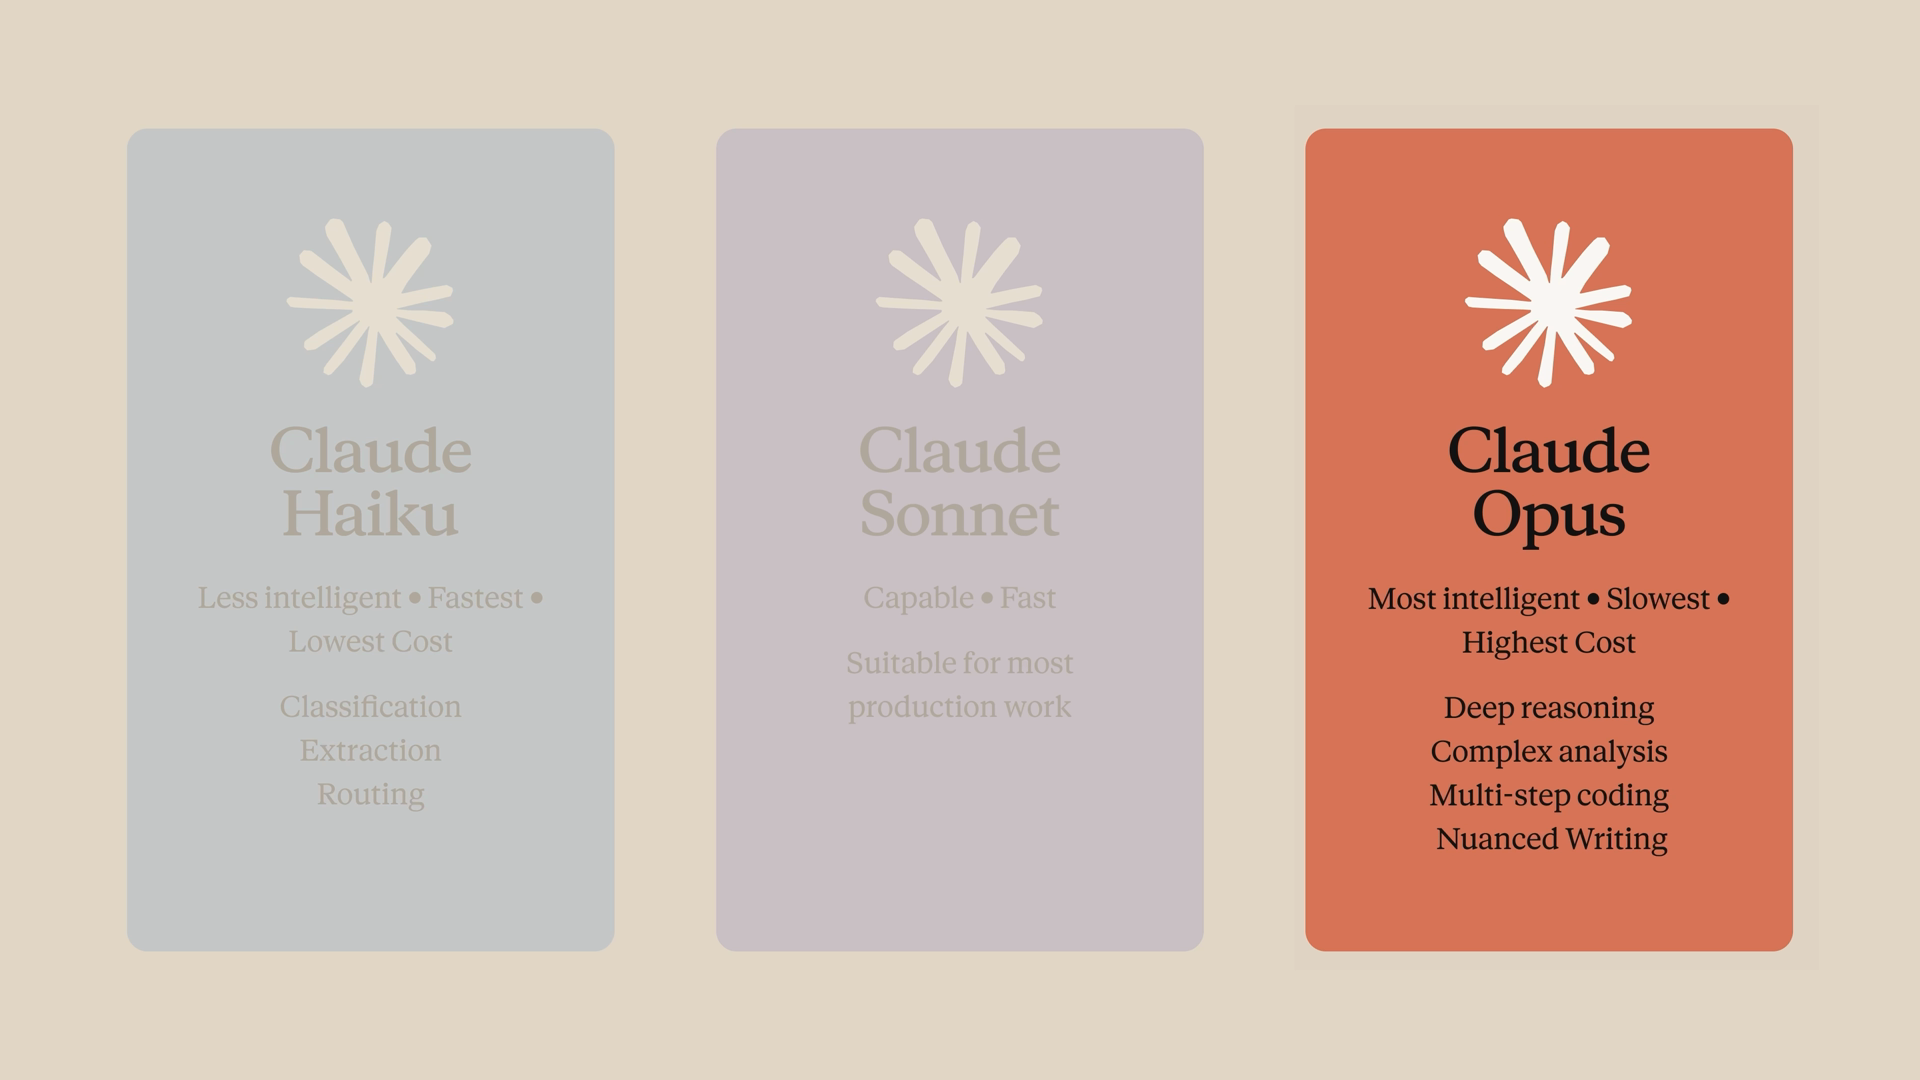
claude-fable-5-1)。 - Claude Opus 是三个核心模型系列中能力最强的,但同时也是三者中速度最慢、成本最高的。请将它用于深度推理、复杂分析、多步骤编码以及需要细致入微的写作场景。当前的Opus模型是Claude Opus 5.5(
claude-opus-5-5)。 - Claude Haiku 速度最快、成本最低,针对速度和成本效率进行了优化,而非追求最高智能水平。请将它用于高容量、低复杂度的工作,例如分类、信息提取和路由。当前的Haiku模型是Claude Haiku 4.5(
claude-haiku-4-5)。 - Claude Sonnet 处于甜蜜点:智能、速度和成本之间的均衡组合,适用于大多数生产环境的工作。当前的Sonnet模型是Claude Sonnet 5(
claude-sonnet-5)。
从简单的评估开始
在编写生产环境代码之前,请先设置一个简单的评估:准备一组示例输入,分别在每个模型上运行,并根据您的使用场景所定义的"良好输出"标准对结果进行评分。您不需要搞得太复杂——从您实际工作负载中抽取20到30个有代表性的示例就足以开始。
然后逐层级往上尝试:
- 首先用Haiku运行您的示例。如果质量达标,您就完成了——而且您刚刚省下了一大笔钱。
- 如果不达标,升级到Sonnet。
- 只有在任务确实需要时,才使用Opus。
并排比较各个层级
让我们实际看看各层级之间的差异,而不只是空谈。我们将相同的提示分别发送给这三个模型,并观察延迟和令牌数量:
python
models = ["claude-haiku-4-5", "claude-sonnet-5", "claude-opus-5-5"]

for model in models:
    response = client.messages.create(
        model=model,
        max_tokens=300,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, response.usage)
这里发生了两件事:
- 循环在每次请求时交换
model字段。相同的提示、相同的最大令牌数——只有模型发生了变化。 response.usage直接从API返回输入和输出令牌数量,这正是您的账单的计算依据。
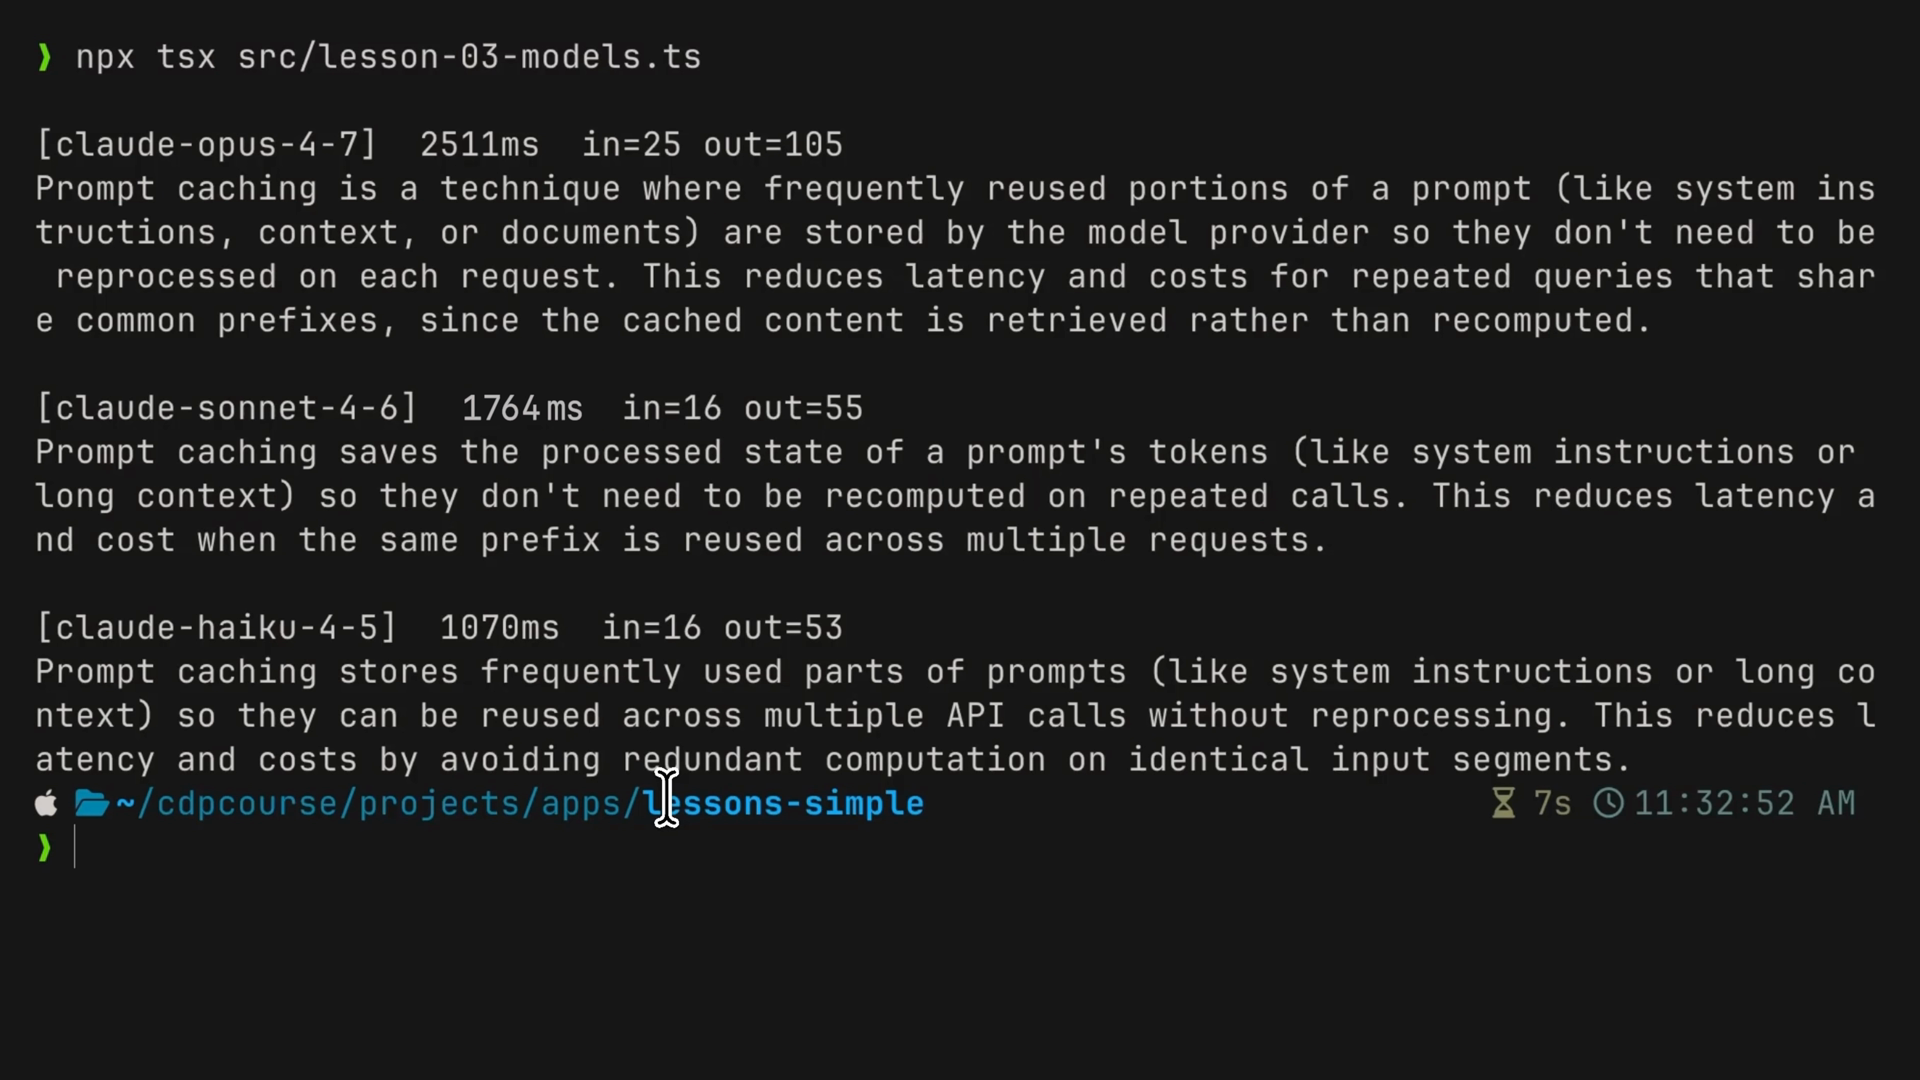
运行一下,您会看到三个模型和三组数字。Opus耗时最长,读起来也最为精致——但对于一个两句话的定义来说,这种精致其实是浪费。Sonnet让文字稍微更简洁一些。而Haiku的响应速度往往不到一秒,给出的两句话答案已经相当不错。对于这类场景来说,它其实完全够用。
这正是关键所在:合适的模型,就是那个您真正愿意用其输出上线的、成本最低的模型。对于一个定义来说,Haiku绰绰有余。而对于起草一份监管回复,您进行同样的比较后,很可能最终会选择Opus。评估的方式每次都是一样的。
将不同工作路由到不同模型
在实际应用中,您会在同一个端点内,将不同类型的工作路由到不同的模型。以一个带有文档处理流程的运营仪表盘为例:
- 每个收到的文件都用Haiku进行分类。
- 客户更新内容用Sonnet起草。
- 只有RFP(招标提案)回复才使用Opus。
一个队列,三个模型,按任务分别选用。
小结
- Anthropic提供四个模型层级:Fable提供目前最高的可用能力,Opus用于处理困难问题,Sonnet用于日常工作,Haiku用于处理大批量任务。
- 在编写生产环境代码之前,先设置一个简单的评估——从您真实的工作负载中抽取20到30个有代表性的示例。
- 从Haiku开始运行评估,逐级向上,并在您真正愿意上线其输出的最便宜模型处停下。
response.usage会报告输入和输出令牌数量,这正是您账单的计算依据。- 在生产环境中,应在同一端点内将不同任务路由到不同模型,而不是用一个模型处理所有事情。