올바른 모델 선택하기
Claude로 앱을 출시하려고 합니다. 어떤 모델을 선택해야 할까요? 가장 똑똑한 모델을 기본으로 선택하면 API 청구서에 놀랄 수도 있습니다. 가장 저렴한 모델을 선택하면 결과물의 품질이 충분하지 않을 수도 있습니다. 각 모델마다 서로 다른 트레이드오프가 있으며, 올바른 모델을 선택하는 것은 품질과 비용 모두에 영향을 미칩니다.
모델 티어
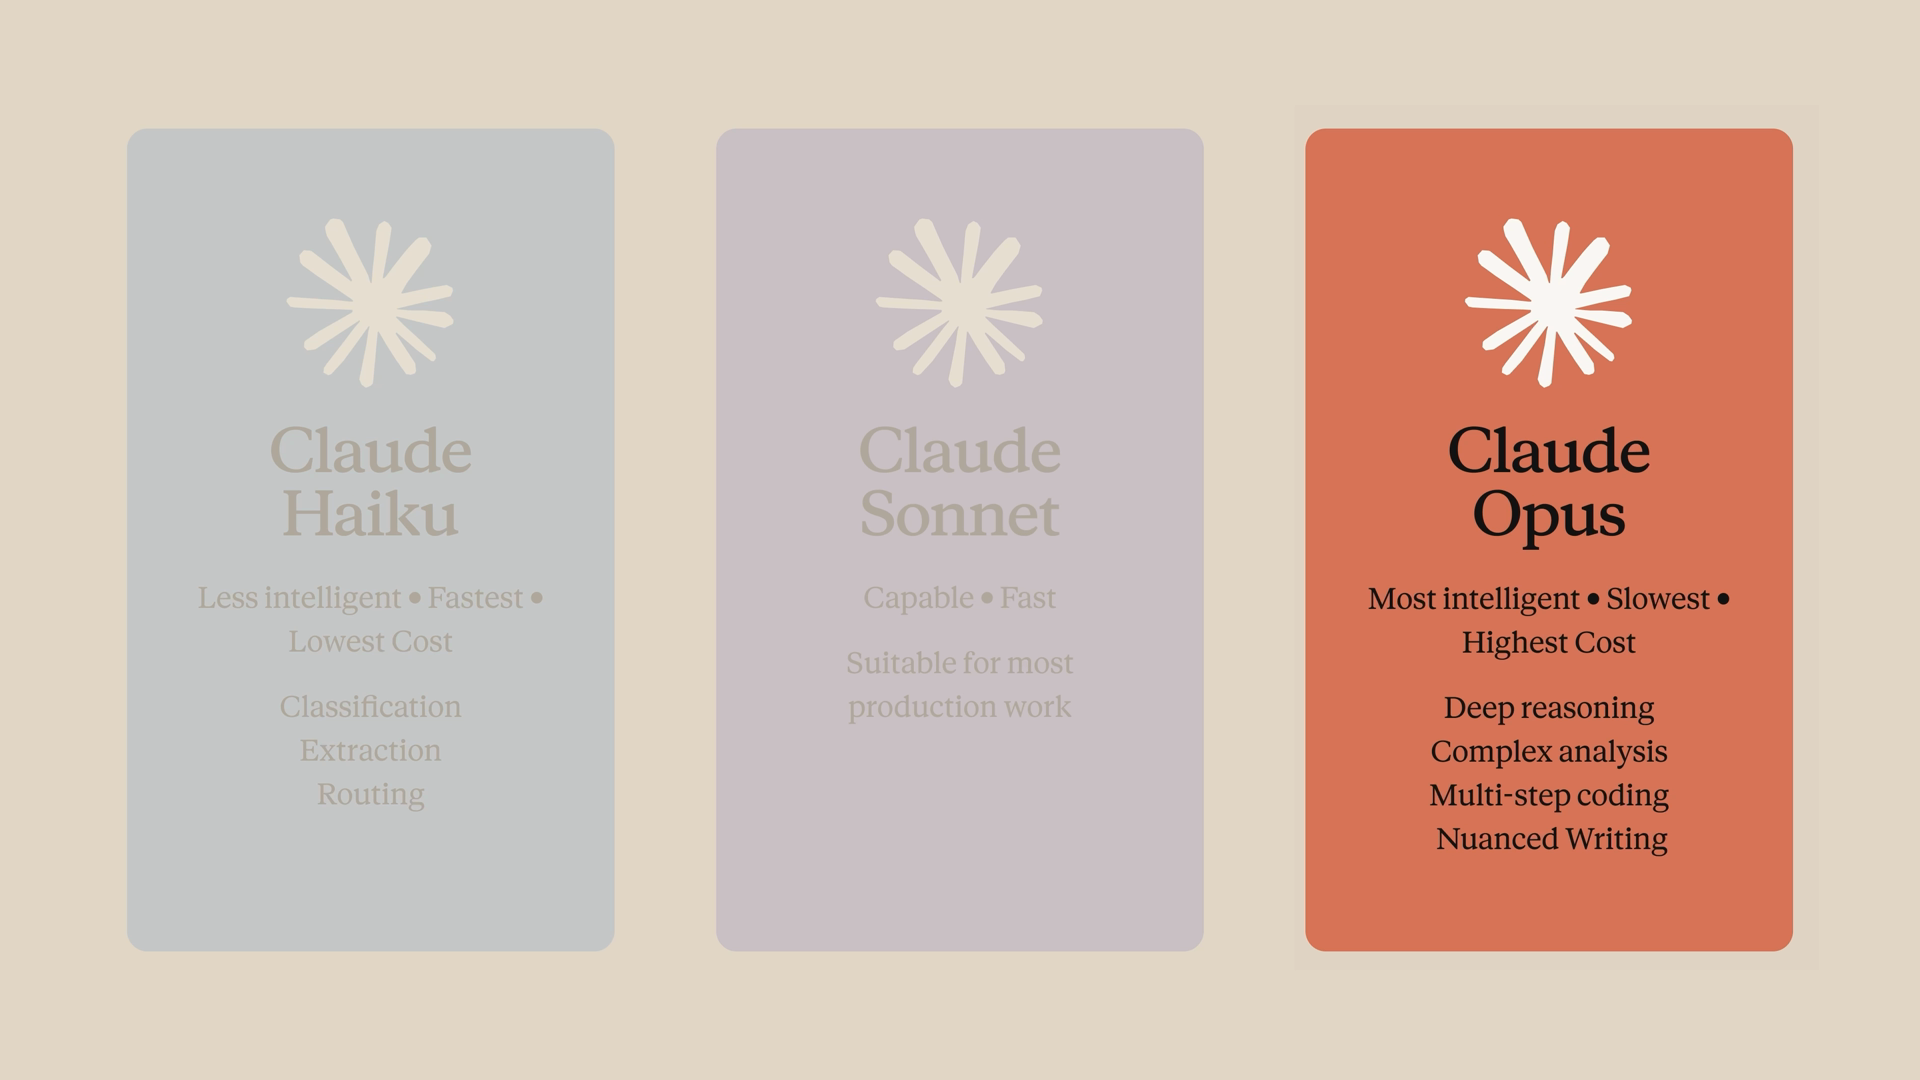
Anthropic은 현재 네 가지 모델 티어를 제공하며, API 호출에서 model 매개변수로 이들 중 선택합니다.
- Claude Fable은 지금까지 가장 뛰어난 기능을 갖춘 모델로, Opus보다 상위에 위치하며 가장 까다로운 과제를 위해 만들어진 새로운 티어입니다. Opus보다 비용이 높으므로, 그만한 비용을 지불할 가치가 있는 작업에만 사용하세요. 현재 Fable 모델은 Claude Fable 5.1(
claude-fable-5-1)입니다. - Claude Opus는 세 가지 핵심 모델 계열 중 가장 뛰어난 성능을 보이지만, 동시에 셋 중 가장 느리고 비용이 가장 높습니다. 심층 추론, 복잡한 분석, 다단계 코딩, 섬세한 글쓰기 작업에 사용하세요. 현재 Opus 모델은 Claude Opus 5.5(
claude-opus-5-5)입니다. - Claude Haiku는 가장 빠르고 비용이 가장 낮으며, 최대한의 지능보다는 속도와 비용 효율성에 최적화되어 있습니다. 분류, 추출, 라우팅과 같이 대용량이면서 복잡도가 낮은 작업에 사용하세요. 현재 Haiku 모델은 Claude Haiku 4.5(
claude-haiku-4-5)입니다. - Claude Sonnet은 지능, 속도, 비용의 균형 잡힌 조합으로 최적의 지점에 위치하며, 대부분의 프로덕션 작업에 잘 맞습니다. 현재 Sonnet 모델은 Claude Sonnet 5(
claude-sonnet-5)입니다.
간단한 평가로 시작하기
프로덕션 코드를 작성하기 전에, 간단한 평가(evaluation)를 구성하세요: 각 모델에 실행해 볼 예시 입력 집합을 만들고, 여러분의 사용 사례에서 좋은 결과물이 무엇인지를 기준으로 점수를 매깁니다. 거창할 필요는 없습니다 — 실제 워크로드에서 가져온 대표적인 예시 20~30개 정도면 시작하기에 충분합니다.
그런 다음 티어를 단계적으로 올려가며 작업합니다:
- 먼저 Haiku로 예시를 실행해 보세요. 품질이 유지된다면 끝입니다 — 그리고 방금 많은 비용을 절약한 셈입니다.
- 그렇지 않다면 Sonnet으로 단계를 올리세요.
- 작업에 필요할 때만 Opus를 사용하세요.
티어를 나란히 비교하기
티어 간의 차이를 말로만 설명하지 말고 직접 확인해 봅시다. 동일한 프롬프트를 세 모델 모두에 보내고 지연 시간과 토큰 수를 살펴보겠습니다:
models = ["claude-haiku-4-5", "claude-sonnet-5", "claude-opus-5-5"]

for model in models:
    response = client.messages.create(
        model=model,
        max_tokens=300,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, response.usage)
여기서 두 가지가 진행되고 있습니다:
- 이 루프는 각 요청에서
model필드를 바꿔가며 실행합니다. 동일한 프롬프트, 동일한 최대 토큰 수 — 모델만 달라집니다. response.usage는 API에서 직접 입력 및 출력 토큰 수를 돌려주며, 이는 청구서 산정 기준이 됩니다.
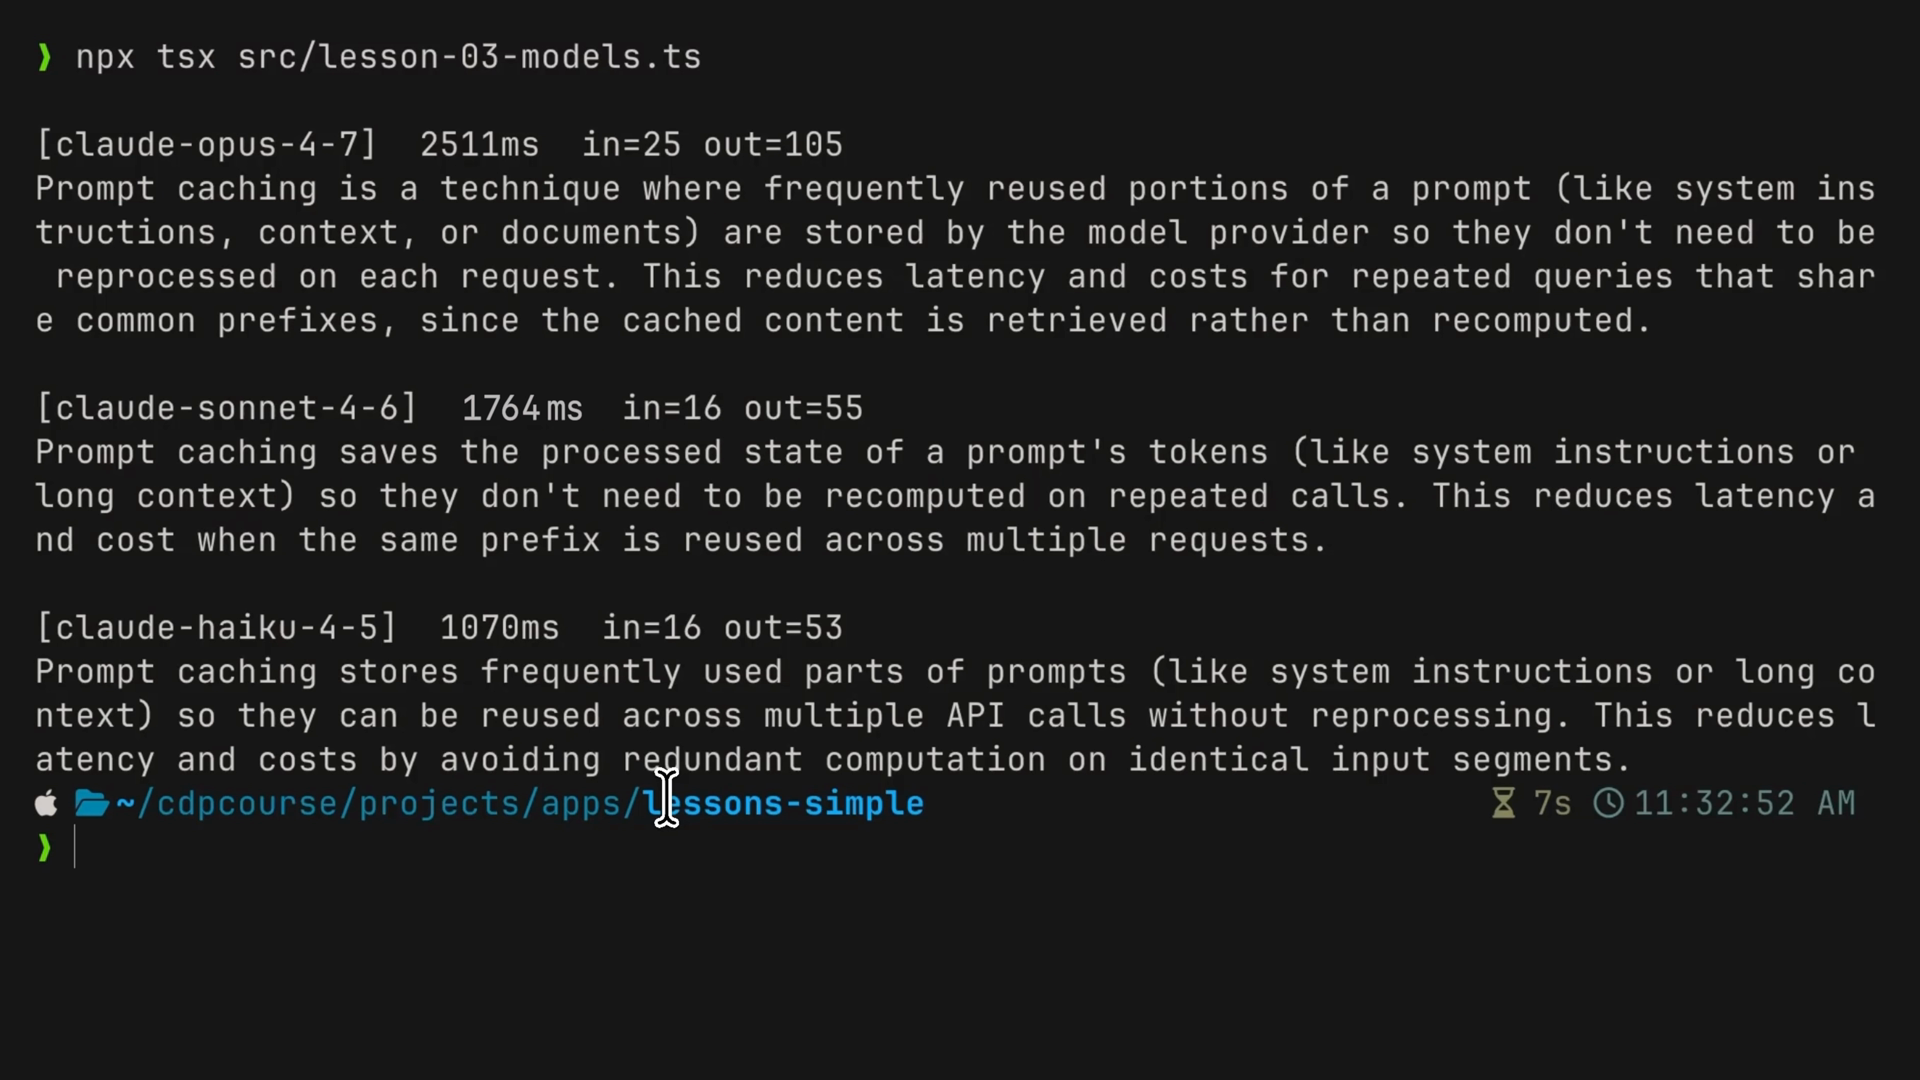
실행해 보면 세 가지 모델과 세 세트의 수치를 확인할 수 있습니다. Opus가 가장 오래 걸리고 가장 세련된 결과물을 만들어내지만 — 두 문장짜리 정의에는 그 정도의 세련됨은 낭비입니다. Sonnet은 문장을 조금 더 다듬어줍니다. 그리고 Haiku는 종종 1초도 안 되어 매우 준수한 두 문장짜리 답변을 내놓습니다. 이런 시나리오에는 사실상 완벽합니다.
그리고 바로 이것이 핵심입니다: 올바른 모델이란 결과물을 실제로 사용해도 될 만한, 가장 저렴한 모델입니다. 정의 작업이라면 Haiku로 충분합니다. 규제 대응 문서를 작성하는 작업이라면, 동일한 비교를 실행해 보면 아마 Opus로 귀결될 것입니다. 평가의 형태는 매번 동일합니다.
서로 다른 작업을 서로 다른 모델로 라우팅하기
실제 앱에서는 동일한 엔드포인트 안에서 서로 다른 종류의 작업을 서로 다른 모델로 라우팅하게 됩니다. 문서 처리 라우트가 있는 운영 대시보드를 예로 들어보겠습니다:
- 들어오는 모든 파일은 Haiku로 분류됩니다.
- 고객 업데이트는 Sonnet으로 초안 작성됩니다.
- RFP 응답만 Opus를 사용합니다.
하나의 큐, 세 개의 모델, 작업별로 선택됩니다.
요약
- Anthropic은 네 가지 모델 티어를 제공합니다: 가능한 최고 수준의 기능을 위한 Fable, 어려운 문제를 위한 Opus, 일상적인 작업을 위한 Sonnet, 대용량 작업을 위한 Haiku입니다.
- 프로덕션 코드를 작성하기 전에 간단한 평가를 구성하세요 — 실제 워크로드에서 가져온 대표적인 예시 20~30개면 됩니다.
- Haiku부터 시작해 위로 올라가며 평가를 실행하고, 결과물을 실제로 사용해도 될 만한 가장 저렴한 모델에서 멈추세요.
response.usage는 입력 및 출력 토큰 수를 보고하며, 이는 청구서 산정의 기준이 됩니다.- 프로덕션에서는 모든 작업에 하나의 모델을 선택하는 대신, 동일한 엔드포인트 안에서 서로 다른 작업을 서로 다른 모델로 라우팅하세요.