맞춤형 프롬프트 평가 워크플로우를 구축하는 것은 견고한 프롬프트를 만드는 것에서 시작하여, 그 성능을 확인하기 위한 테스트 데이터를 생성하는 것으로 이어집니다. AWS 관련 코드를 작성하는 사용자를 돕는 프롬프트에 대한 평가 시스템을 설정하는 과정을 살펴보겠습니다.
목표 설정하기
우리의 프롬프트는 AWS 사용 사례를 위한 세 가지 특정 유형의 출력을 작성하는 데 사용자를 지원해야 합니다:
- Python 코드
- JSON 구성 파일
- 정규 표현식
핵심 요구사항은 사용자가 작업에 대한 도움을 요청할 때, 추가 설명, 헤더, 또는 푸터 없이 이러한 형식 중 하나로 깨끗한 출력을 반환해야 한다는 것입니다.
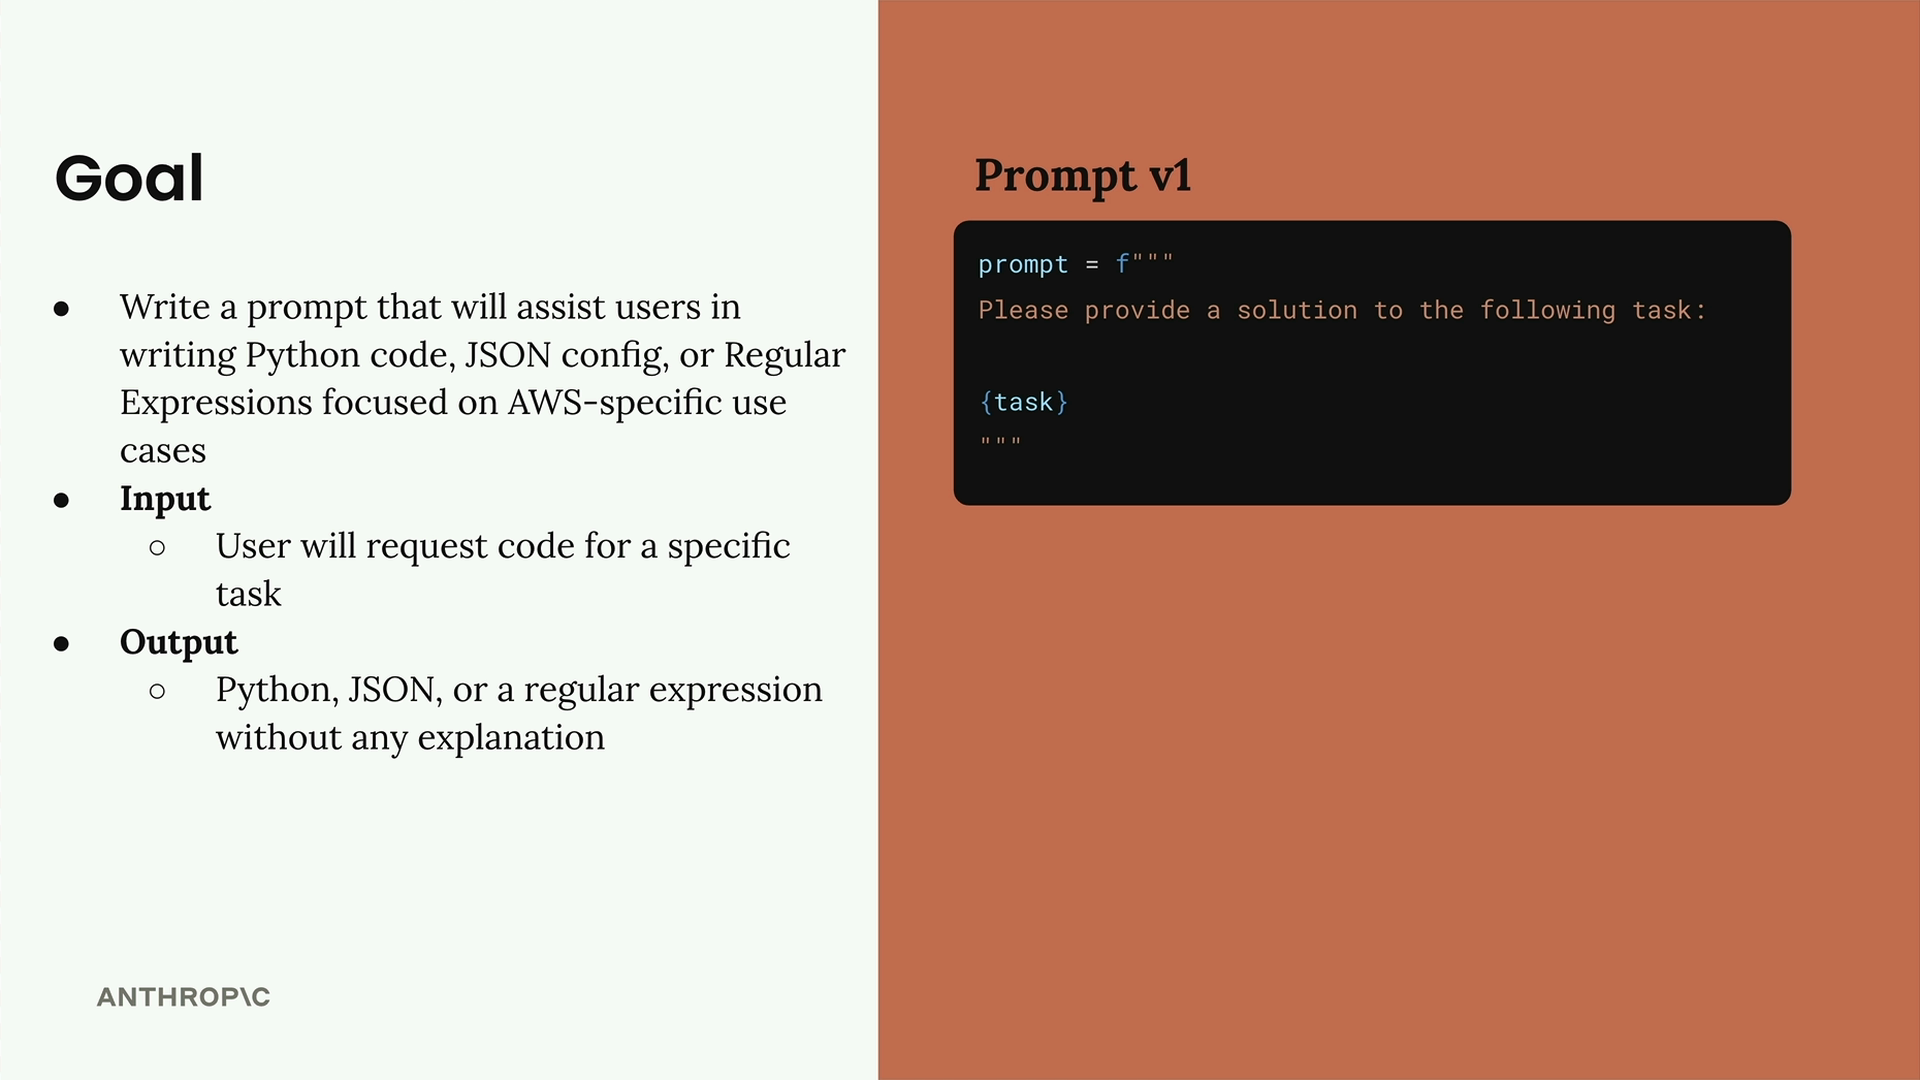
다음은 우리의 시작 프롬프트입니다(버전 1):
prompt = f"""
Please provide a solution to the following task:
{task}
"""
평가 데이터셋 만들기
평가 데이터셋은 우리가 프롬프트에 입력할 입력값들을 포함합니다. 프롬프트와 입력의 각 조합에 대해, 프롬프트를 실행하고 결과를 분석합니다.
우리의 데이터셋은 JSON 객체의 배열이 될 것이며, 각 객체는 Claude가 수행하기를 원하는 작업을 설명하는 "task" 속성을 포함합니다. 이 데이터셋은 직접 만들 수도 있고 Claude를 사용하여 자동으로 생성할 수도 있습니다.
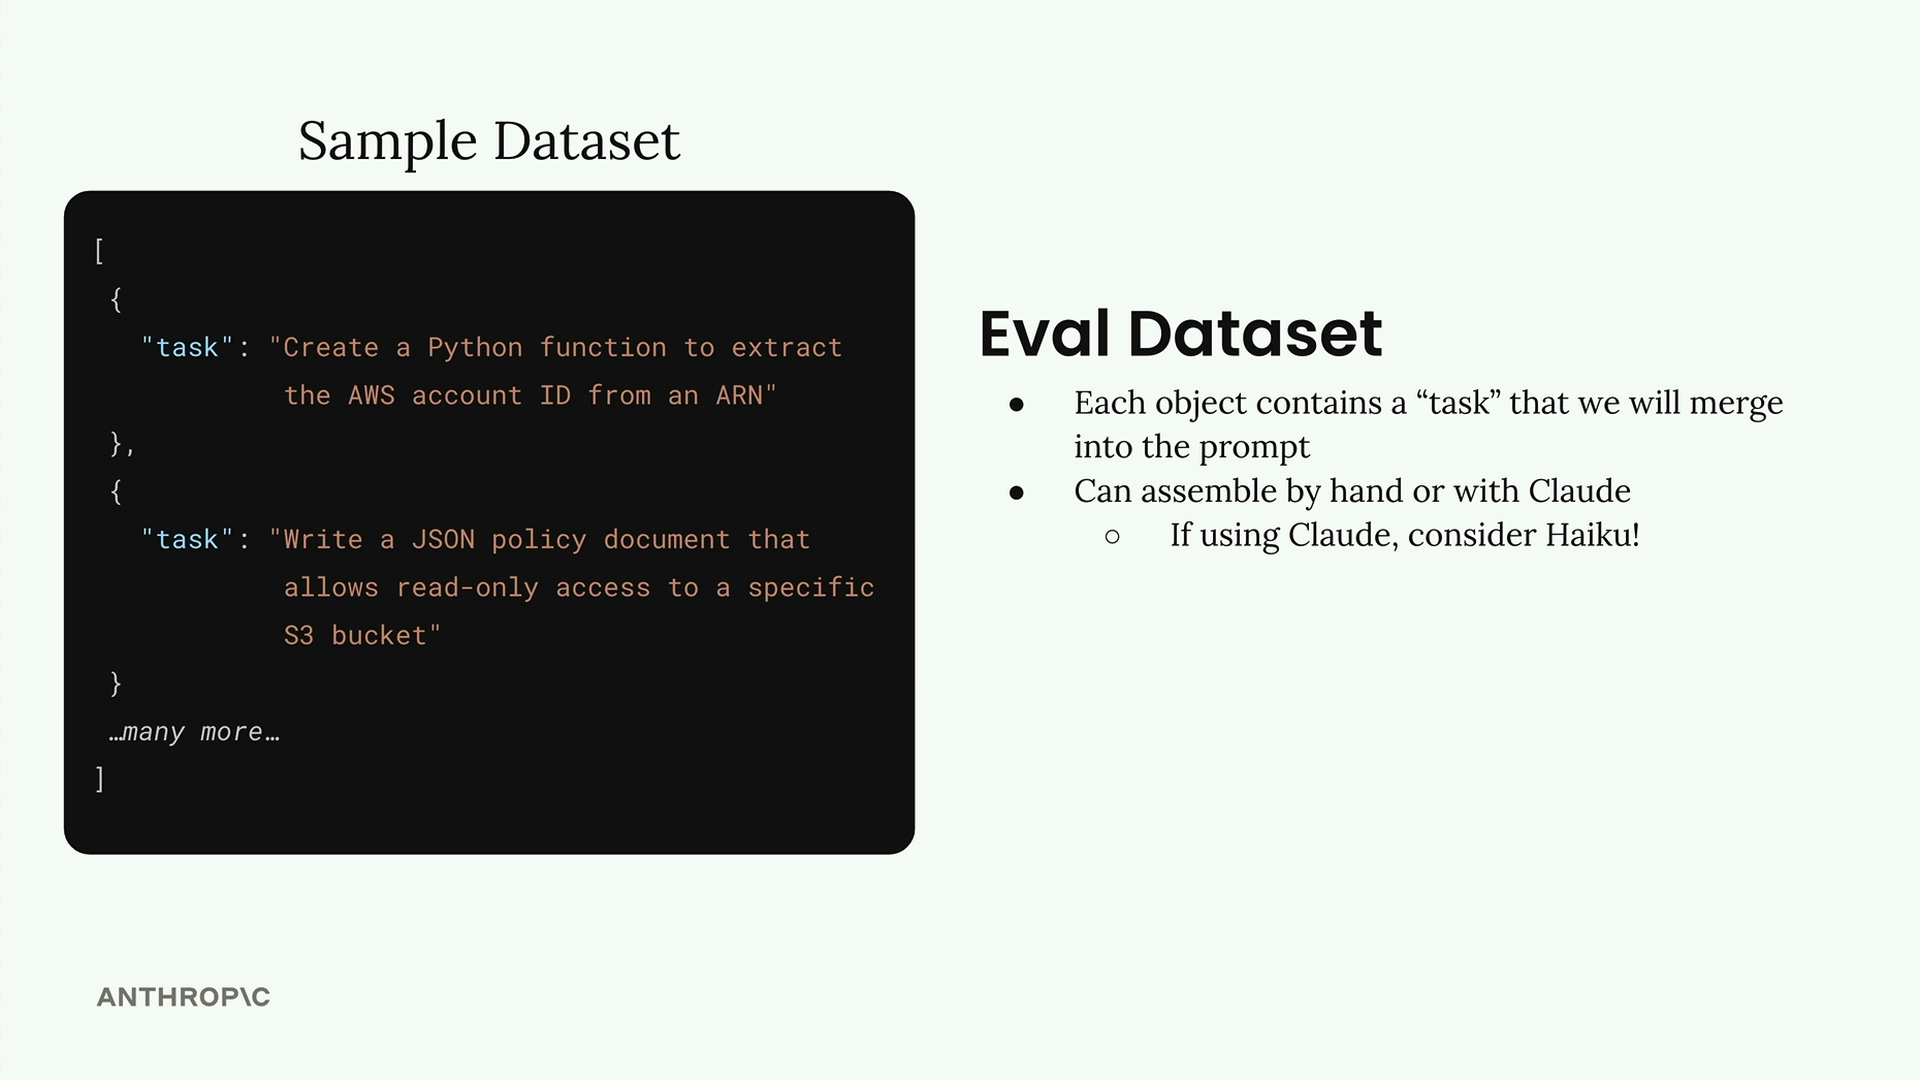
테스트 데이터를 생성하는 것이므로, 전체 Claude 모델 대신 Haiku와 같은 더 빠른 모델을 사용할 좋은 기회입니다.
코드로 테스트 데이터 생성하기
테스트 데이터셋을 자동으로 생성하는 함수를 만들어 보겠습니다. 먼저, Claude와 작업하기 위한 헬퍼 함수가 필요합니다:
def add_user_message(messages, text):
    user_message = {"role": "user", "content": text}
    messages.append(user_message)

def add_assistant_message(messages, text):
    assistant_message = {"role": "assistant", "content": text}
    messages.append(assistant_message)

def chat(messages, system=None, temperature=1.0, stop_sequences=[]):
    params = {
        "model": model,
        "max_tokens": 1000,
        "messages": messages,
        "temperature": temperature
    }
    if system:
        params["system"] = system
    if stop_sequences:
        params["stop_sequences"] = stop_sequences

    response = client.messages.create(**params)
    return response.content[0].text
이제 데이터셋 생성 함수를 만들어 보겠습니다:
def generate_dataset():
    prompt = """
Generate an evaluation dataset for a prompt evaluation. The dataset will be used to evaluate prompts that generate Python, JSON, or Regex specifically for AWS-related tasks. Generate an array of JSON objects, each representing task that requires Python, JSON, or a Regex to complete.

Example output:
```json
[
  \{
    "task": "Description of task",
  \},
  ...additional
]
```

* Focus on tasks that can be solved by writing a single Python function, a single JSON object, or a single regex
* Focus on tasks that do not require writing much code

Please generate 3 objects.
"""
JSON 응답을 올바르게 파싱하기 위해, 프리필링과 정지 시퀀스를 사용하겠습니다:
    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
데이터셋 생성 테스트하기
함수를 실행하여 어떤 종류의 테스트 케이스가 나오는지 확인해 보겠습니다:
dataset = generate_dataset()
print(dataset)
이는 목표 출력을 다루는 세 가지 다른 테스트 케이스를 반환해야 합니다 - Python 함수, JSON 구성, 그리고 AWS 관련 작업을 위한 정규 표현식입니다.
데이터셋 저장하기
데이터셋을 확보한 후에는, 평가 시 나중에 쉽게 불러올 수 있도록 파일에 저장하겠습니다:
with open('dataset.json', 'w') as f:
    json.dump(dataset, f, indent=2)
이렇게 하면 노트북과 같은 디렉터리에 dataset.json 파일이 생성되며, 프롬프트 평가를 위해 준비된 작업 목록이 포함됩니다.
이러한 기반을 마련함으로써, 이제 다양한 유형의 AWS 관련 코딩 작업에서 프롬프트가 얼마나 잘 수행되는지 평가하기 위한 테스트 데이터를 생성하는 체계적인 방법을 갖게 되었습니다.