Gestion du contexte
Chaque requête que vous envoyez à Claude dispose d'une fenêtre de contexte. Un million de tokens semble beaucoup, mais cela s'épuise plus vite qu'on ne le pense une fois que vous déployez un véritable agent. C'est là qu'intervient la gestion du contexte : c'est ce qui vous permet de rester dans les limites de la fenêtre sans perdre ce qui compte.
Ce qui compte comme contexte
Le contexte, c'est tout ce que Claude voit à un tour donné :
- L'invite système
- L'historique des messages
- Les définitions d'outils et les résultats d'outils
- Les fichiers joints et les Compétences
- Les blocs de réflexion
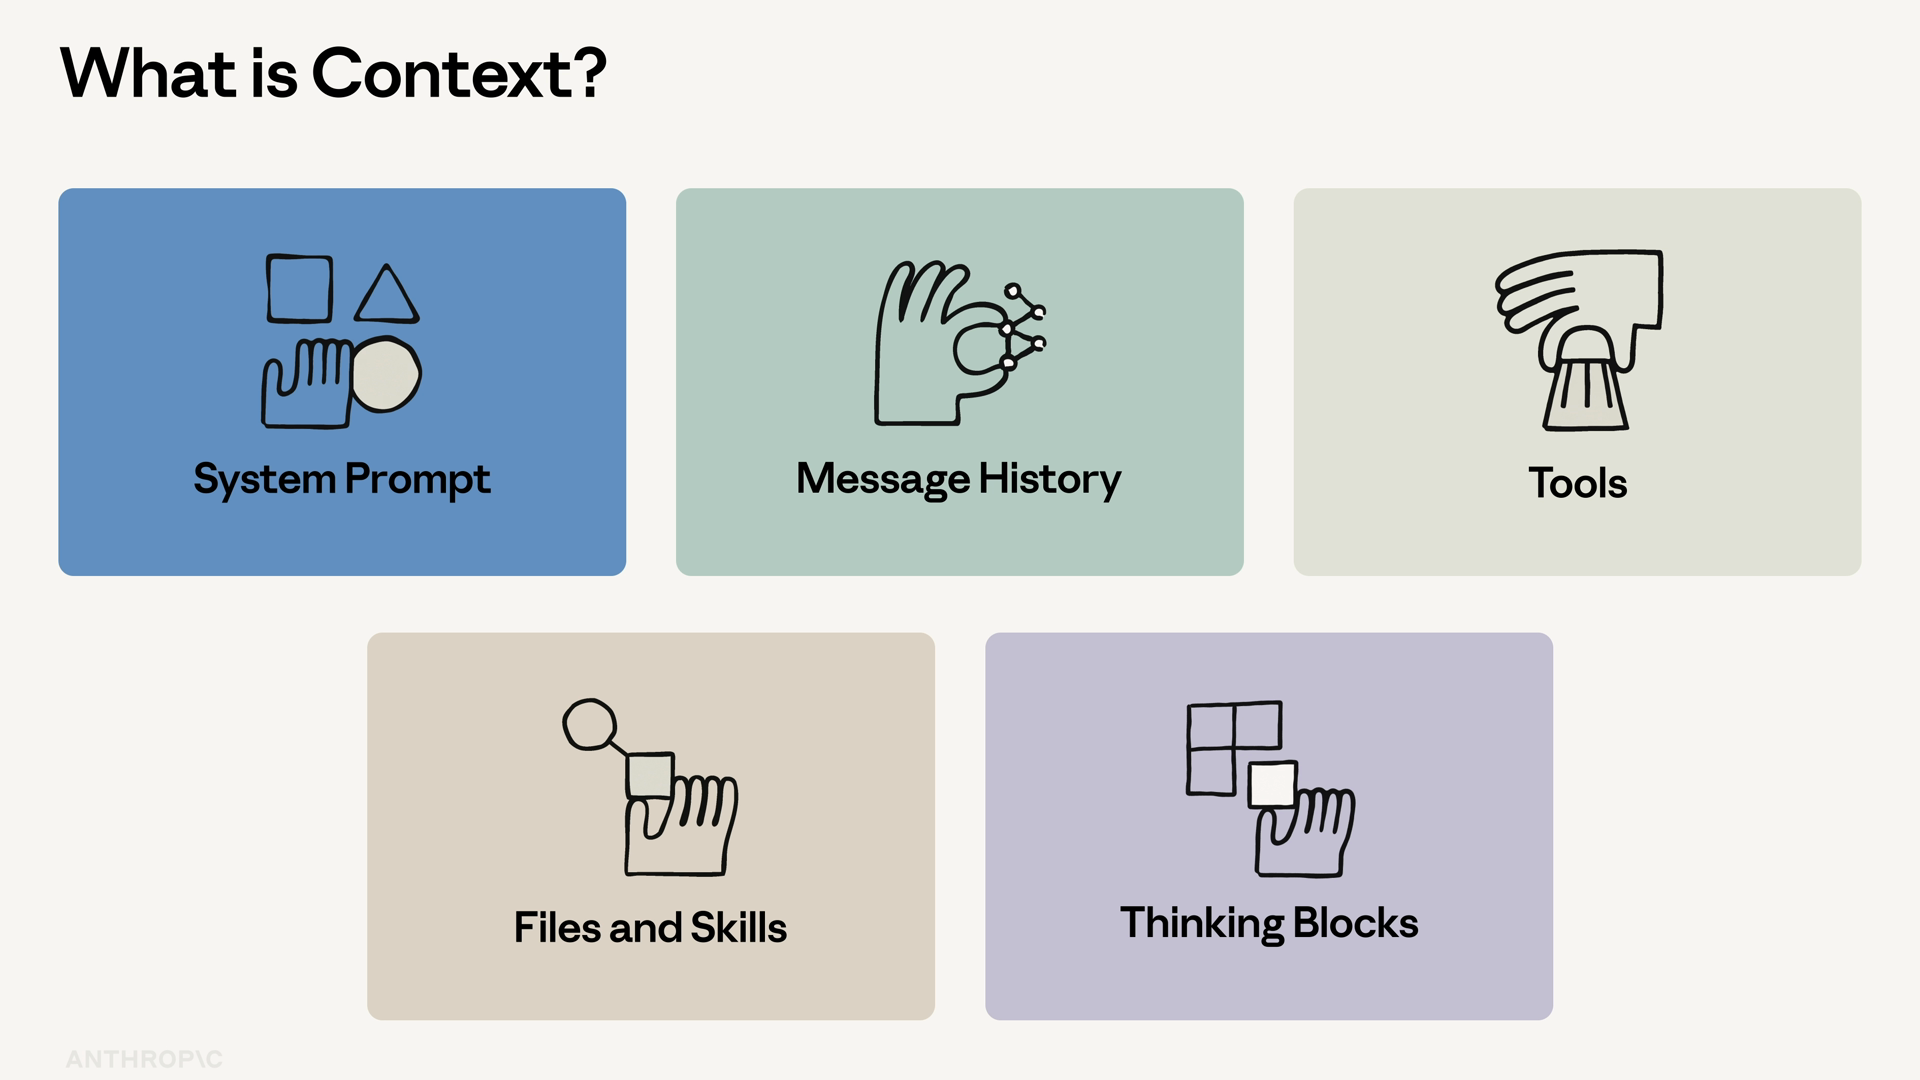
C'est l'entrée de chaque appel API. Vous payez pour cela à l'entrée, et vous payez pour cela à la sortie. Et une fois la fenêtre pleine, la requête échoue.
L'objectif n'est donc pas de tout faire entrer. L'objectif est de faire entrer les bonnes choses.
Anthropic publie quatre modèles pour gérer le contexte dans les agents de longue durée. Trois sont des fonctionnalités API de premier ordre, et un est un modèle de conception.
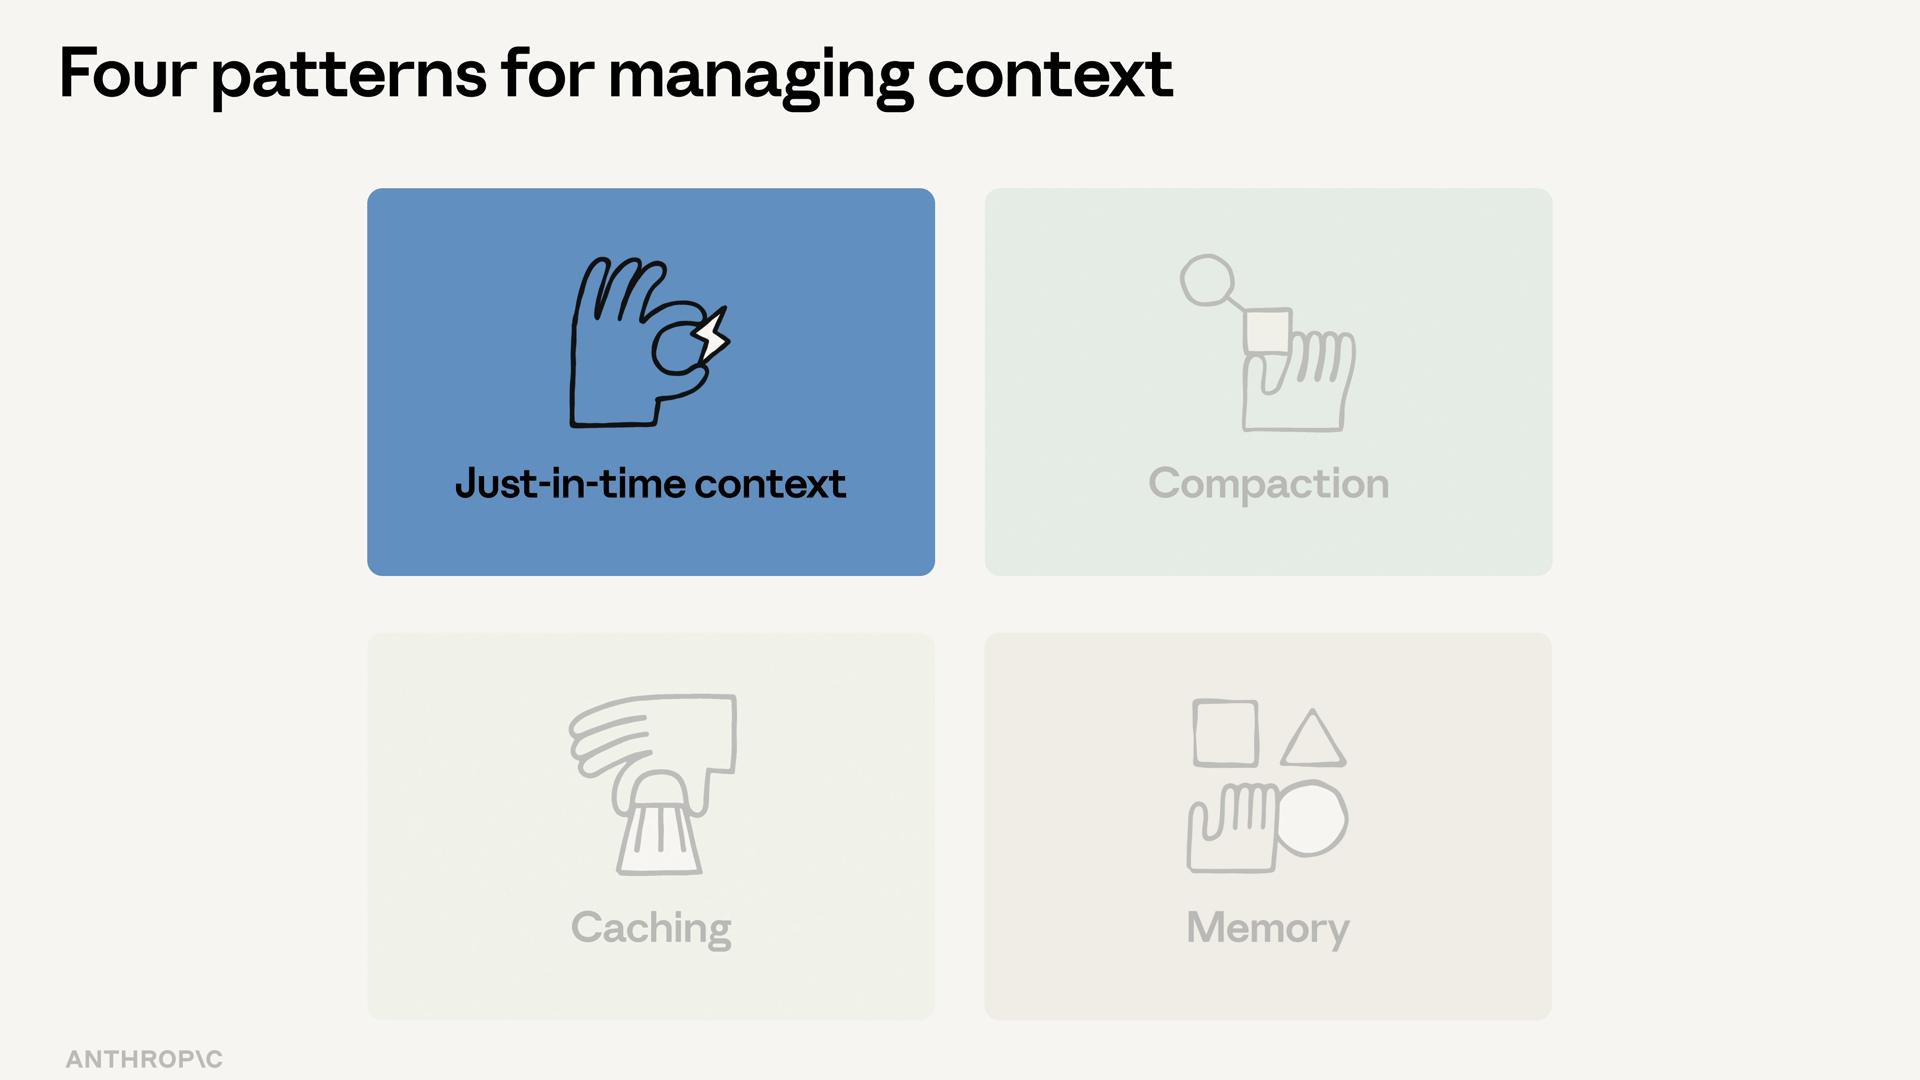
Modèle 1 : Contexte juste-à-temps
Ne chargez pas tout en amont. Chargez ce dont l'agent a besoin maintenant, et laissez-le récupérer davantage via des outils lorsqu'il le demande.
Pensez à un agent de révision de conformité. Il ne reçoit pas l'intégralité du code du bâtiment fourré dans son invite système — il appelle un outil lookup_building_code lorsqu'il a besoin d'une section spécifique. C'est le modèle de conception parmi les quatre : rien de spécial dans l'API, juste un choix délibéré sur ce que vous chargez et quand.
Modèle 2 : Compaction côté serveur
Lorsqu'une conversation s'allonge, la compaction côté serveur d'Anthropic résume les anciens tours en un seul bloc. Vous y adhérez en ajoutant une clé context_management à votre requête, contenant une modification avec un type :
response = client.beta.messages.create(
    betas=["compact-2026-01-12"],
    model="claude-opus-5",
    max_tokens=1024,
    context_management={
        "edits": [
            {"type": "compact_20260112"}
        ]
    },
    messages=messages,
)
L'API résume automatiquement lorsque l'entrée dépasse le seuil de déclenchement. Vous n'avez pas besoin de suivre vous-même la longueur de la conversation.
Modèle 3 : Mise en cache des prompts
La mise en cache des prompts vous permet de marquer les parties stables d'une requête — l'invite système, les définitions d'outils, un long document — et de les réutiliser à travers les appels pour une fraction du coût.
Le calcul compte plus qu'il n'y paraît. Si votre invite système compte 4 000 tokens et que vous l'appelez 100 fois par heure, la mise en cache fait la différence entre une facture gérable et un appel téléphonique de la part des finances.
Modèle 4 : L'outil de mémoire
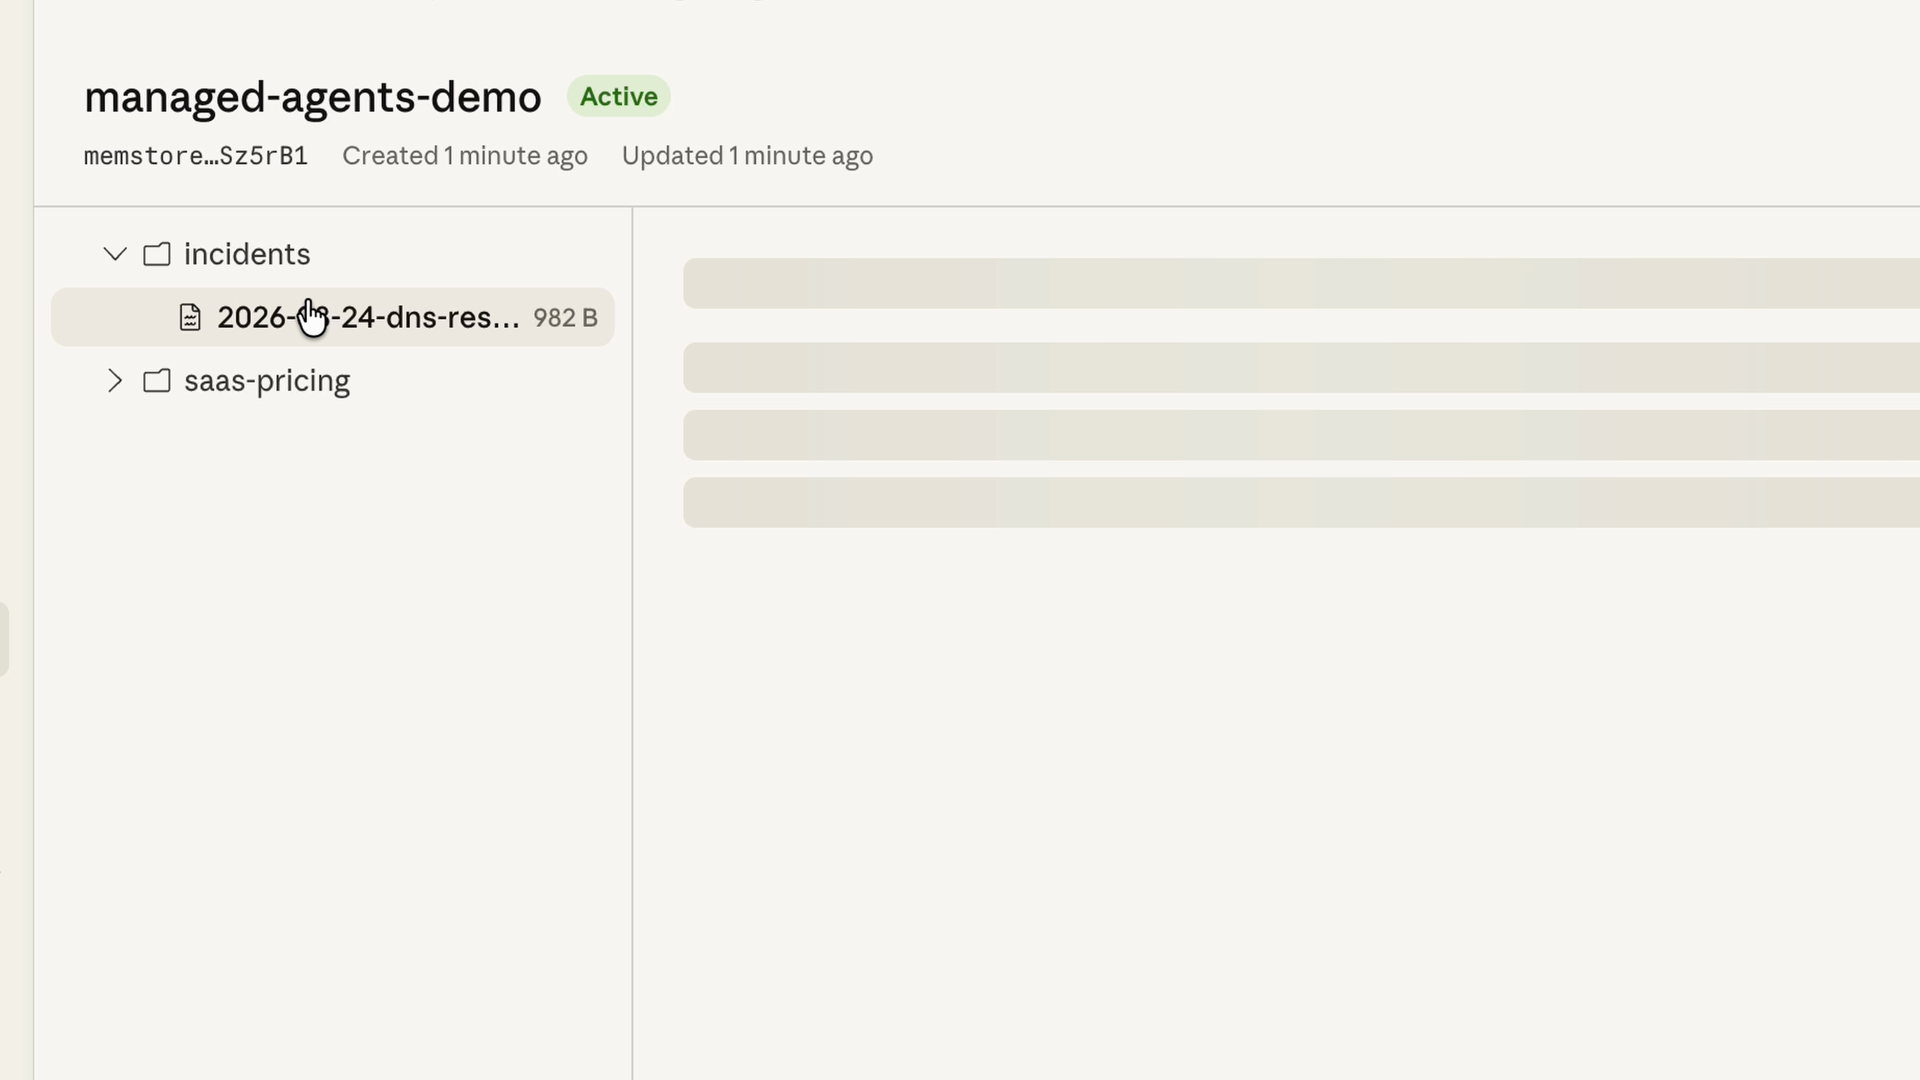
Certains contextes doivent survivre entre les sessions : les préférences de l'utilisateur, les notes courantes de l'agent, ce qui a été décidé la semaine dernière. La primitive recommandée pour cela est l'outil de mémoire.
Voici comment cela fonctionne :
- Claude lit et écrit dans un répertoire de mémoire via des appels d'outils.
- Vous implémentez le backend de stockage côté client — un système de fichiers, une base de données, un stockage chiffré, ce que vous voulez.
- Anthropic injecte automatiquement une instruction système indiquant à Claude de vérifier le répertoire de mémoire avant de commencer le travail.
Superposer les modèles
Dans une application de production, vous superposerez généralement les quatre à la fois. L'agent de révision de conformité met en cache son invite système et ses définitions d'outils, et récupère les sections du code du bâtiment juste à temps via lookup_building_code.
Chaque modèle gère un mode de défaillance différent : coût, taille de la fenêtre, absence d'état. Choisissez ceux qui correspondent à ce qui pose problème pour vous.
Récapitulatif
- Le contexte, c'est tout ce que Claude voit à un tour — et ce n'est ni gratuit ni infini. Une fois la fenêtre pleine, la requête échoue.
- Contexte juste-à-temps : chargez ce qui est nécessaire maintenant, laissez les outils récupérer le reste. C'est le modèle de conception parmi les quatre.
- Compaction côté serveur : ajoutez une clé
context_management, et l'API résume automatiquement les anciens tours lorsque l'entrée dépasse le seuil de déclenchement. - Mise en cache des prompts : marquez les parties stables de la requête et réutilisez-les à travers les appels pour une fraction du coût.
- L'outil de mémoire : Claude lit et écrit dans un répertoire de mémoire via des appels d'outils ; vous possédez le backend de stockage, donc le contexte survit entre les sessions.
- Quatre modèles, un seul objectif. Configurez-les vous-même, ou utilisez les agents gérés par Claude, qui sont livrés avec la mise en cache et la compaction activées par défaut.