Choisir le bon modèle
Vous déployez une application avec Claude. Quel modèle choisissez-vous ? Si vous optez par défaut pour le plus intelligent, votre facture API vous surprendra. Choisissez le moins cher, et le résultat pourrait ne pas être à la hauteur. Chaque modèle présente des compromis différents, et choisir le bon modèle affecte à la fois la qualité et le coût.
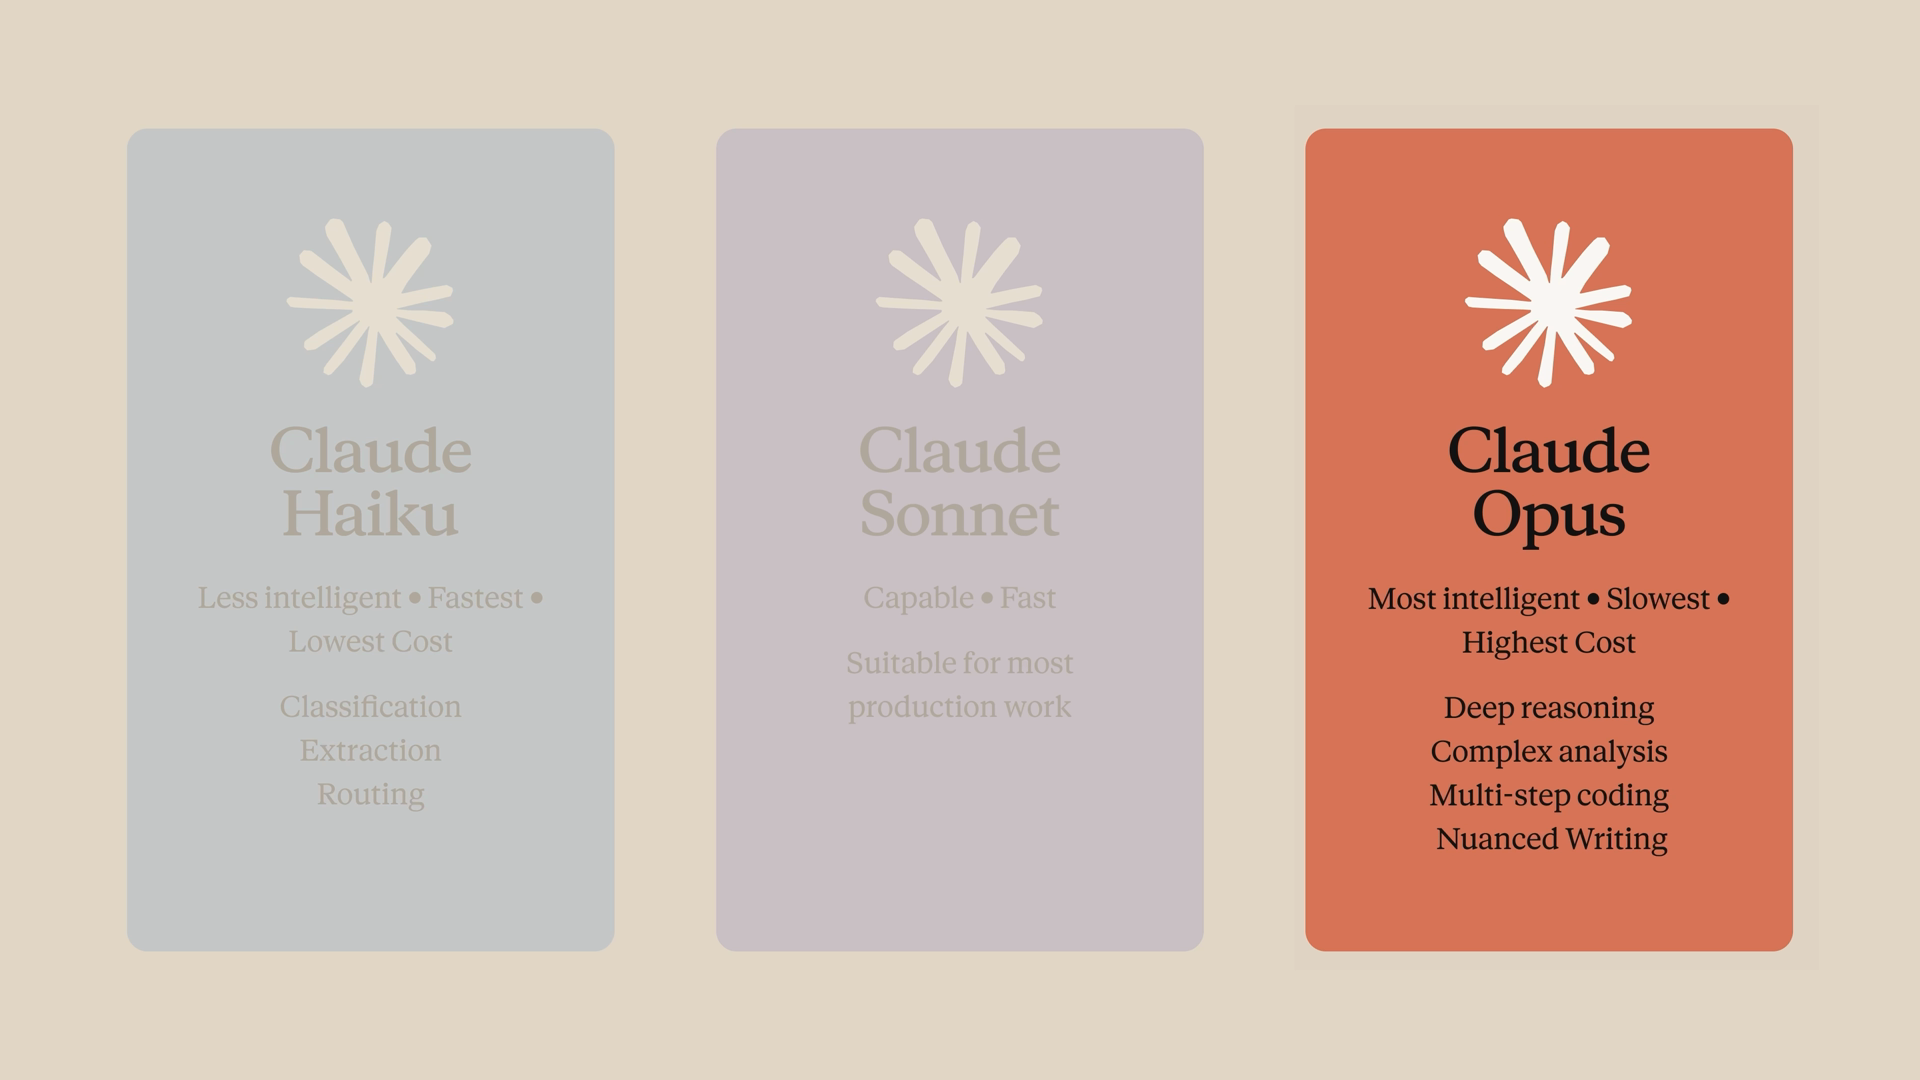
Les niveaux de modèles
Anthropic propose actuellement quatre niveaux de modèles, et vous choisissez entre eux à l'aide du paramètre model dans votre appel API.
- Claude Fable est notre modèle le plus performant à ce jour — un nouveau niveau qui se situe au-dessus d'Opus, conçu pour vos défis les plus exigeants. Il coûte plus cher qu'Opus, réservez-le donc aux tâches pour lesquelles cette capacité supplémentaire vaut la dépense. Le modèle Fable actuel est Claude Fable 5.1 (
claude-fable-5-1). - Claude Opus est le plus performant des trois familles de modèles principales, mais aussi le plus lent et le plus coûteux des trois. Utilisez-le pour le raisonnement approfondi, l'analyse complexe, le codage en plusieurs étapes et la rédaction nuancée. Le modèle Opus actuel est Claude Opus 5.5 (
claude-opus-5-5). - Claude Haiku est le plus rapide et le moins coûteux, optimisé pour la rapidité et l'efficacité des coûts plutôt que pour une intelligence maximale. Utilisez-le pour les tâches à volume élevé et à faible complexité, comme la classification, l'extraction et le routage. Le modèle Haiku actuel est Claude Haiku 4.5 (
claude-haiku-4-5). - Claude Sonnet se situe dans la zone idéale : une combinaison équilibrée d'intelligence, de rapidité et de coût qui convient bien à la plupart des tâches en production. Le modèle Sonnet actuel est Claude Sonnet 5 (
claude-sonnet-5).
Commencez par une évaluation simple
Avant d'écrire du code de production, mettez en place une évaluation simple : un ensemble d'exemples d'entrées que vous faites passer par chaque modèle et que vous notez en fonction de ce que signifie un bon résultat pour votre cas d'usage. Vous n'avez pas besoin de quelque chose de sophistiqué — 20 ou 30 exemples représentatifs de votre charge de travail réelle suffisent pour commencer.
Ensuite, progressez dans les niveaux :
- Faites d'abord passer vos exemples par Haiku. Si la qualité tient la route, vous avez terminé — et vous venez d'économiser beaucoup d'argent.
- Si ce n'est pas le cas, passez à Sonnet.
- Ne faites appel à Opus que lorsque la tâche l'exige.
Comparer les niveaux côte à côte
Voyons la différence entre les niveaux, plutôt que d'en parler simplement. Nous allons envoyer la même requête aux trois modèles et observer la latence et le nombre de jetons :
models = ["claude-haiku-4-5", "claude-sonnet-5", "claude-opus-5-5"]

for model in models:
    response = client.messages.create(
        model=model,
        max_tokens=300,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, response.usage)
Deux choses se produisent ici :
- La boucle modifie le champ
modelà chaque requête. Même requête, même nombre maximal de jetons — seul le modèle change. response.usagevous renvoie directement les jetons d'entrée et de sortie depuis l'API, qui sont la base du calcul de votre facture.
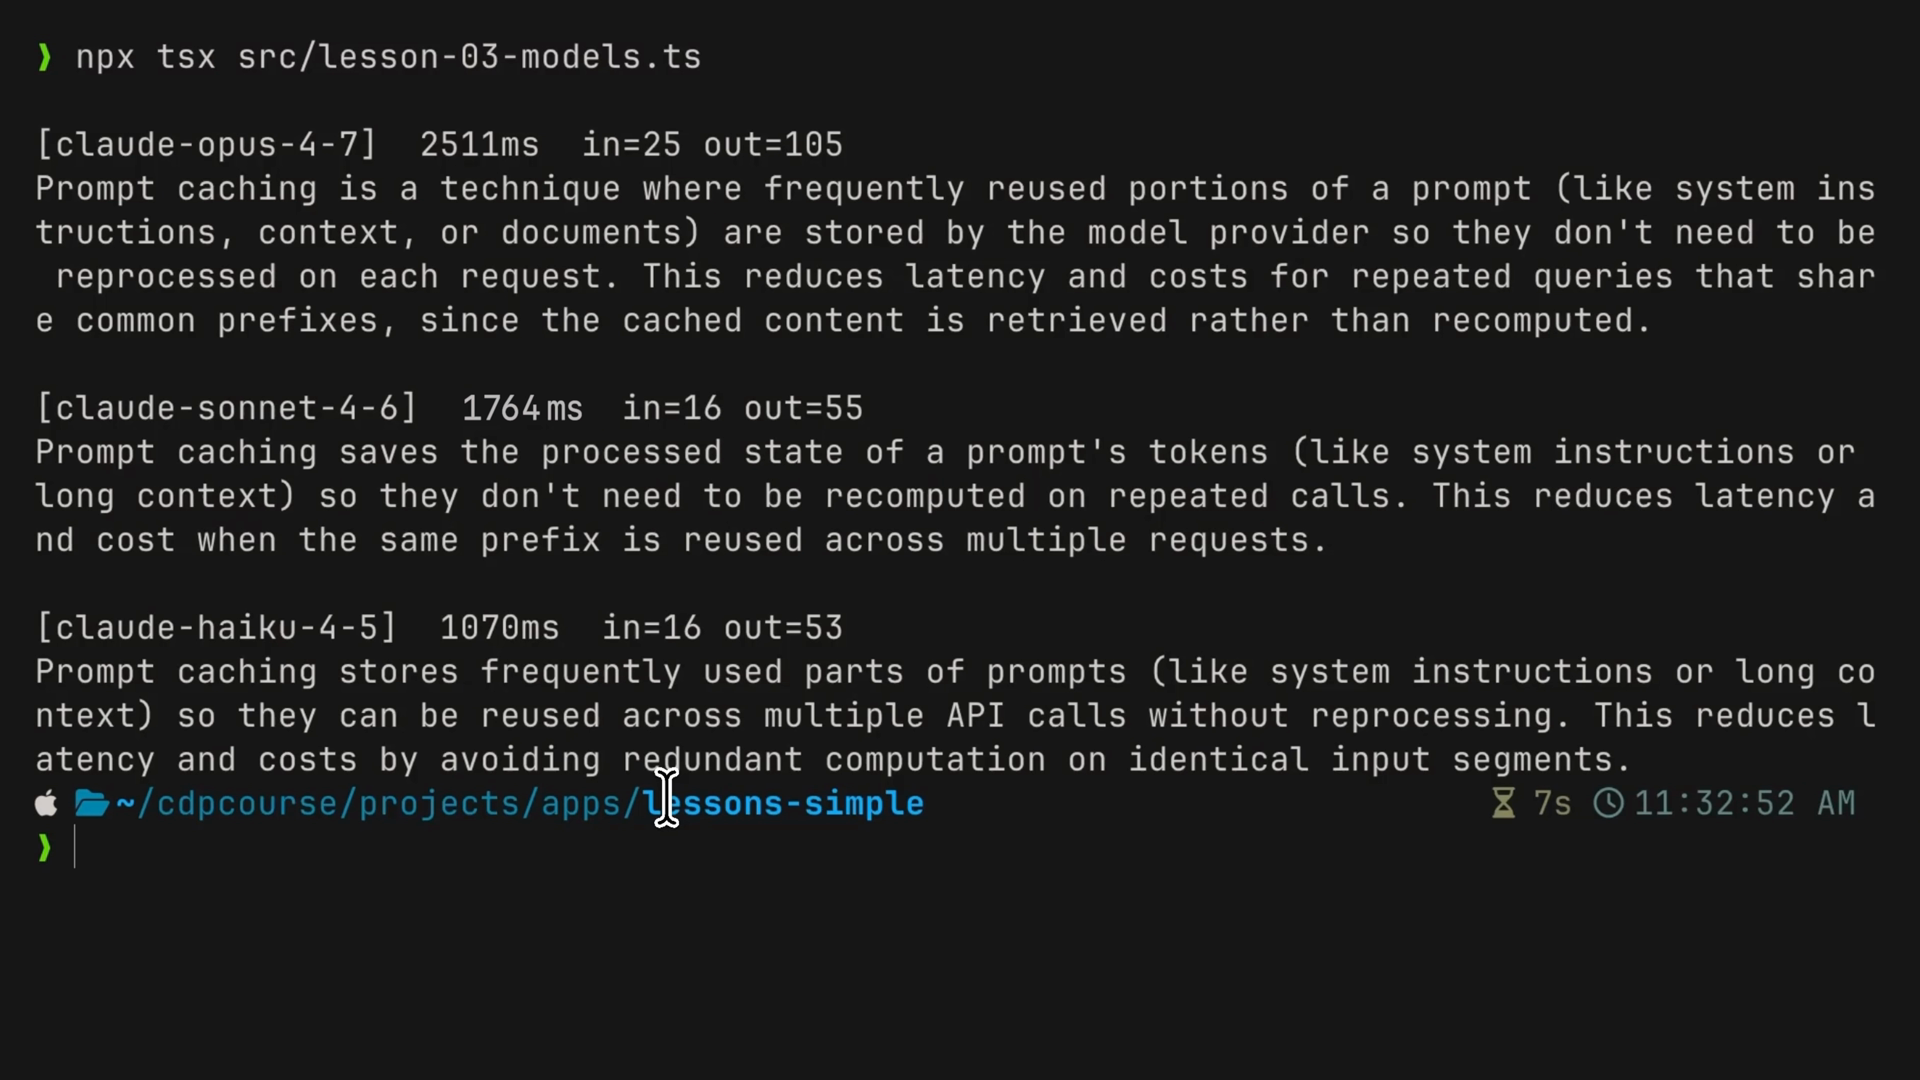
Exécutez-le et vous verrez trois modèles et trois séries de chiffres. Opus prend le plus de temps et offre la rédaction la plus soignée — mais pour une définition en deux phrases, ce raffinement est gaspillé. Sonnet affine un peu l'écriture. Et Haiku répond, souvent en moins d'une seconde, avec une réponse en deux phrases très compétente. Honnêtement, c'est parfait pour ce genre de scénario.
Et c'est bien là tout l'intérêt : le bon modèle est le moins cher dont vous accepteriez réellement de livrer le résultat. Pour une définition, Haiku suffit amplement. Pour rédiger une réponse réglementaire, vous effectueriez la même comparaison et vous vous retrouveriez probablement avec Opus. L'évaluation garde toujours la même forme.
Acheminer différents travaux vers différents modèles
Dans une application réelle, vous acheminez différents types de travaux vers différents modèles au sein du même point de terminaison. Prenons l'exemple d'un tableau de bord opérationnel doté d'une route de traitement de documents :
- Chaque fichier entrant est classé avec Haiku.
- Les mises à jour destinées aux clients sont rédigées avec Sonnet.
- Seules les réponses aux appels d'offres font appel à Opus.
Une seule file d'attente, trois modèles, choisis selon la tâche.
Récapitulatif
- Anthropic propose quatre niveaux de modèles : Fable pour la capacité la plus élevée disponible, Opus pour les problèmes difficiles, Sonnet pour le travail quotidien, et Haiku pour le volume.
- Mettez en place une évaluation simple — 20 ou 30 exemples représentatifs de votre charge de travail réelle — avant d'écrire du code de production.
- Exécutez l'évaluation en partant de Haiku et arrêtez-vous au modèle le moins cher dont vous accepteriez réellement de livrer le résultat.
response.usageindique les jetons d'entrée et de sortie, qui constituent la base de votre facture.- En production, acheminez différentes tâches vers différents modèles au sein du même point de terminaison plutôt que de choisir un seul modèle pour tout.