取樣(Sampling)讓伺服器能夠透過已連接的 MCP 用戶端存取像 Claude 這樣的語言模型。伺服器不會直接呼叫 Claude,而是請求用戶端代表它進行呼叫。這將文字生成的責任與成本從伺服器轉移到了用戶端。
取樣所解決的問題
想像您有一個 MCP 伺服器,其中有一個研究工具可以從 Wikipedia 擷取資訊。在收集完所有資料後,您需要將其摘要成一份連貫的報告。您有兩個選項:
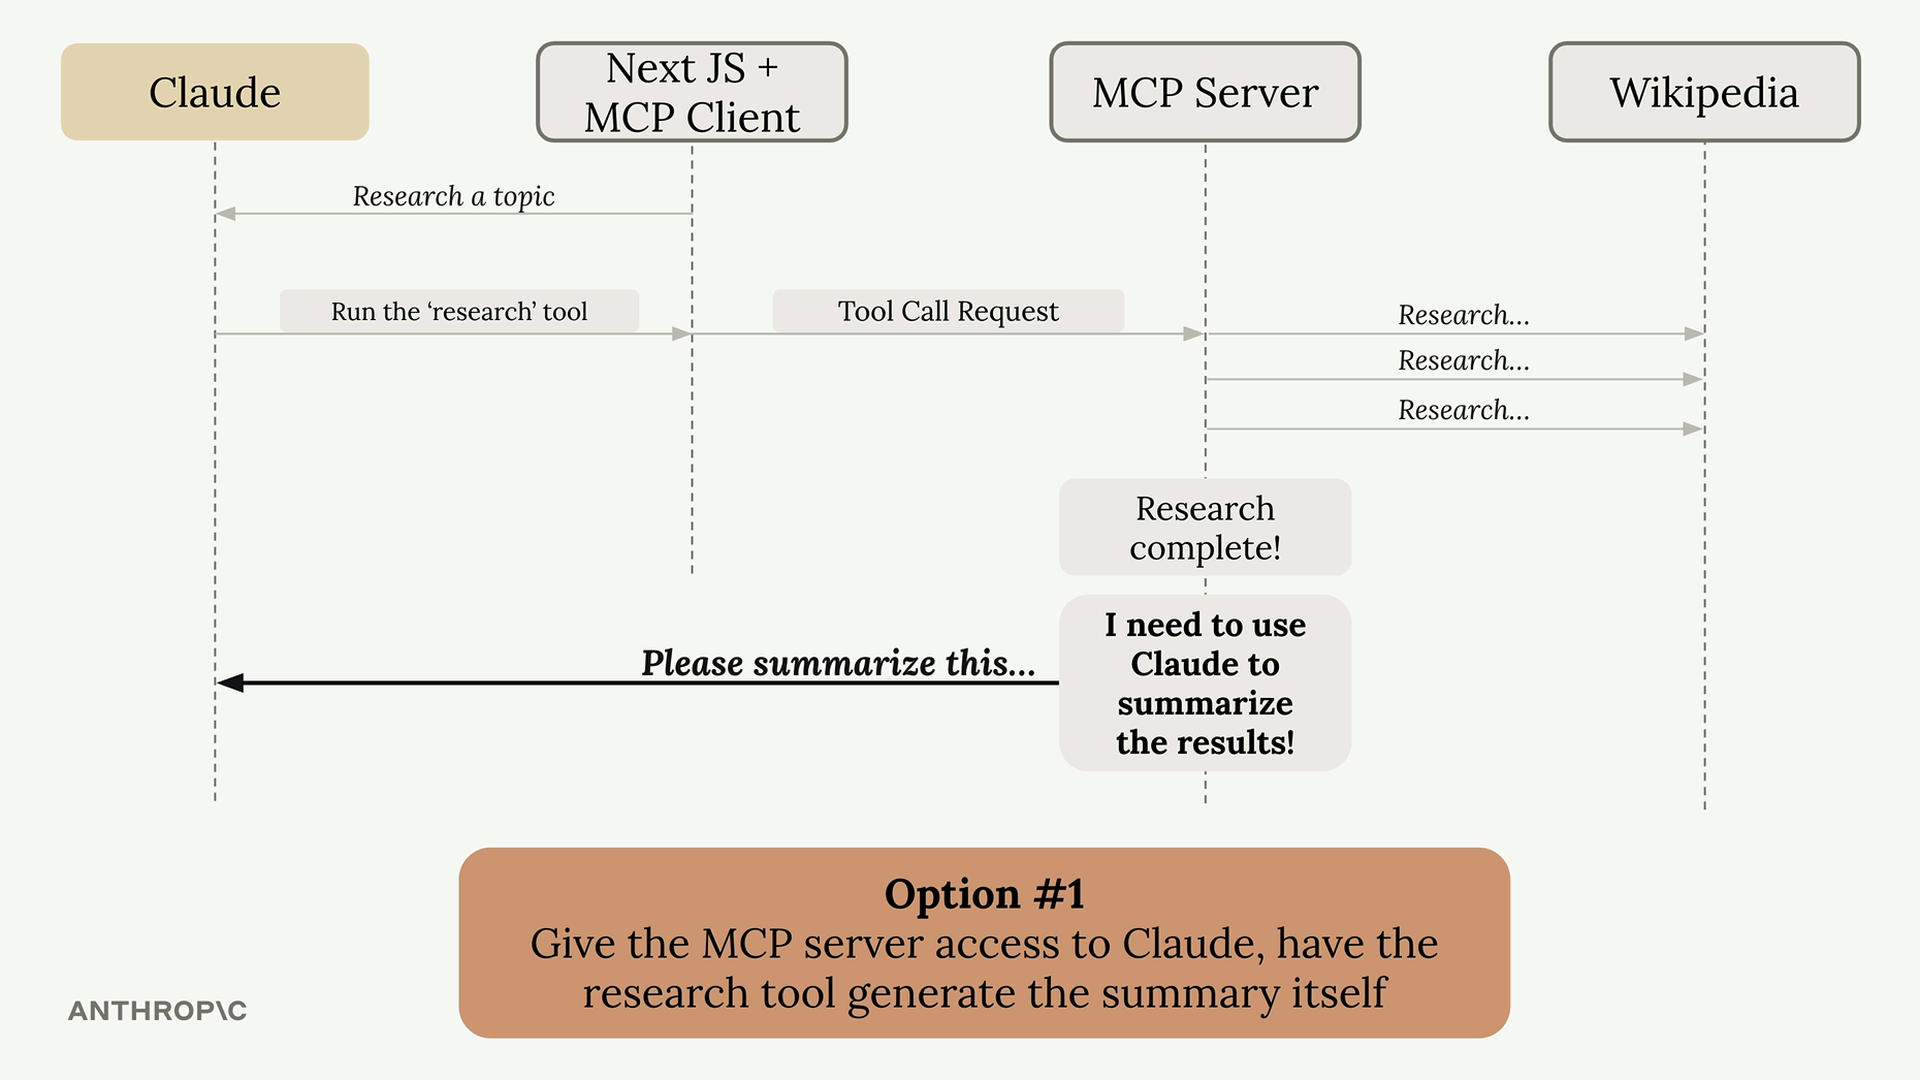
選項 1: 讓 MCP 伺服器直接存取 Claude。伺服器需要擁有自己的 API 金鑰、處理身分驗證、管理成本,並實作所有 Claude 整合程式碼。這種方式可行,但會增加顯著的複雜性。
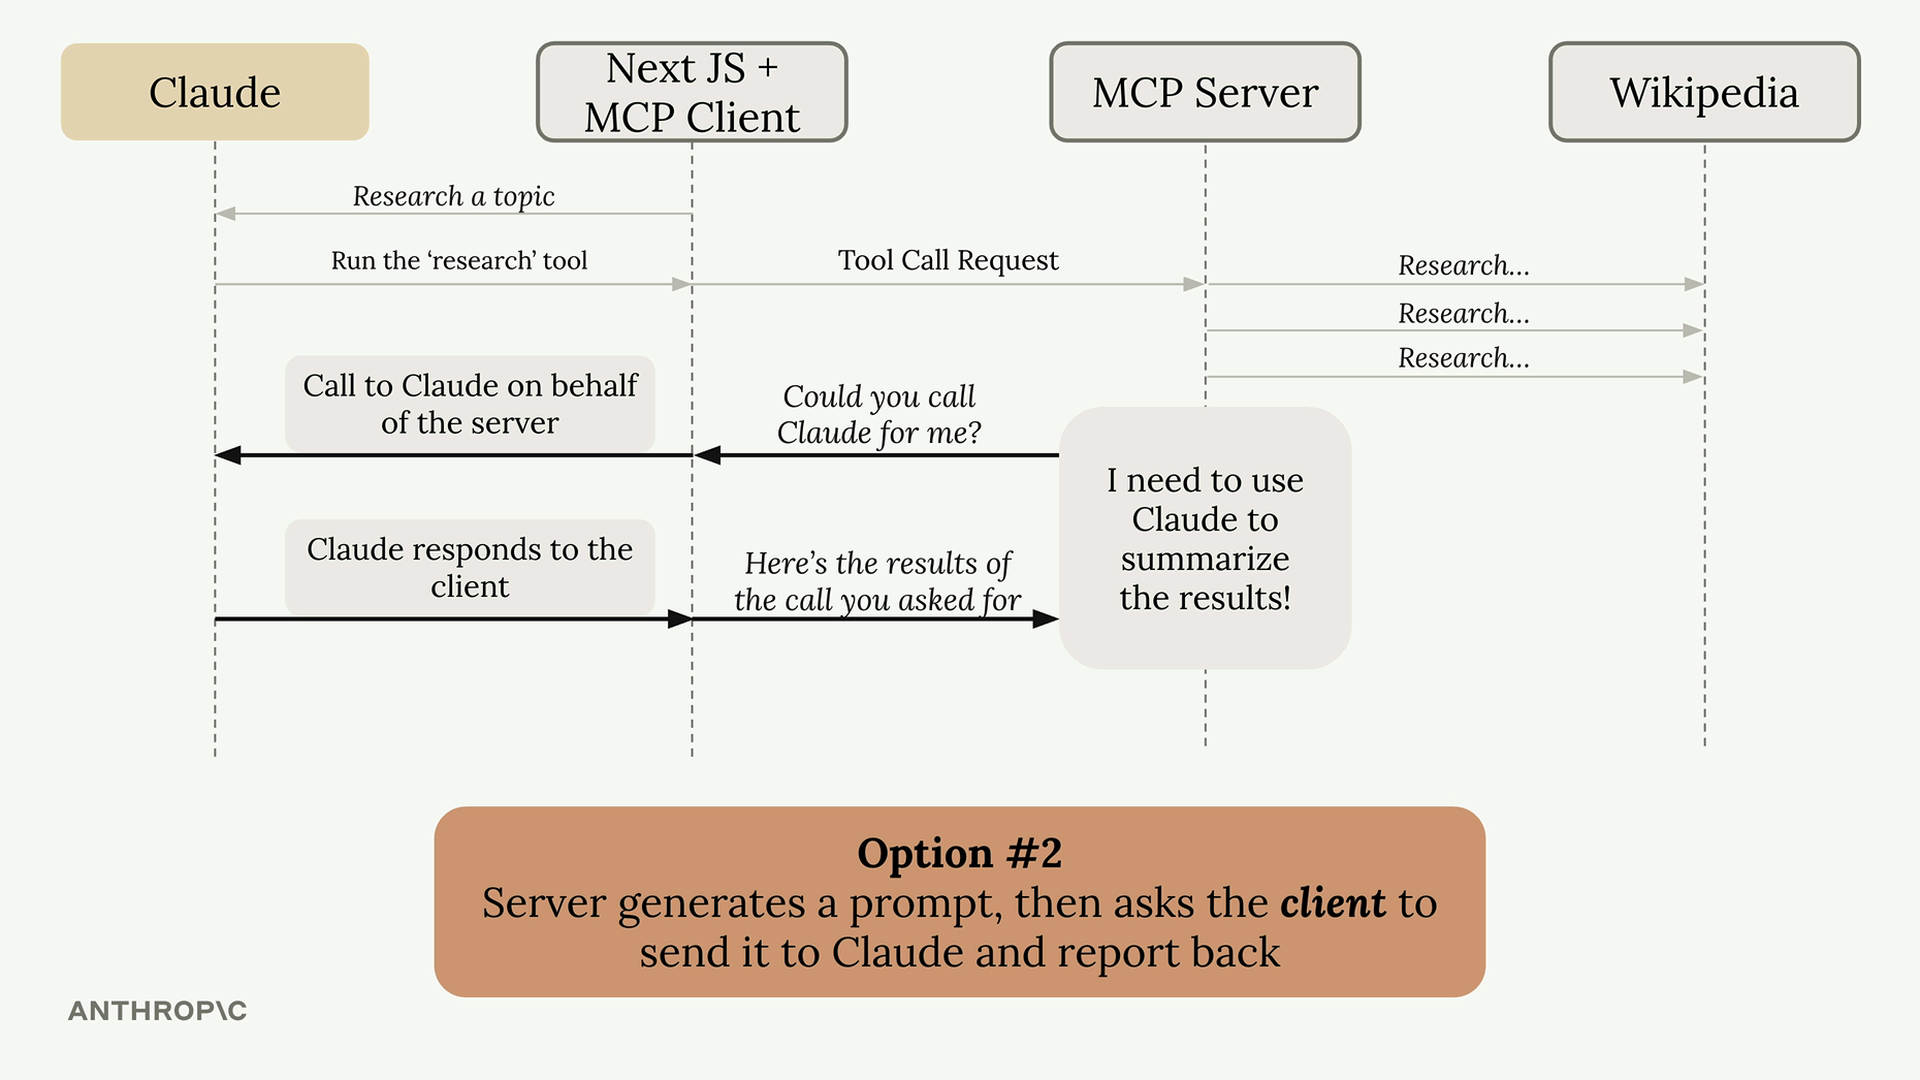
選項 2: 使用取樣。伺服器生成一個提示,並詢問用戶端「您能幫我呼叫 Claude 嗎?」已經與 Claude 建立連線的用戶端會進行呼叫並回傳結果。
取樣的運作方式
流程很直接:
- 伺服器完成其工作(例如擷取 Wikipedia 文章)
- 伺服器建立一個請求文字生成的提示
- 伺服器向用戶端傳送取樣請求
- 用戶端使用提供的提示呼叫 Claude
- 用戶端將生成的文字回傳給伺服器
- 伺服器在其回應中使用生成的文字
取樣的優點
- 降低伺服器複雜性: 伺服器不需要直接與語言模型整合
- 轉移成本負擔: 由用戶端支付權杖(token)使用費用,而非伺服器
- 不需要 API 金鑰: 伺服器不需要 Claude 的憑證
- 非常適合公開伺服器: 您不會希望公開伺服器為每個使用者累積 AI 成本
實作方式
設定取樣需要在雙方都撰寫程式碼:
伺服器端
在您的工具函式中,使用 create_message 函式來請求文字生成:
python
@mcp.tool()
async def summarize(text_to_summarize: str, ctx: Context):
    prompt = f"""
    Please summarize the following text:
    {text_to_summarize}
    """

    result = await ctx.session.create_message(
        messages=[
            SamplingMessage(
                role="user",
                content=TextContent(
                    type="text",
                    text=prompt
                )
            )
        ],
        max_tokens=4000,
        system_prompt="You are a helpful research assistant",
    )

    if result.content.type == "text":
        return result.content.text
    else:
        raise ValueError("Sampling failed")
用戶端
建立一個處理伺服器請求的取樣回呼函式:
python
async def sampling_callback(
    context: RequestContext, params: CreateMessageRequestParams
):
    # 使用 Anthropic SDK 呼叫 Claude
    text = await chat(params.messages)

    return CreateMessageResult(
        role="assistant",
        model=model,
        content=TextContent(type="text", text=text),
    )
然後在初始化您的用戶端工作階段時傳入此回呼函式:
python
async with ClientSession(
    read,
    write,
    sampling_callback=sampling_callback
) as session:
    await session.initialize()
何時使用取樣
當建置公開可存取的 MCP 伺服器時,取樣最有價值。您不會希望隨機使用者以您的成本無限制地生成文字。透過使用取樣,每個用戶端都會支付自己的 AI 使用費用,同時仍能受益於您伺服器的功能。
這項技術本質上將 AI 整合的複雜性從您的伺服器轉移到用戶端,而用戶端通常已經具備必要的連線和憑證。