生產環境中的評估:CI、批次處理與漂移
評估在發布後仍有工作要做。在每一次 pull request 中,它會在客戶收到錯誤答案之前,攔截破壞測試案例的提示變更。它也會為即時流量評分,以捕捉漂移——一種隨著真實輸入變化而出現的緩慢準確度下降。
本影片中的示範錄製於 2026 年 8 月。它在 Claude Haiku 4.5、Claude Sonnet 5 和 Claude Opus 5 上執行。較新的模型上結果會有所不同。每堂課的示範都是獨立的評估執行,因此其分數與成本不會與其他課程中的相符。
您的評估在發布後仍會持續執行,因為有兩件事一直在變化。 您的團隊會編輯提示,而一次編輯可能會破壞原本正確的答案。真實輸入也會變化,直到它們不再與您測試過的輸入相似。因此,評估會在每次編輯上線前執行,並在上線後對即時流量執行。
本課程以 Meridian 為例,這是一家虛構的工程顧問公司,其提示會讀取每月的專案報告,並回傳三個欄位:專案 ID、進度狀態和主要風險。Meridian 的評估有 50 個測試案例。每個測試案例是一份報告加上您預期的答案,全部 50 個合起來構成完整的評估套件。
這四個步驟讓 Meridian 的評估在發布後持續運作:
- 在每一次 pull request 上執行少量測試案例。
- 在通過之前,阻止 pull request 合併。
- 將完整套件作為一個批次執行。
- 每晚對即時流量的樣本進行評分。
在每一次 pull request 上執行少量測試案例
在 CI(持續整合的縮寫)中新增一個工作流程,讓它在每一次 pull request 上執行。 這個工作流程會執行一個煙霧評估,它只取完整套件中足夠少的測試案例,讓您可以等待它完成。它的分數會讓 pull request 上的檢查通過或失敗。Meridian 從其 50 個測試案例中挑選 10 個,以涵蓋每一種報告類型,並在大約一分鐘內於 Claude Haiku 4.5 上執行它們。
閾值是通過的最低分數,Meridian 的閾值是 88%,因此十個測試案例中必須有九個成功。這個工作流程依以下順序執行四項任務:
- 執行評估腳本,並將其回傳的結果儲存為 JSON。
- 根據閾值為這些結果評分。
- 在 pull request 上留言說明結果。
- 如果分數低於閾值,則讓檢查失敗。
Meridian 為此使用 GitHub Actions,但任何能夠執行您評估腳本的 CI 系統都可以完成同樣的四項任務。檔案本身位於下方的方框中。
在通過之前,阻止 pull request 合併
啟用一個分支保護規則,讓煙霧評估成為一項必要檢查(在新分頁中開啟),也就是一項必須在 pull request 可以合併之前通過的檢查。 這項規則屬於分支,而不屬於工作流程檔案,如果沒有它,紅色的 X 只是一個警告。
在 Meridian,一位工程師開啟了一個名為「簡化擷取提示」的 pull request,其中移除了兩條規則。其中一條告訴 Claude,當報告沒有給出主要風險時要回傳 null,另一條則要求 Claude 在回答之前引用風險所在的那一行。
這次執行得分 80%,低於 88% 的閾值。兩個失敗案例都是缺少風險的測試案例,即沒有風險段落的報告,因此每個案例都應該回傳 null,但 Claude 卻還是指出了一個風險。
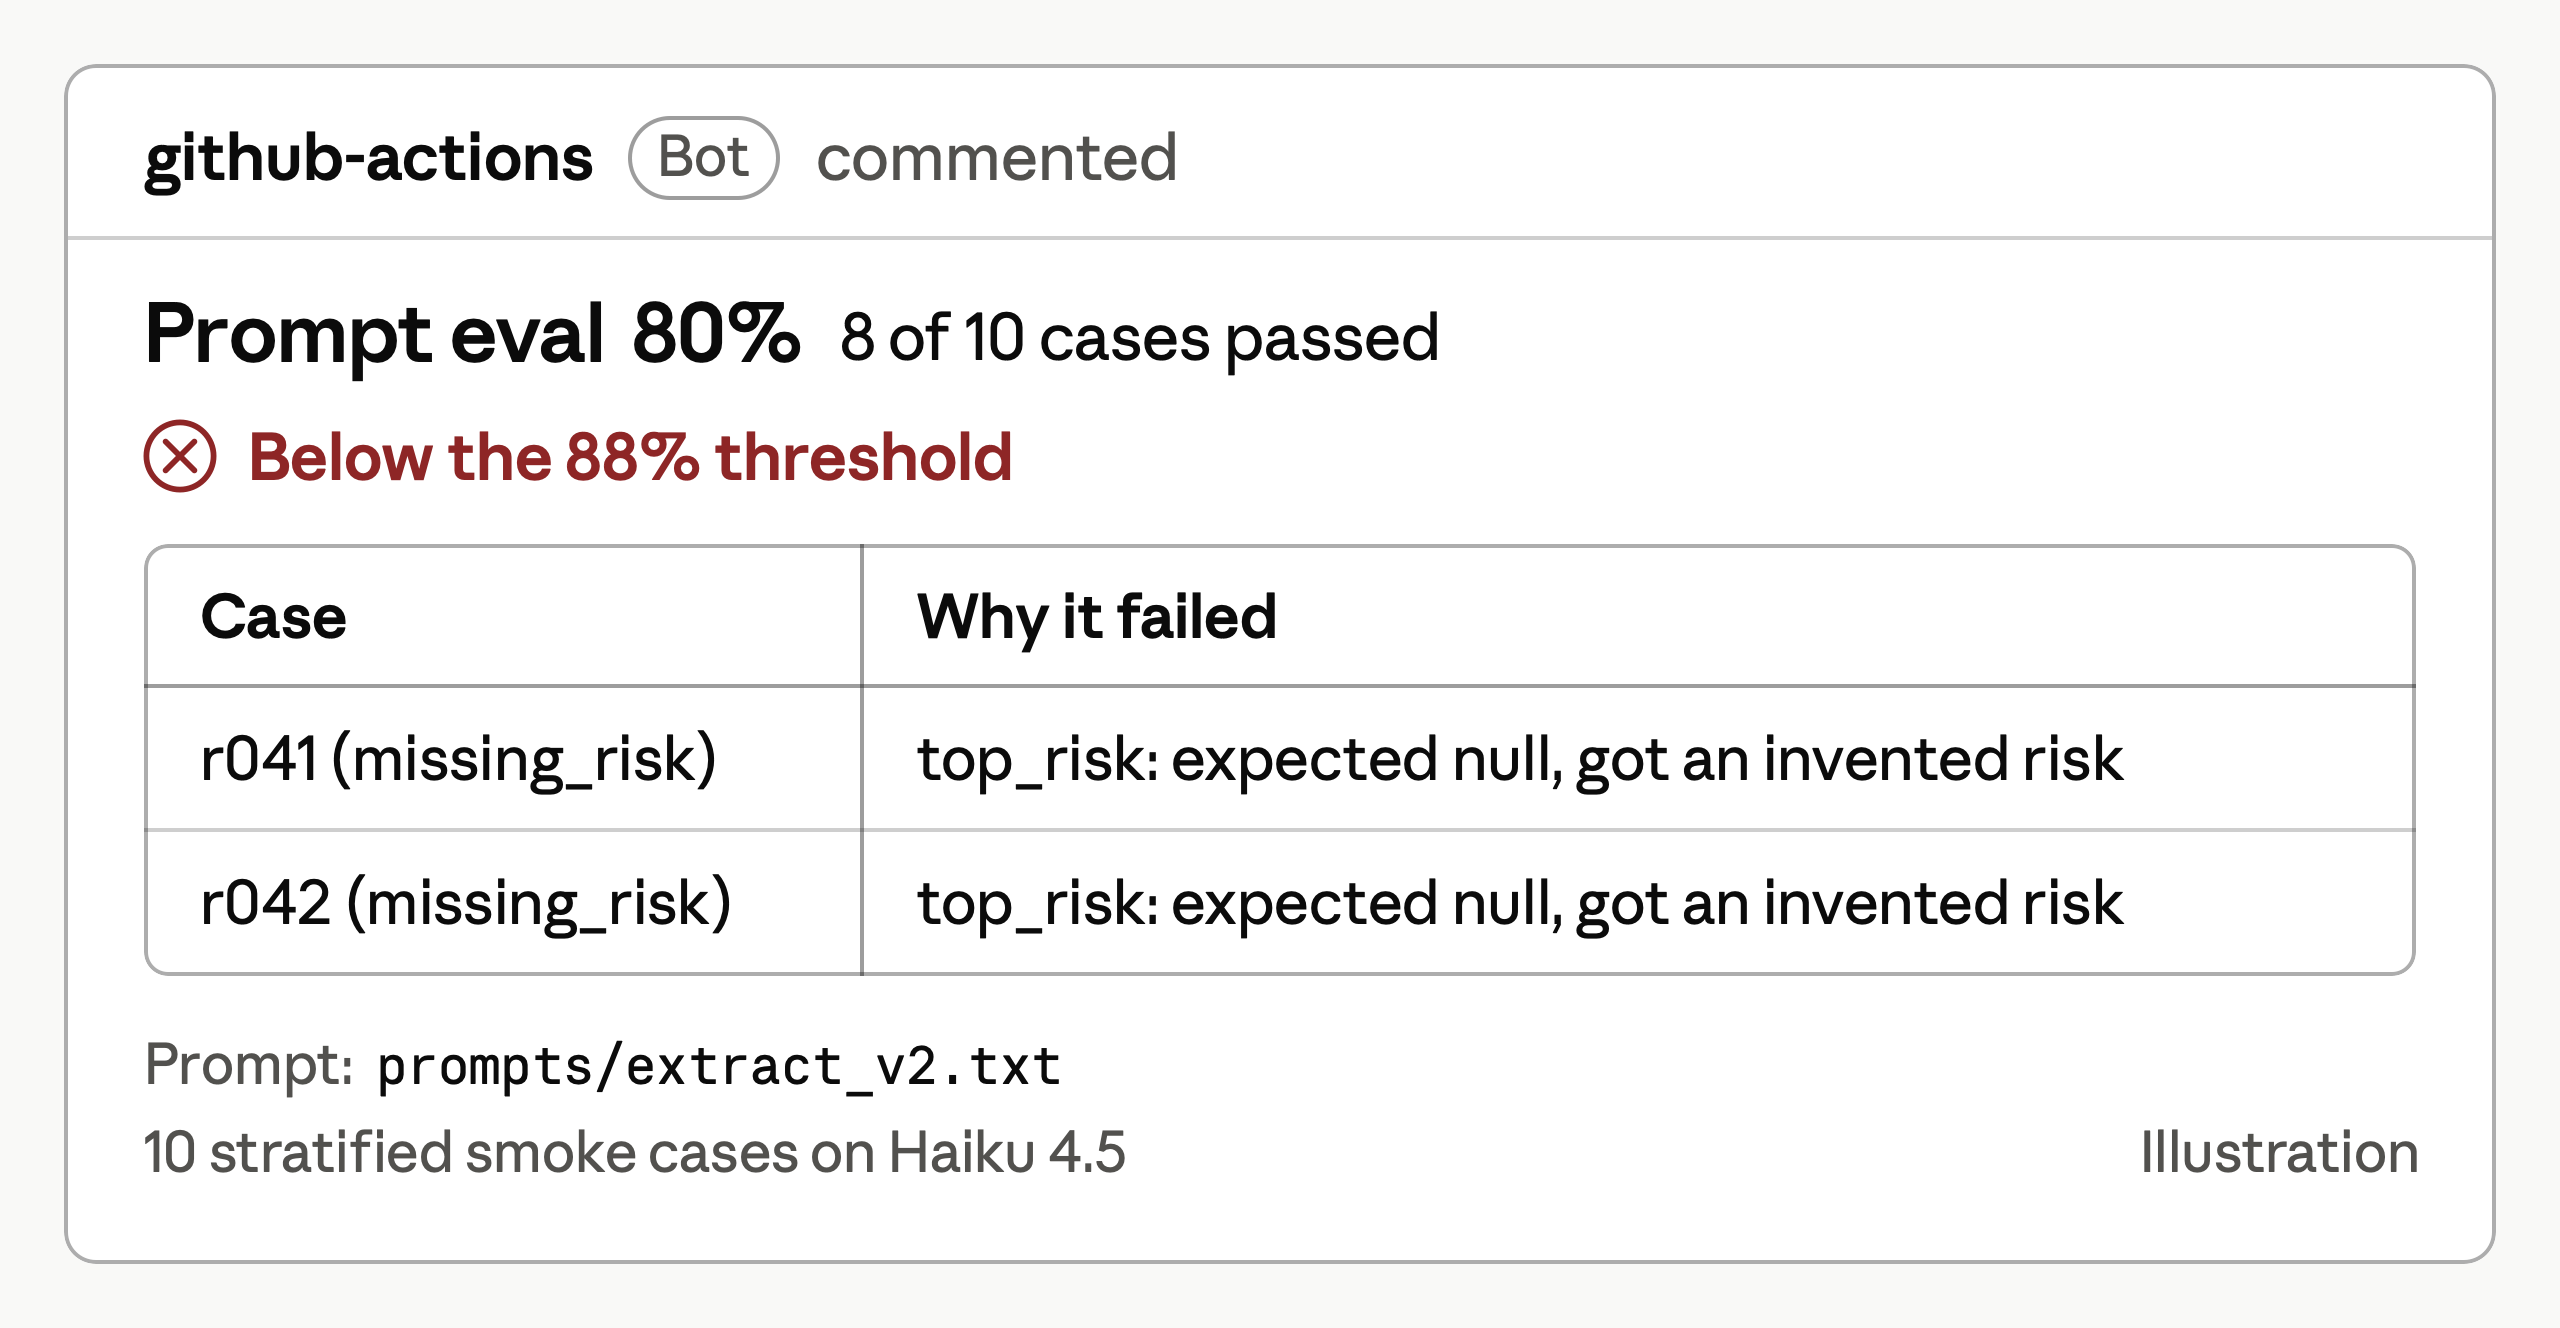
這次煙霧評估得分 80%,未達 88% 的閾值,因為在兩個缺少風險的案例中,Claude 指出了報告中從未給出的風險。
這個紅色檢查讓合併按鈕保持灰色,而它的留言向工程師顯示了哪些案例失敗了:r041 和 r042。一旦提示修正並推送之後,檢查就會變成綠色,合併就可以繼續進行,因此從來沒有客戶看到過那個有問題的提示。
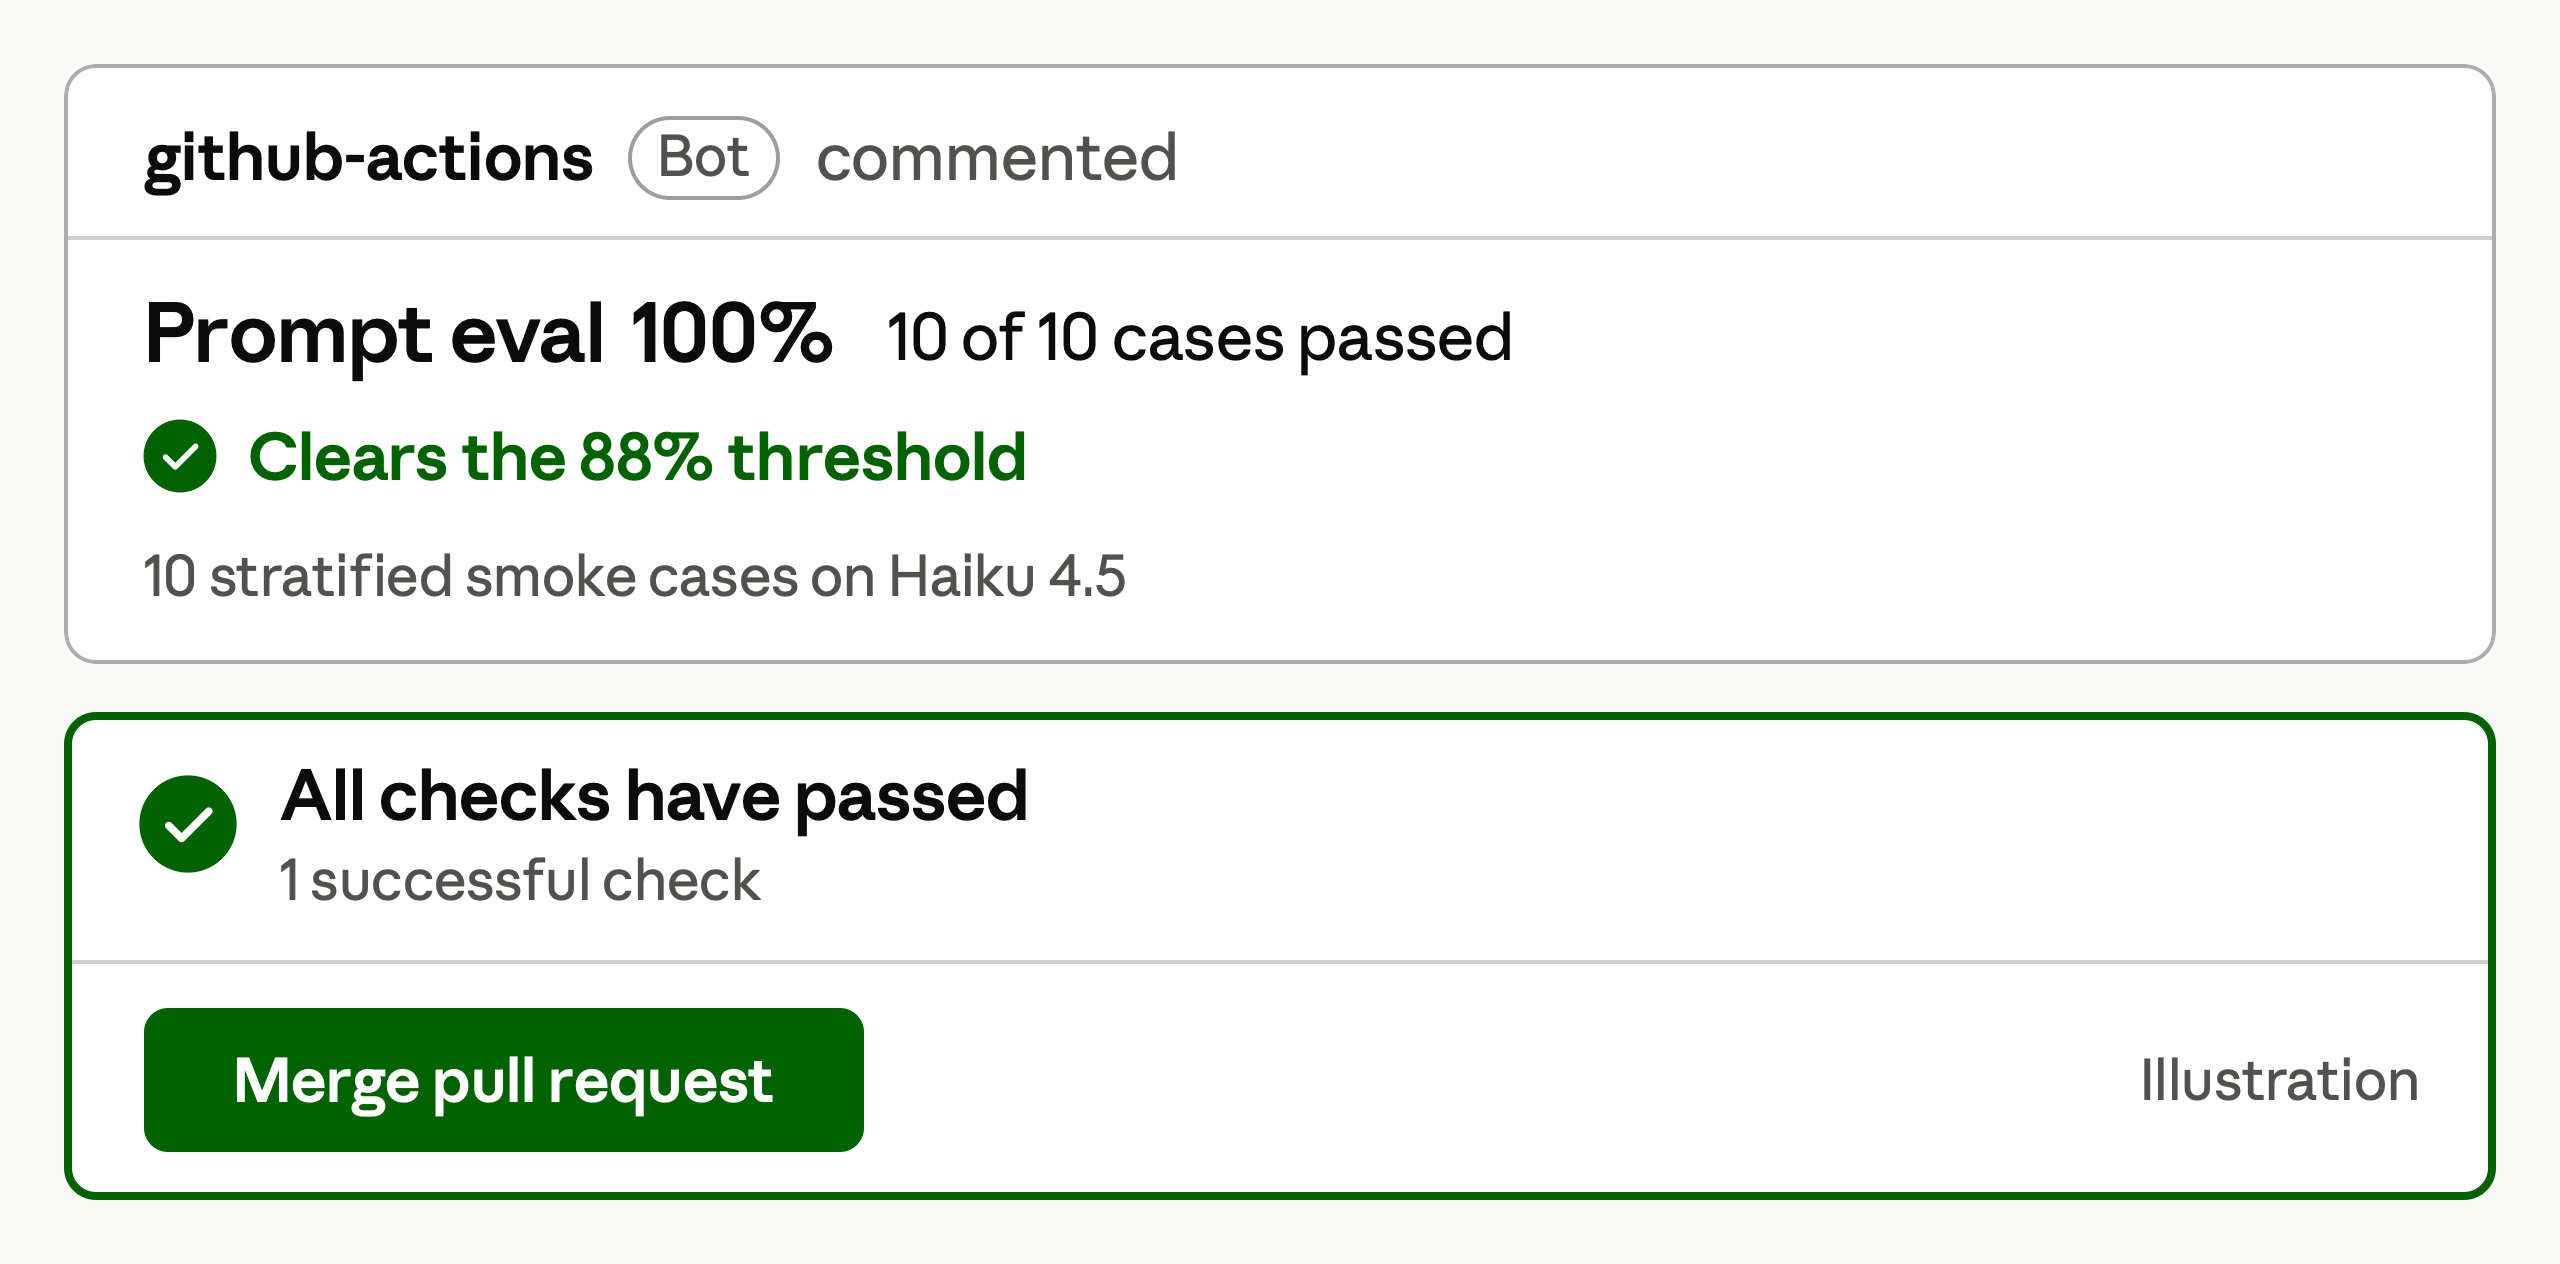
修正之後,每個案例都以 100% 通過,因此合併不再被阻擋。
將完整套件作為一個批次執行
每當您變更提示或模型時(在新分頁中開啟),執行完整套件,並透過 Batch API(在新分頁中開啟) 傳送它。 Meridian 的評估會比較 Haiku 4.5、Claude Sonnet 5 和 Claude Opus 5,因此其批次包含 150 個請求,每個模型都有全部 50 個案例。Batch API 會以輸入與輸出 token 通常價格的一半(在新分頁中開啟)執行所有這些請求,而您可以稍後收集答案,通常在一小時內(在新分頁中開啟)。
| Model | Standard price | Batch API price |
|---|---|---|
| Haiku 4.5 | $0.0468 | $0.0234 |
| Sonnet 5 | $0.1301 | $0.0650 |
| Opus 5 | $0.3432 | $0.1716 |
截至 2026 年 8 月,針對 Meridian 50 個案例在每個模型上執行一輪的標準價格與 Batch API 價格。今日價格(在新分頁中開啟)。
將沒有人等待的請求批次處理,而在有人等待的地方使用標準請求(在新分頁中開啟)。只有合併會等待的煙霧評估,才會繼續使用 client.messages.create(...)。
評估腳本需要做兩項變更。
用 custom_id 為每個請求加上標籤。 結果可能以任意順序抵達(在新分頁中開啟),因此您要用這個標籤來比對它們,而且它在批次中必須是唯一的。每個案例會送到三個模型,因此請將案例 ID 與模型連接起來,例如 r041_claude-haiku-4-5。
batch = client.messages.batches.create(
    requests=[
        {
            "custom_id": f"{case['id']}_{model}",
            "params": {
                "model": model,
                "max_tokens": 1024,
                "messages": [{"role": "user", "content": case["prompt"]}],
            },
        }
        for model in MODELS
        for case in CASES
    ]
)
在評分之前先讀取 request_counts。 它會計算各種結束方式的請求數量,藉此顯示何時一次執行的結果不完整。24 小時內未完成的批次會過期(在新分頁中開啟),而過期的請求不會產生費用,但也不會有答案(在新分頁中開啟)。
batch = client.messages.batches.retrieve(batch.id)
print(batch.request_counts)

answers = {}
for result in client.messages.batches.results(batch.id):
    if result.result.type == "succeeded":
        answers[result.custom_id] = result.result.message
每晚對即時流量的樣本進行評分
每晚對一小部分即時流量,也就是您應用程式處理的真實請求,進行評分。 完整套件只知道您在建置時所擁有的報告,因此如果有新客戶開始傳送一種您的案例都沒有涵蓋的格式報告,即使答案變差,您的 CI 仍會保持綠色。這種緩慢的準確度流失就是漂移。
做法如下:
- 取樣。 從即時流量中挑出 1% 到 5% 之間的部分。
- 用 LLM 評審(在新分頁中開啟)為樣本評分。 這是第二個模型,它會根據一套書面規則的評分標準來為每個答案評分,只使用報告、Claude 的答案和評分標準,因此不需要即時流量所缺乏的預期答案。不過,您仍要時不時親自閱讀幾個答案(在新分頁中開啟),因為評審也需要由人來檢查。
- 只在真正下滑時發出警示。 也就是某一晚的分數低於近期各晚平均值(稱為追蹤基準線)超過兩個標準差的情況。兩個標準差比正常一晚會帶來的變化還要大。
- 將評審標記為不正確的每個答案製作成一個案例。 寫下它的預期答案,然後將該案例加入完整套件,因為來自真實失敗的案例(在新分頁中開啟)能讓套件貼近真實使用情況。
即時流量會顯示完整套件遺漏了什麼,而您加入的每個失敗案例都會縮小這個落差。請將 1% 到 5% 和兩個標準差視為起點,依您自己的流量進行調整。
重點總結
- 讓煙霧評估在每一次 pull request 上執行,並讓它的分數來決定檢查通過或失敗。
- 將該檢查設為必要,這樣低分才會真正阻止合併。
- 將完整套件作為批次執行,這樣只需花費一半的成本,因為沒有人在等待它。
- 每晚對即時流量的樣本進行評分,當分數下降幅度超過平常時發出警示,並將每個失敗案例轉變成完整套件中的新案例。