載入中
選擇合適的模型
您正在用 Claude 發布一個應用程式。您會選擇哪個模型?如果您預設選擇最聰明的那個,您的 API 帳單會讓您大吃一驚。如果選擇最便宜的那個,輸出品質可能又撐不住。每個模型都有不同的取捨,選擇正確的模型會同時影響品質和成本。
模型層級
Anthropic 目前提供四個模型層級,您可以透過 API 呼叫中的 model 參數在其中做選擇。
- Claude Fable 是我們目前為止最強大的模型——這是一個位於 Opus
之上的全新層級,專為您最棘手的挑戰而打造。它的成本高於
Opus,因此請將其保留給值得為額外能力付費的工作。目前的 Fable 模型是 Claude Fable 5.1
(
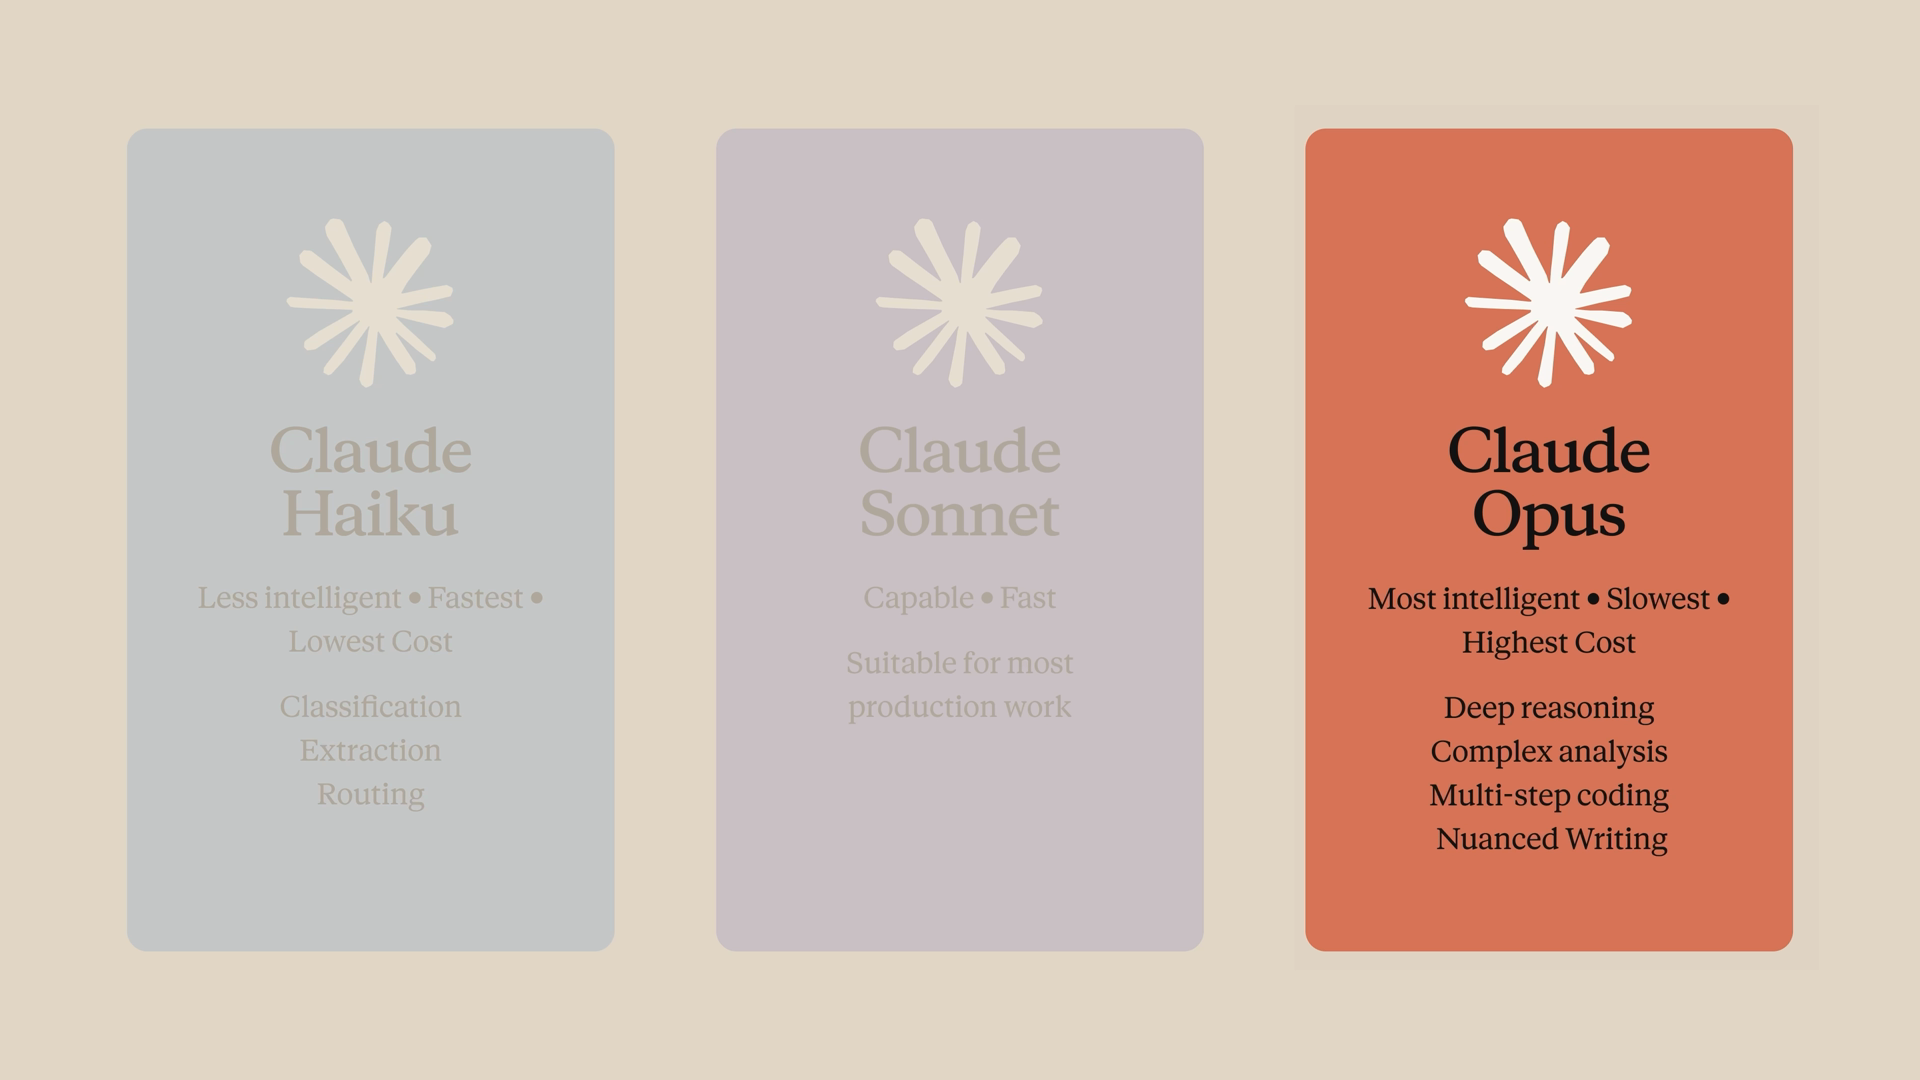
claude-fable-5-1)。 - Claude Opus 是三個核心模型系列中最強大的,但也是速度最慢、成本最高的一個。適用於深度推理、複雜分析、多步驟程式設計以及細膩的寫作。目前的
Opus 模型是 Claude Opus 5.5(
claude-opus-5-5)。 - Claude Haiku 是速度最快、成本最低的模型,針對速度與成本效益而非最大智慧進行最佳化。適用於高量、低複雜度的工作,例如分類、擷取與路由。目前的
Haiku 模型是 Claude Haiku 4.5(
claude-haiku-4-5)。 - Claude Sonnet
正好位於最佳平衡點:智慧、速度與成本之間取得了良好的平衡,適合大多數生產環境的工作。目前的
Sonnet 模型是 Claude Sonnet 5(
claude-sonnet-5)。
從簡單的評估開始
在撰寫生產環境程式碼之前,請先設置一個簡單的評估:一組範例輸入,讓您在每個模型上執行,並依據「什麼算是適合您使用情境的良好輸出」進行評分。您不需要任何花俏的東西——從您實際工作負載中選取 20 到 30 個具代表性的範例就足以開始。
接著逐層往上試:
- 先用 Haiku 執行您的範例。如果品質夠好,那就完成了——而且您剛省下了一大筆錢。
- 如果不夠好,就升級到 Sonnet。
- 只有在任務真的需要時,才動用 Opus。
並列比較各個層級
讓我們親眼看看各層級之間的差異,而不只是空談。我們會把同一個提示傳送給全部三個模型,並觀察延遲與權杖數量:
python
models = ["claude-haiku-4-5", "claude-sonnet-5", "claude-opus-5-5"]

for model in models:
    response = client.messages.create(
        model=model,
        max_tokens=300,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, response.usage)
這裡發生了兩件事:
- 迴圈會在每次請求時替換
model欄位。提示相同、最大權杖數相同——只有模型不同。 response.usage會直接從 API 回傳輸入與輸出權杖數,這正是您帳單的計算依據。
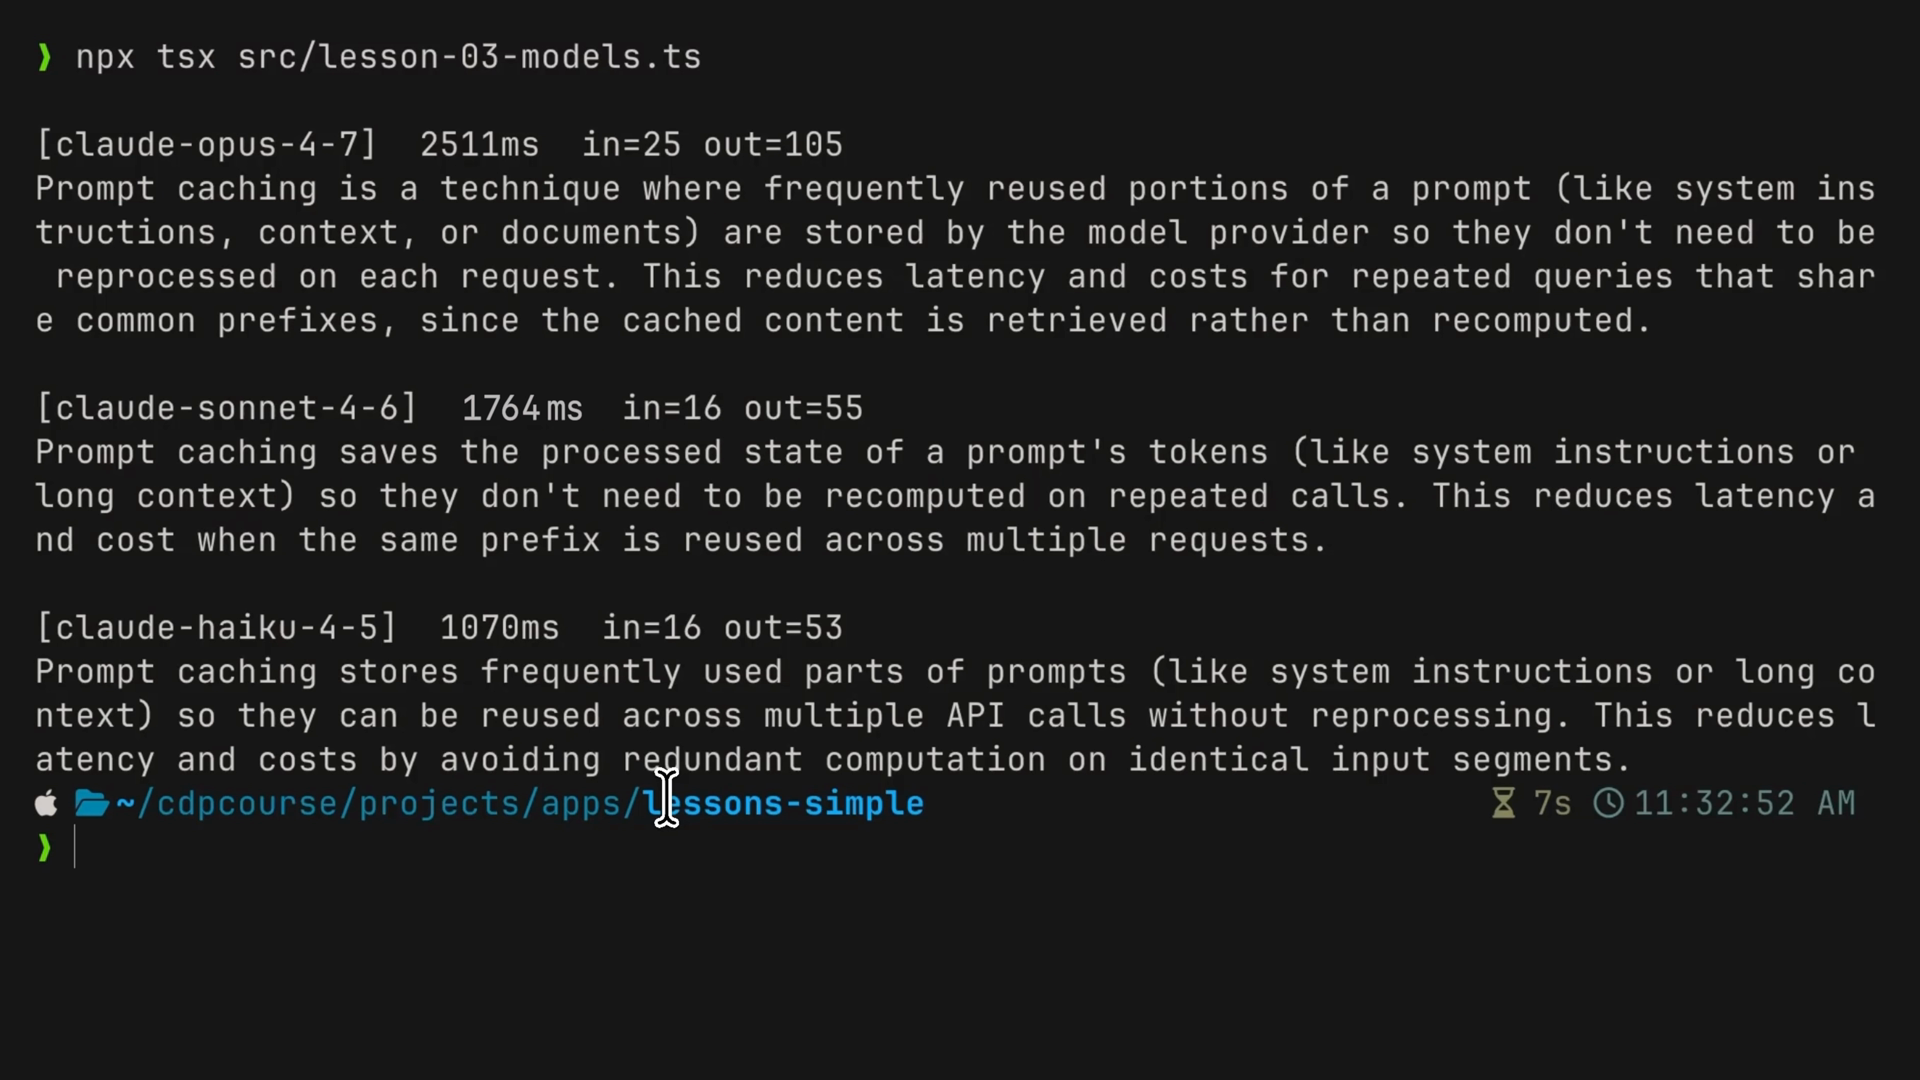
執行它,您會看到三個模型和三組數字。Opus 耗時最長、讀起來也最精緻——但對於一個兩句話的定義來說,那種精緻其實是浪費的。Sonnet 把文字稍微收緊了一些。而 Haiku 回應得很快,通常不到一秒,給出一個相當稱職的兩句話答案。老實說,對這種情境而言,它相當完美。
這正是重點所在:正確的模型,是您實際上會拿來發布的輸出中最便宜的那一個。 對於一個定義而言,Haiku 就綽綽有餘了。對於起草一份監管回應,您會執行相同的比較,而結果多半會落在 Opus 上。評估的形式每次都一樣。
將不同的工作路由到不同的模型
在實際的應用程式中,您會在同一個端點內把不同種類的工作路由到不同的模型。以一個具有文件處理路由的營運儀表板為例:
- 每個進來的檔案都用 Haiku 分類。
- 客戶更新用 Sonnet 起草。
- 只有 RFP(提案邀請書)回應才動用 Opus。
一個佇列,三個模型,依任務挑選。
重點回顧
- Anthropic 提供四個模型層級:Fable 提供目前最高的可用能力、Opus 用於難題、Sonnet 用於日常工作、Haiku 用於大量處理。
- 在撰寫生產環境程式碼之前,先設置一個簡單的評估——從您真實的工作負載中選取 20 到 30 個具代表性的範例。
- 從 Haiku 開始往上執行評估,並停在您實際上會拿來發布的輸出中最便宜的模型上。
response.usage會回報輸入與輸出權杖數,這正是您帳單的計算依據。- 在生產環境中,把不同的任務路由到同一個端點內的不同模型,而不是一個模型處理所有事情。