采样允许服务器通过连接的MCP客户端访问像Claude这样的语言模型。服务器不是直接调用Claude,而是要求客户端代表它进行调用。这将文本生成的责任和成本从服务器转移到了客户端。
采样解决的问题
假设您有一个MCP服务器,其中有一个从Wikipedia获取信息的研究工具。在收集完所有数据后,您需要将其总结成一份连贯的报告。您有两个选择:
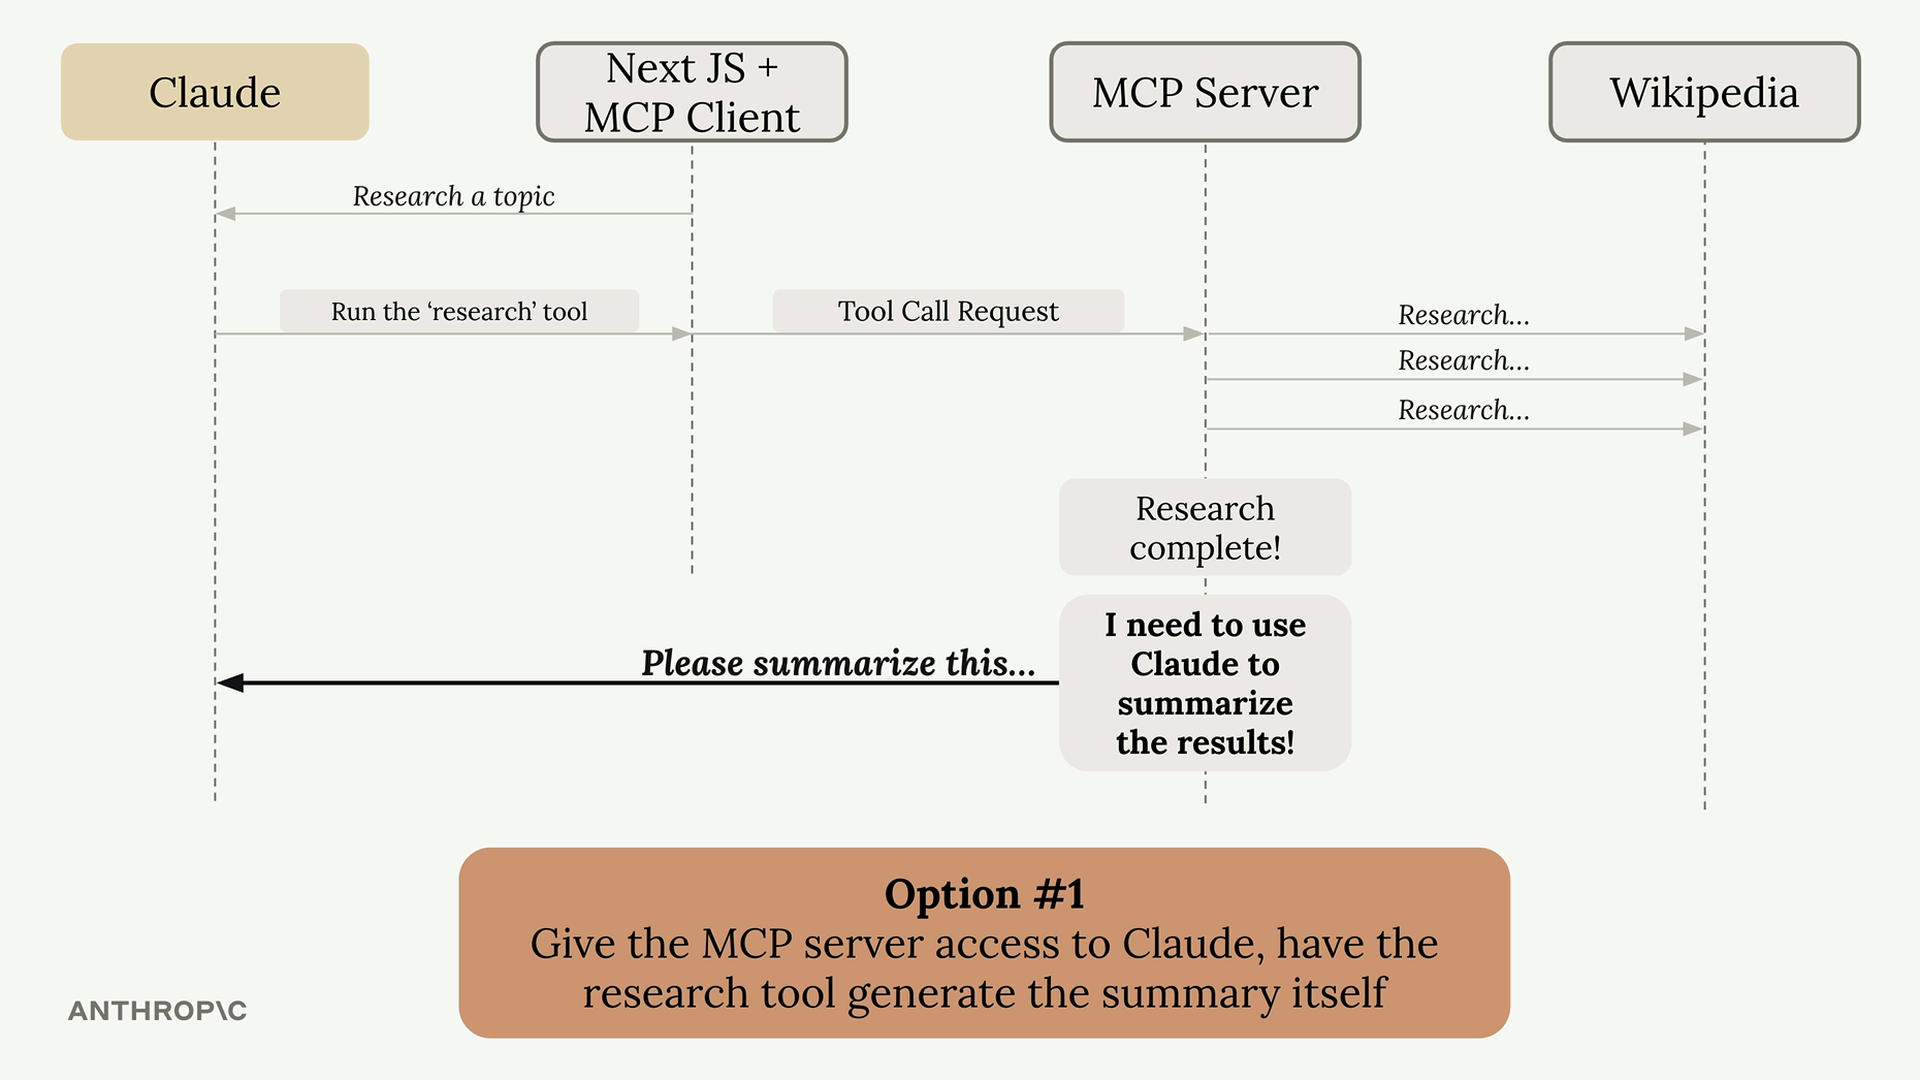
选项1: 让MCP服务器直接访问Claude。服务器需要拥有自己的API密钥,处理身份验证,管理成本,并实现所有Claude集成代码。这种方式可行,但会增加大量复杂性。
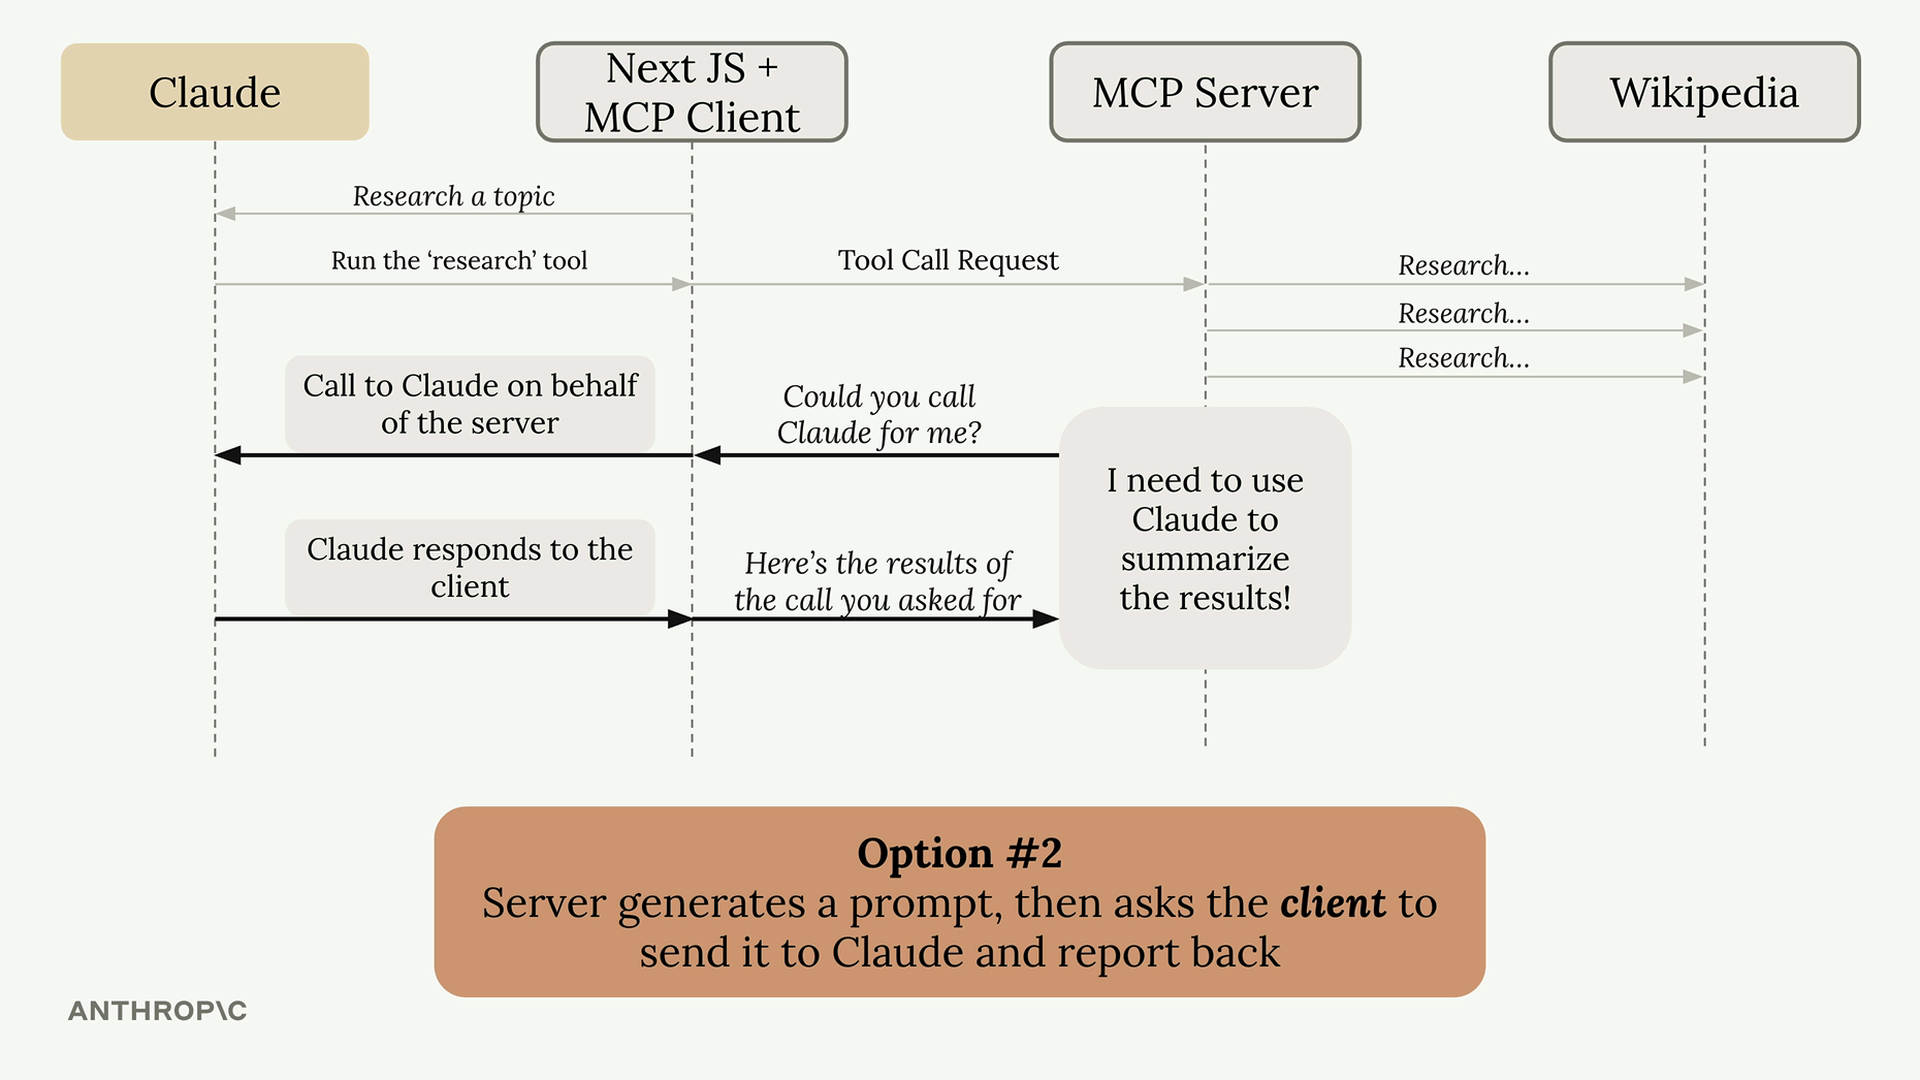
选项2: 使用采样。服务器生成一个提示,并询问客户端"您能替我调用Claude吗?"客户端已经与Claude建立了连接,因此会进行调用并返回结果。
采样的工作原理
流程很简单:
- 服务器完成其工作(例如获取Wikipedia文章)
- 服务器创建一个请求文本生成的提示
- 服务器向客户端发送采样请求
- 客户端使用提供的提示调用Claude
- 客户端将生成的文本返回给服务器
- 服务器在其响应中使用生成的文本
采样的优势
- 降低服务器复杂性: 服务器不需要直接与语言模型集成
- 转移成本负担: 由客户端支付令牌使用费用,而不是服务器
- 无需API密钥: 服务器不需要Claude的凭证
- 非常适合公共服务器: 您不希望公共服务器为每个用户累积AI费用
实现
设置采样需要在双方都编写代码:
服务器端
在您的工具函数中,使用create_message函数来请求文本生成:
python
@mcp.tool()
async def summarize(text_to_summarize: str, ctx: Context):
    prompt = f"""
    Please summarize the following text:
    {text_to_summarize}
    """

    result = await ctx.session.create_message(
        messages=[
            SamplingMessage(
                role="user",
                content=TextContent(
                    type="text",
                    text=prompt
                )
            )
        ],
        max_tokens=4000,
        system_prompt="You are a helpful research assistant",
    )

    if result.content.type == "text":
        return result.content.text
    else:
        raise ValueError("Sampling failed")
客户端
创建一个处理服务器请求的采样回调:
python
async def sampling_callback(
    context: RequestContext, params: CreateMessageRequestParams
):
    # 使用 Anthropic SDK 调用 Claude
    text = await chat(params.messages)

    return CreateMessageResult(
        role="assistant",
        model=model,
        content=TextContent(type="text", text=text),
    )
然后在初始化客户端会话时传入此回调:
python
async with ClientSession(
    read,
    write,
    sampling_callback=sampling_callback
) as session:
    await session.initialize()
何时使用采样
在构建可公开访问的MCP服务器时,采样最有价值。您不希望随机用户以您的成本无限制地生成文本。通过使用采样,每个客户端都为自己的AI使用付费,同时仍能受益于您服务器的功能。
这项技术本质上是将AI集成的复杂性从您的服务器转移到客户端,而客户端通常已经具备必要的连接和凭证。