生产环境中的评估:CI、批处理与漂移
评估在上线后仍有工作要做。每次提交拉取请求(pull request)时,它都会在客户得到错误答案之前,捕捉到破坏用例的提示变更。它还会对实时流量进行评分,以捕捉漂移——一种随着真实输入变化而出现的准确率缓慢下降。
本视频中的演示录制于2026年8月,运行在Claude Haiku 4.5、Claude Sonnet 5和Claude Opus 5上。在较新的模型上结果会有所不同。每节课的演示都是一次独立的评估运行,因此其分数和成本不会与其他课程中的相符。
您的评估在上线后仍需运行,因为有两件事一直在变化。您的团队会修改提示,而修改可能会破坏原本正确的答案。真实输入也会变化,直到它们不再像您测试过的那些。因此,评估会在每次修改发布前运行一次,在上线后再对实时流量运行一次。
本课程以Meridian为例,这是一家虚构的工程咨询公司,其提示会读取每份月度项目报告,并返回三个字段:项目ID、进度状态和最大风险。Meridian的评估有50个用例。每个用例由一份报告加上您对它的预期答案组成,全部50个用例共同构成完整套件。
以下四个步骤让Meridian的评估在上线后持续有效:
- 在每次拉取请求时运行少量用例。
- 在评估通过之前,阻止拉取请求合并。
- 将完整套件作为一次批处理运行。
- 每晚对实时流量的样本进行评分。
在每次拉取请求时运行少量用例
在CI(持续集成的缩写)中添加一个工作流,并让它在每次拉取请求时运行。该工作流会运行一次冒烟评估(smoke eval),它只取完整套件中足够少的用例,以便您在等待时就能完成。它的分数会决定拉取请求上的检查通过或失败。Meridian从其50个用例中挑选出10个,以覆盖每一种报告类型,并在大约一分钟内于Claude Haiku 4.5上运行它们。
阈值是通过的最低分数,Meridian的阈值是88%,因此十个用例中必须有九个成功。该工作流按以下顺序完成四项任务:
- 运行评估脚本,并将其返回的内容保存为JSON。
- 根据阈值对这些结果进行评分。
- 在拉取请求上评论结果。
- 如果分数低于阈值,则使检查失败。
Meridian为此使用GitHub Actions,但任何能够运行您评估脚本的CI系统都可以完成这相同的四项任务。该文件本身见下方框中。
在评估通过之前阻止拉取请求合并
开启一条分支保护规则,使冒烟评估成为一项必需检查(在新标签页中打开),即拉取请求合并前必须通过的检查。该规则归属于分支,而非工作流文件,如果没有它,一个红色的X只是一个警告。
在Meridian,一位工程师提交了一个名为"Simplify extraction prompt"的拉取请求,删除了两条规则。其中一条告诉Claude在报告没有给出最大风险时返回null,另一条让Claude在回答之前引用风险所在的那一行。
此次运行得分为80%,低于88%的阈值。两个失败的用例都是缺失风险的用例——即没有风险部分的报告,因此本应各自返回null,但Claude却还是给出了一个风险。
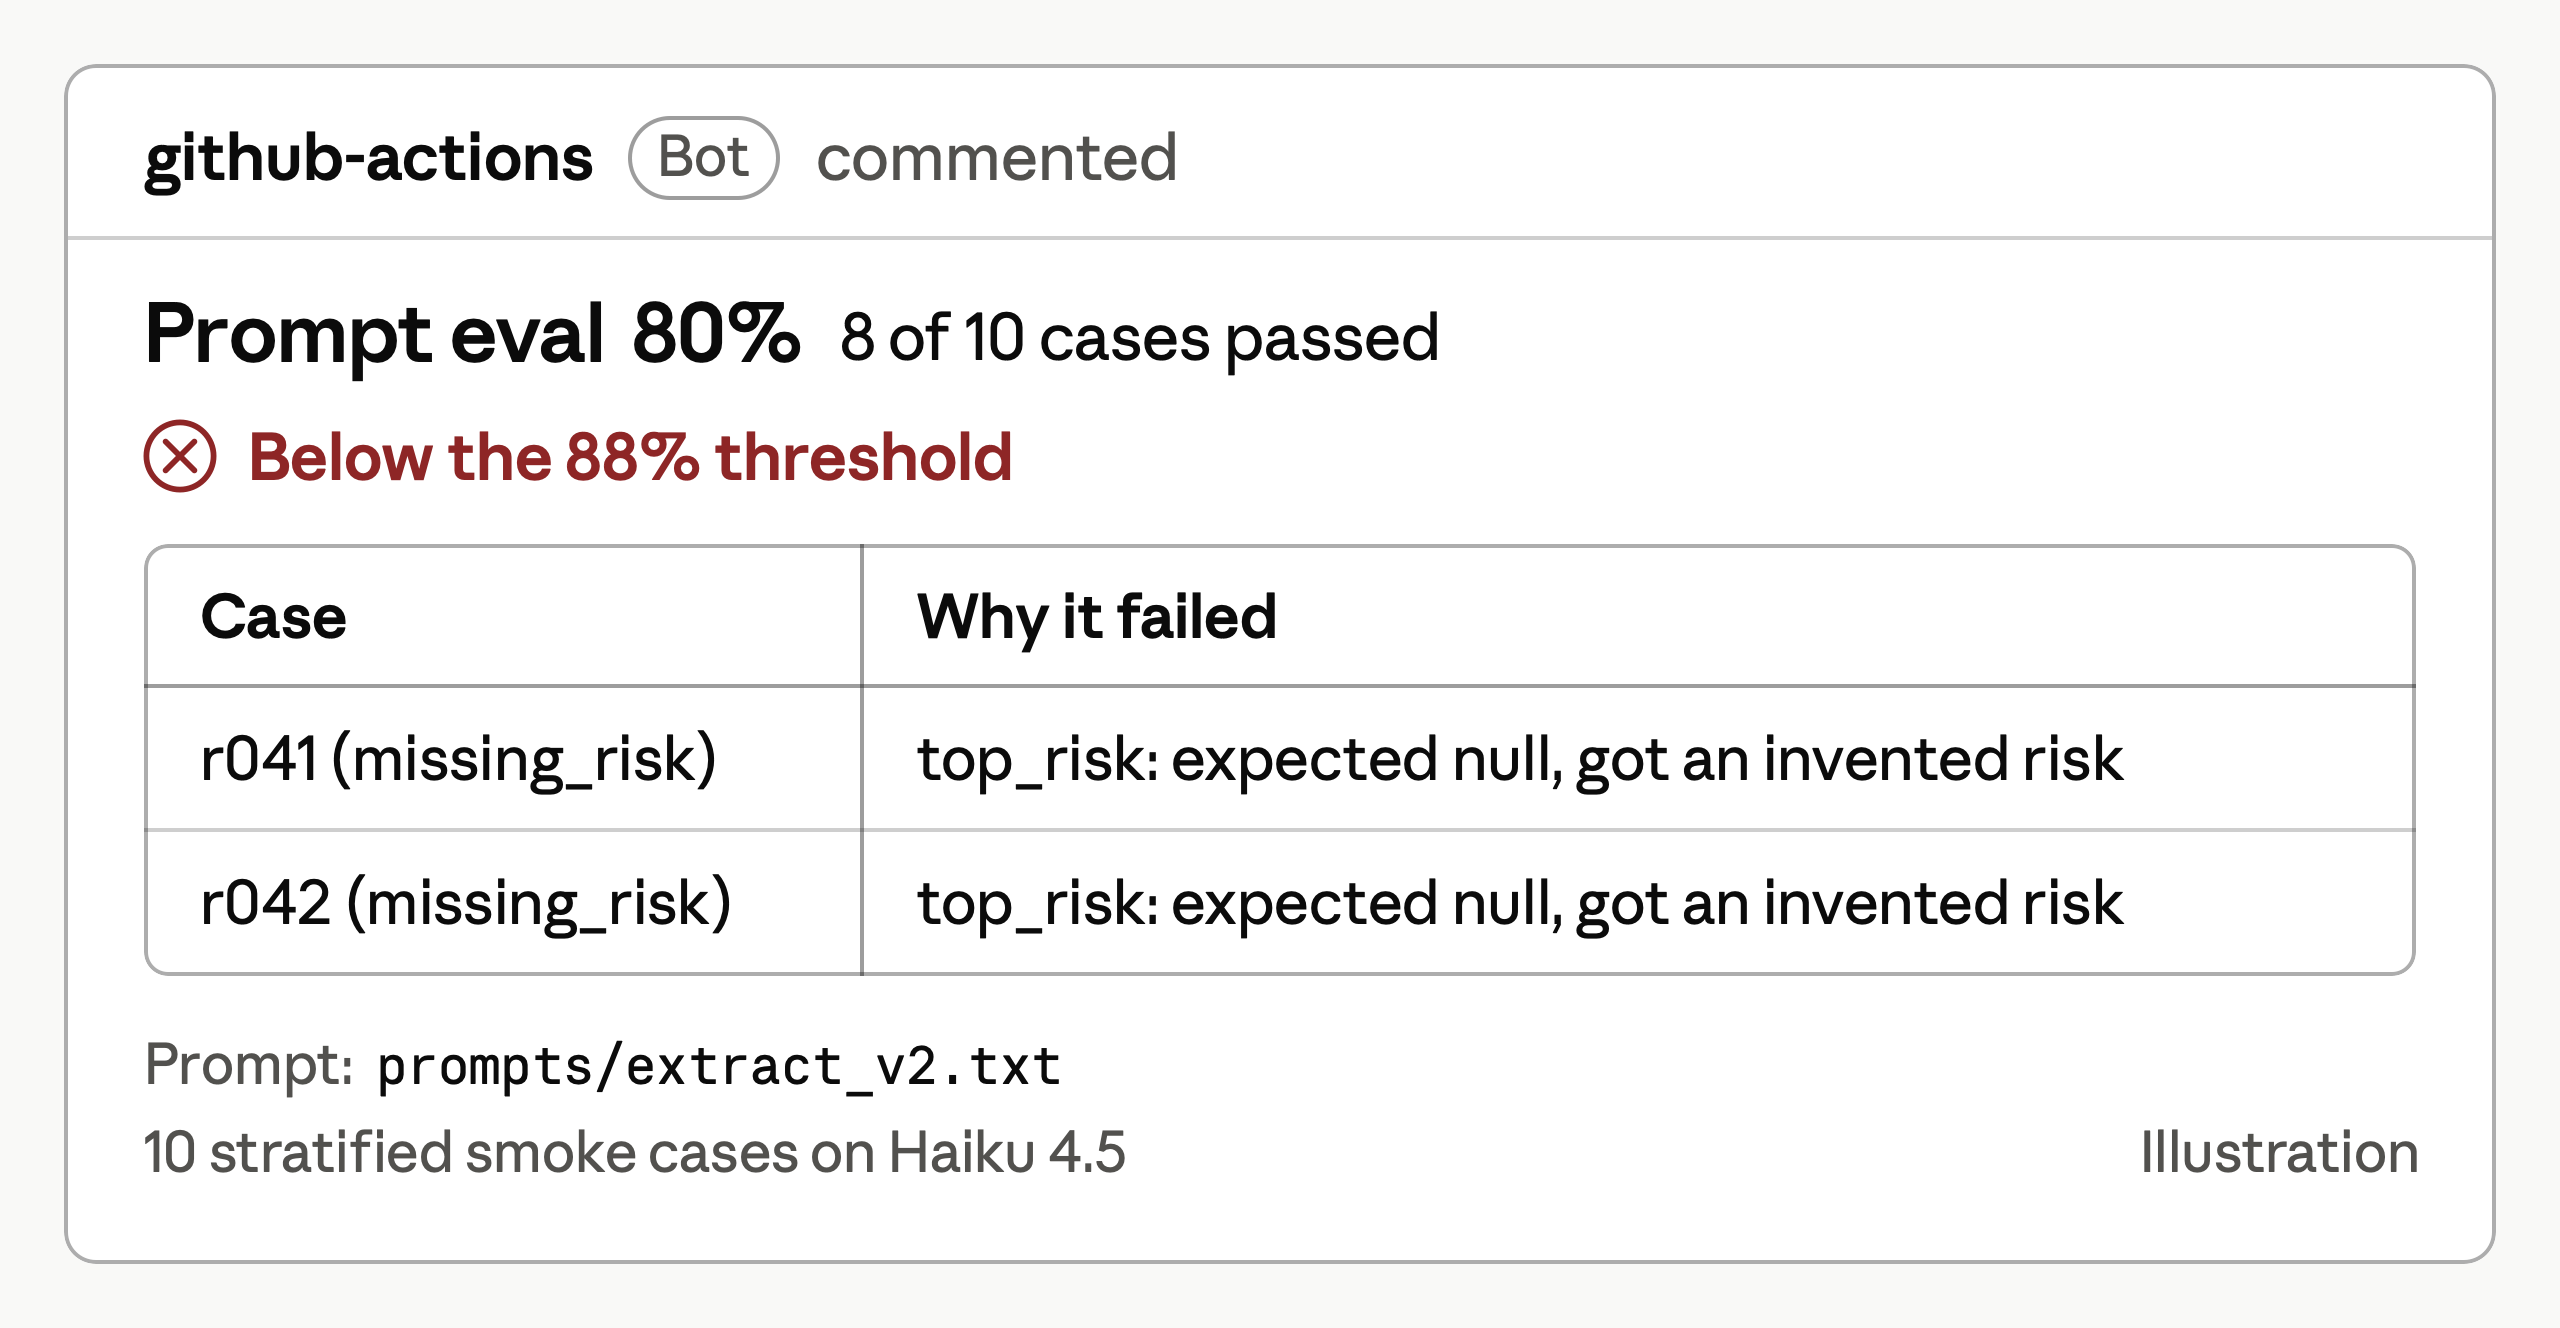
冒烟评估得分80%,未达到88%的阈值,因为在两个缺失风险的用例中,Claude给出了报告从未提及的风险。
红色的检查使合并按钮保持灰色,其评论向工程师展示了哪些用例出了问题:r041和r042。一旦提示被修复并推送,检查就会变绿,合并也就可以继续进行,因此没有任何客户见过那个出问题的提示。
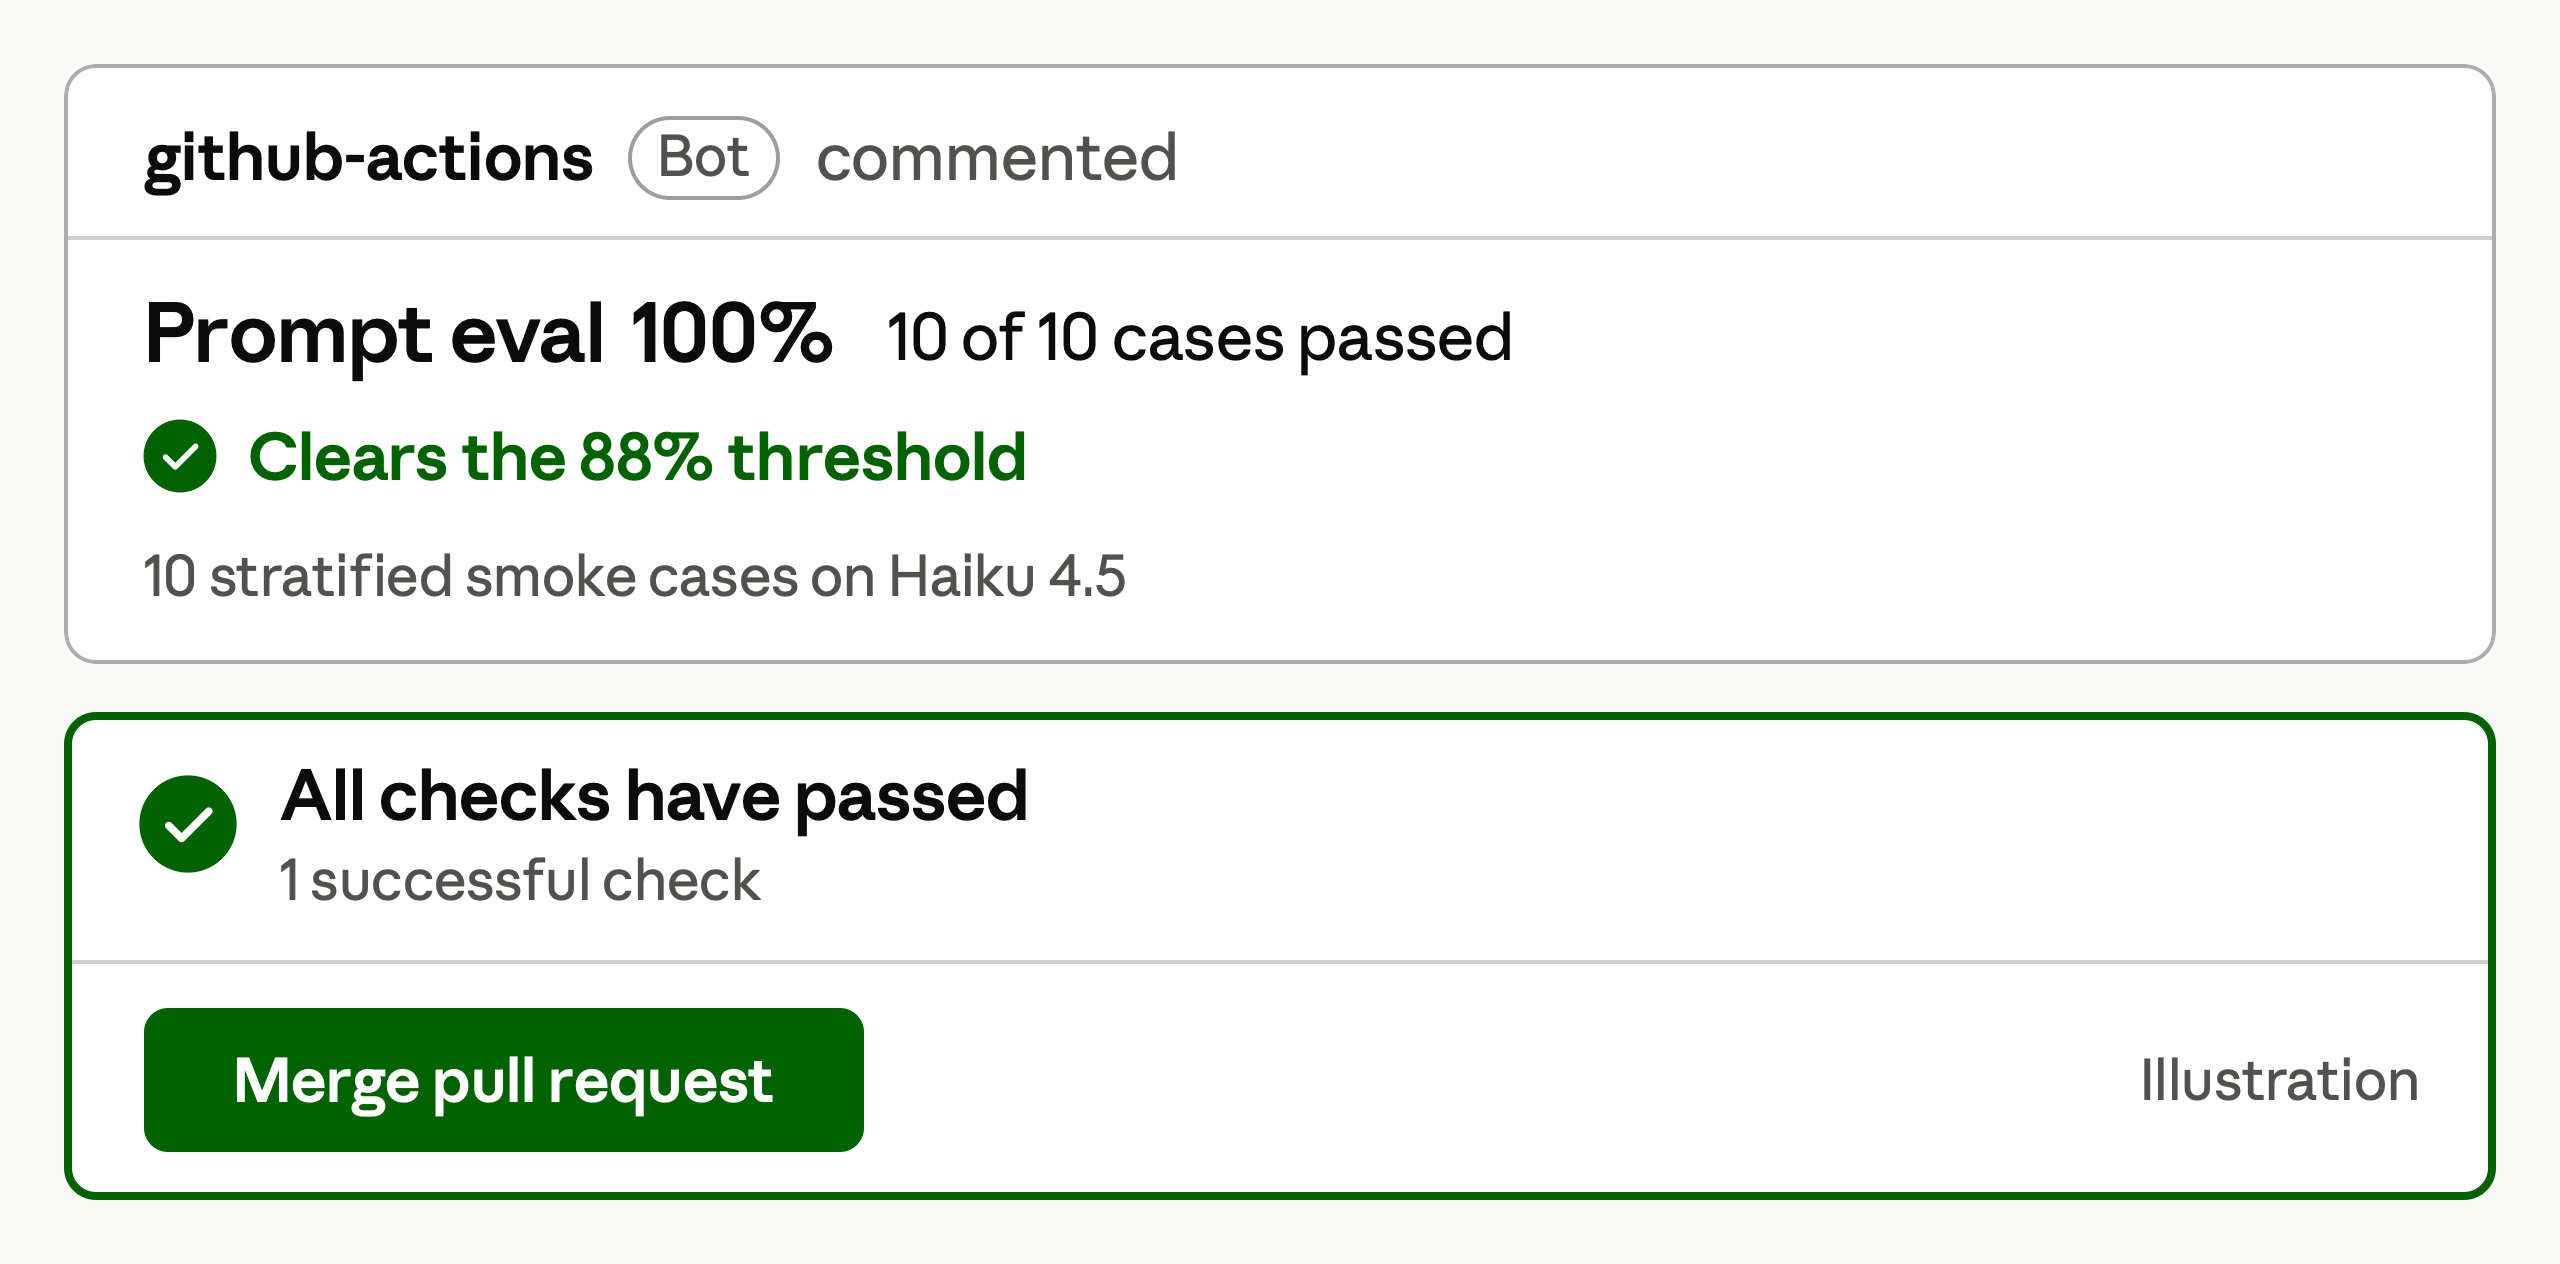
修复后每个用例都以100%通过,因此合并不再被阻止。
将完整套件作为一次批处理运行
每当您更改提示或模型时(在新标签页中打开),运行完整套件,并通过Batch API(在新标签页中打开)发送它。Meridian的评估会比较Haiku 4.5、Claude Sonnet 5和Claude Opus 5,因此其批处理包含150个请求,每个模型各50个用例。Batch API以输入和输出令牌通常价格的一半(在新标签页中打开)运行所有这些请求,您随后收集答案,通常在一小时内(在新标签页中打开)即可完成。
| 模型 | 标准价格 | Batch API价格 |
|---|---|---|
| Haiku 4.5 | $0.0468 | $0.0234 |
| Sonnet 5 | $0.1301 | $0.0650 |
| Opus 5 | $0.3432 | $0.1716 |
截至2026年8月,在每个模型上完成Meridian 50个用例一次所需的标准价格和Batch API价格。今日价格(在新标签页中打开)。
对没有人等待的请求使用批处理,对有人等待的请求使用标准方式(在新标签页中打开)。只有合并要等待的冒烟评估仍然使用client.messages.create(...)。
评估脚本需要做两处更改。
用custom_id标记每个请求。结果可能以任意顺序返回(在新标签页中打开),因此您需要通过这个标签来匹配它们,并且它在批处理中必须是唯一的。每个用例会发往三个模型,因此请将用例ID与模型拼接,例如r041_claude-haiku-4-5。
batch = client.messages.batches.create(
    requests=[
        {
            "custom_id": f"{case['id']}_{model}",
            "params": {
                "model": model,
                "max_tokens": 1024,
                "messages": [{"role": "user", "content": case["prompt"]}],
            },
        }
        for model in MODELS
        for case in CASES
    ]
)在评分之前先读取request_counts。它统计了每种结束方式的请求数量,这样就能看出某次运行是否返回不全。未在24小时内完成的批处理会过期(在新标签页中打开),而一个过期的请求不产生费用,但也没有答案(在新标签页中打开)。
batch = client.messages.batches.retrieve(batch.id)
print(batch.request_counts)

answers = {}
for result in client.messages.batches.results(batch.id):
    if result.result.type == "succeeded":
        answers[result.custom_id] = result.result.message
每晚对实时流量的样本进行评分
每晚对实时流量的一小部分样本进行评分,也就是您的应用处理的真实请求。完整套件只了解您在构建它时所拥有的报告,因此如果一个新客户开始发送一种您的用例都没有覆盖的格式的报告,即使答案变差,您的CI也会保持绿色。这种准确率的缓慢流失就是漂移。
具体方法如下:
- 采样。从实时流量中抽取1%到5%。
- 用LLM评判者(在新标签页中打开)对样本进行评分。那是第二个模型,它根据一套书面规则构成的评分标准对每个答案打分,只使用报告、Claude的答案和评分标准,因此不需要预期答案——而这正是实时流量所缺少的。尽管如此,您仍应时不时亲自阅读一些答案(在新标签页中打开),因为评判者也需要有人来检查。
- 仅在真正下降时发出警报。也就是某一晚的分数低于近期基线(最近几晚的平均值)超过两个标准差。两个标准差是比正常夜晚所带来的变化更大的变化。
- 将每个被评判者标记为不正确的答案做成一个用例。写出它的预期答案,然后把这个用例添加到完整套件中,因为来自真实失败的用例(在新标签页中打开)能让套件保持贴近真实使用情况。
实时流量会向您展示完整套件遗漏了什么,而您添加的每一个失败用例都会缩小这一差距。将1%到5%和两个标准差视为起点,再根据您自己的流量加以调整。
要点总结
- 让冒烟评估在每次拉取请求时运行,并让它的分数决定检查通过或失败。
- 将该检查设为必需项,使低分能够真正阻止合并。
- 将完整套件作为批处理运行,由于没有人在等待它,费用只有一半。
- 每晚对实时流量的样本进行评分,当分数下降超出正常范围时发出警报,并将每个失败转化为完整套件中的一个新用例。