Sampling을 사용하면 서버가 연결된 MCP 클라이언트를 통해 Claude와 같은 언어 모델에 접근할 수 있습니다. 서버가 직접 Claude를 호출하는 대신, 클라이언트에게 대신 호출을 수행해 달라고 요청합니다. 이렇게 하면 텍스트 생성의 책임과 비용이 서버에서 클라이언트로 이동합니다.
Sampling이 해결하는 문제
Wikipedia에서 정보를 가져오는 리서치 도구가 있는 MCP 서버가 있다고 상상해 보세요. 모든 데이터를 수집한 후, 이를 일관된 보고서로 요약해야 합니다. 두 가지 옵션이 있습니다:
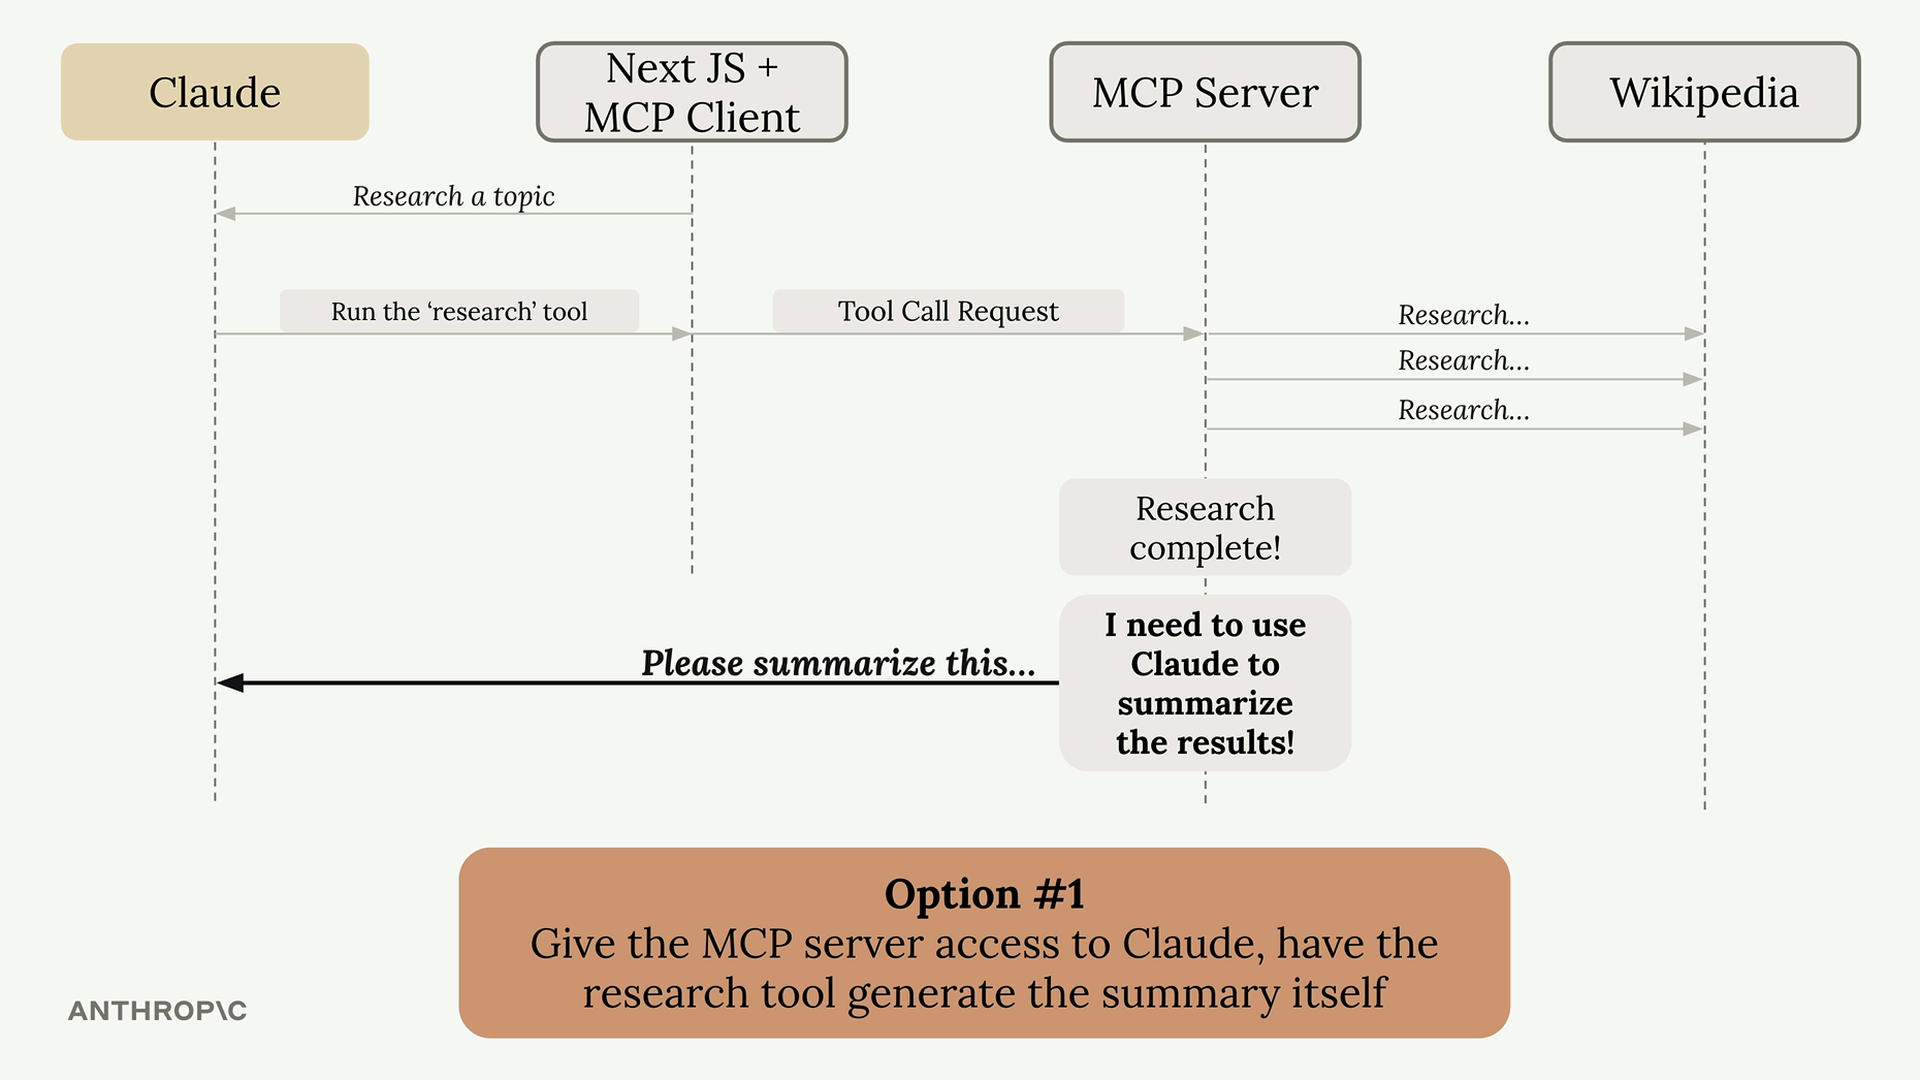
옵션 1: MCP 서버에 Claude에 대한 직접 접근 권한을 부여합니다. 서버는 자체 API 키가 필요하고, 인증을 처리하고, 비용을 관리하고, 모든 Claude 통합 코드를 구현해야 합니다. 이 방식은 작동하지만 상당한 복잡성을 추가합니다.
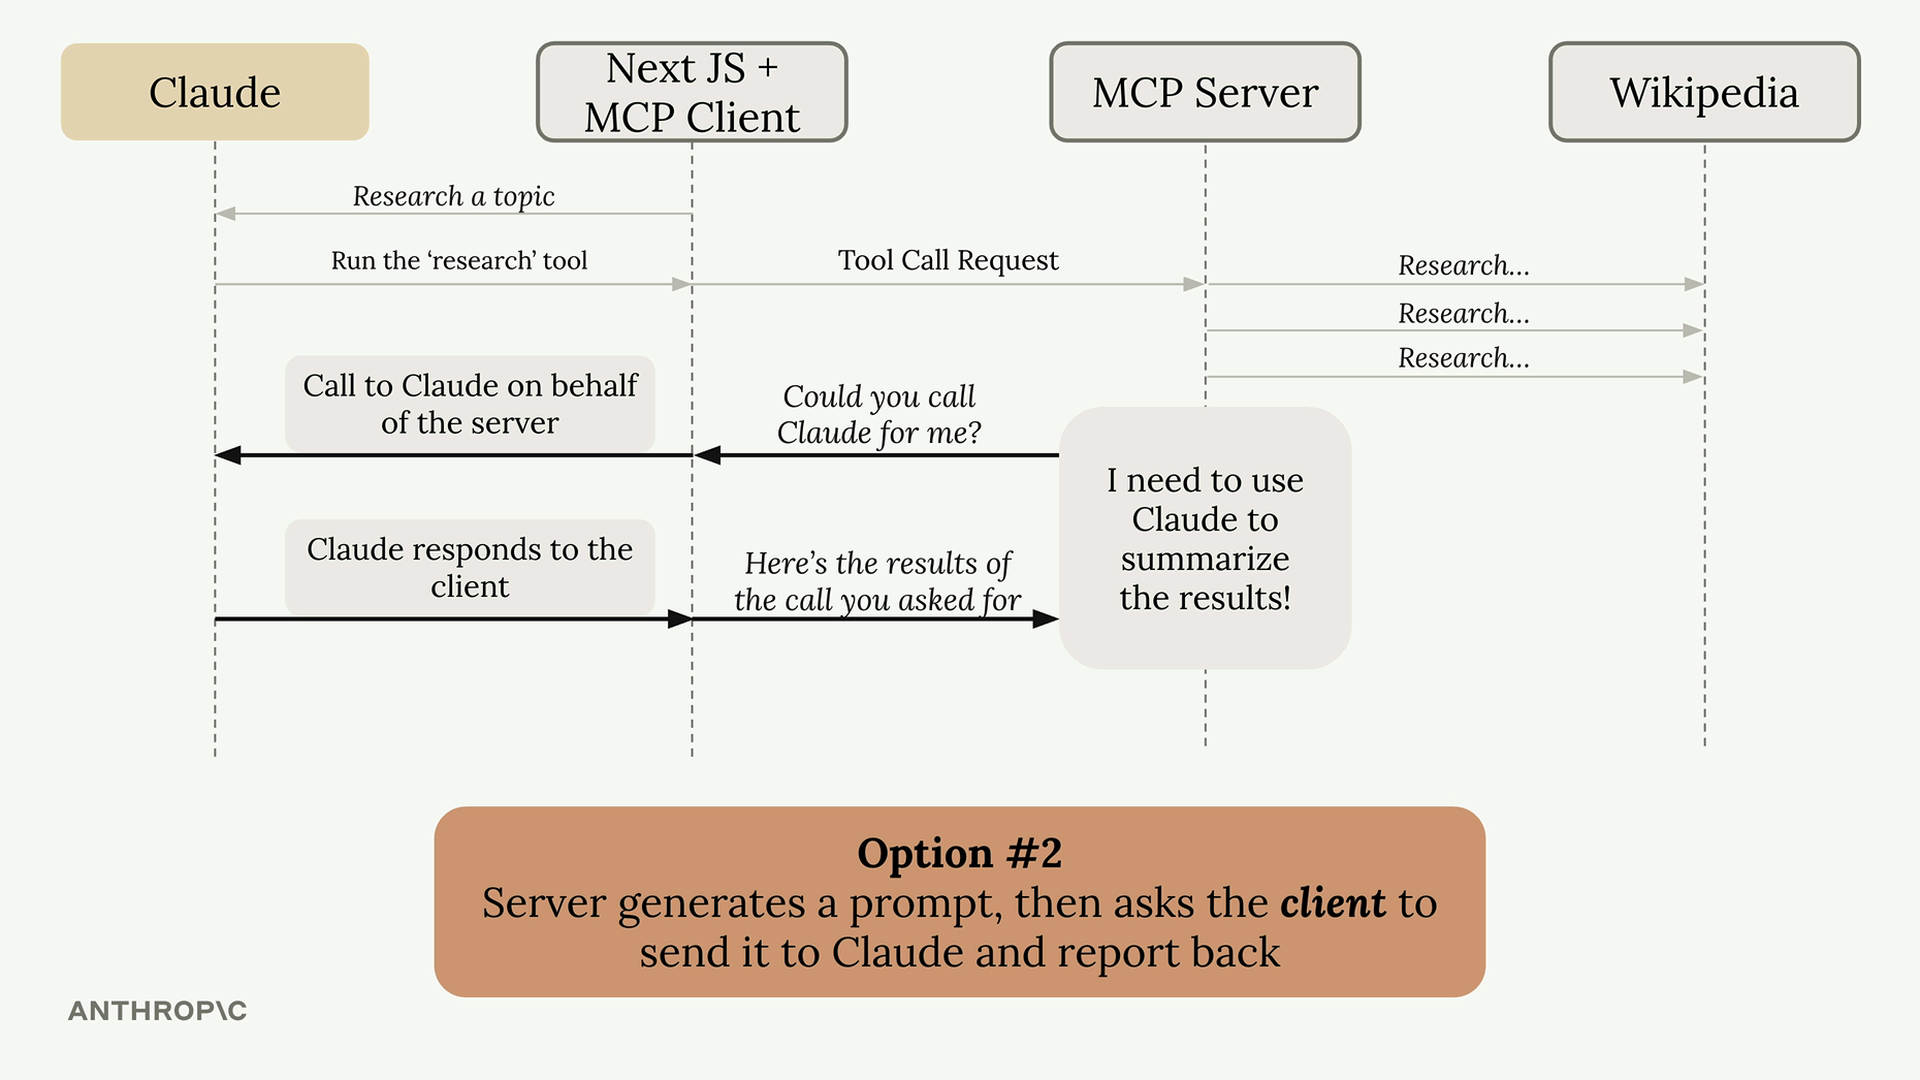
옵션 2: Sampling을 사용합니다. 서버는 프롬프트를 생성하고 클라이언트에게 "저 대신 Claude를 호출해 주시겠어요?"라고 요청합니다. 이미 Claude와 연결되어 있는 클라이언트가 호출을 수행하고 결과를 반환합니다.
Sampling의 작동 방식
흐름은 간단합니다:
- 서버가 작업을 완료합니다(예: Wikipedia 문서 가져오기)
- 서버가 텍스트 생성을 요청하는 프롬프트를 생성합니다
- 서버가 클라이언트에게 sampling 요청을 보냅니다
- 클라이언트가 제공된 프롬프트로 Claude를 호출합니다
- 클라이언트가 생성된 텍스트를 서버에 반환합니다
- 서버가 생성된 텍스트를 응답에 사용합니다
Sampling의 이점
- 서버 복잡성 감소: 서버가 언어 모델과 직접 통합할 필요가 없습니다
- 비용 부담 이동: 서버가 아닌 클라이언트가 토큰 사용 비용을 지불합니다
- API 키 불필요: 서버가 Claude에 대한 자격 증명이 필요하지 않습니다
- 공개 서버에 적합: 모든 사용자에 대해 공개 서버가 AI 비용을 쌓아가는 것을 원하지 않을 것입니다
구현
Sampling을 설정하려면 양쪽 모두에 코드가 필요합니다:
서버 측
도구 함수에서 create_message 함수를 사용하여 텍스트 생성을 요청하세요:
@mcp.tool()
async def summarize(text_to_summarize: str, ctx: Context):
    prompt = f"""
    Please summarize the following text:
    {text_to_summarize}
    """

    result = await ctx.session.create_message(
        messages=[
            SamplingMessage(
                role="user",
                content=TextContent(
                    type="text",
                    text=prompt
                )
            )
        ],
        max_tokens=4000,
        system_prompt="You are a helpful research assistant",
    )

    if result.content.type == "text":
        return result.content.text
    else:
        raise ValueError("Sampling failed")
클라이언트 측
서버의 요청을 처리하는 sampling 콜백을 생성하세요:
async def sampling_callback(
    context: RequestContext, params: CreateMessageRequestParams
):
    # Anthropic SDK를 사용하여 Claude 호출
    text = await chat(params.messages)

    return CreateMessageResult(
        role="assistant",
        model=model,
        content=TextContent(type="text", text=text),
    )
그런 다음 클라이언트 세션을 초기화할 때 이 콜백을 전달하세요:
async with ClientSession(
    read,
    write,
    sampling_callback=sampling_callback
) as session:
    await session.initialize()
Sampling을 사용해야 할 때
Sampling은 공개적으로 접근 가능한 MCP 서버를 구축할 때 가장 유용합니다. 무작위 사용자가 여러분의 비용으로 무제한 텍스트를 생성하는 것을 원하지 않을 것입니다. Sampling을 사용하면 각 클라이언트가 자신의 AI 사용량에 대해 비용을 지불하면서도 여전히 서버의 기능을 활용할 수 있습니다.
이 기법은 본질적으로 AI 통합의 복잡성을 서버에서 클라이언트로 이동시키며, 클라이언트는 이미 필요한 연결과 자격 증명을 갖추고 있는 경우가 많습니다.