프로덕션 환경에서의 평가: CI, 배치, 드리프트
평가는 출시 후에도 해야 할 일이 남아 있습니다. 모든 풀 리퀘스트에서, 고객이 잘못된 답을 받기 전에 케이스를 깨뜨리는 프롬프트 변경을 잡아냅니다. 또한 실제 트래픽을 채점하여 실제 입력이 변함에 따라 정확도가 서서히 떨어지는 드리프트를 포착합니다.
이 영상의 데모는 2026년 8월에 녹화되었습니다. Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5에서 실행되었습니다. 최신 모델에서는 결과가 다를 수 있습니다. 각 레슨의 데모는 별도의 평가 실행이므로, 점수와 비용은 다른 레슨의 결과와 일치하지 않습니다.
평가는 출시 후에도 계속 실행되는데, 두 가지가 계속 바뀌기 때문입니다. 팀은 프롬프트를 수정할 것이고, 수정으로 인해 맞았던 답이 틀려질 수 있습니다. 실제 입력 또한 테스트했던 것과 더 이상 비슷하지 않을 때까지 변합니다. 그래서 평가는 배포되기 전 모든 수정마다 실행되고, 배포 후에는 실제 트래픽에 대해 실행됩니다.
이 레슨은 가상의 엔지니어링 컨설팅 회사인 Meridian을 따라갑니다. Meridian의 프롬프트는 매월 작성되는 프로젝트 보고서를 읽고 프로젝트 ID, 일정 상태, 최우선 리스크라는 세 가지 필드를 반환합니다. Meridian의 평가는 50개의 케이스로 구성됩니다. 각 케이스는 보고서와 그에 대해 기대하는 답변으로 이루어지며, 이 50개가 모두 합쳐져 전체 스위트를 구성합니다.
다음 네 단계는 출시 후에도 Meridian의 평가가 계속 작동하도록 유지합니다:
- 모든 풀 리퀘스트에서 몇 개의 케이스를 실행합니다.
- 통과할 때까지 풀 리퀘스트가 병합되지 않도록 합니다.
- 전체 스위트를 하나의 배치로 실행합니다.
- 매일 밤 실제 트래픽의 샘플을 채점합니다.
모든 풀 리퀘스트에서 몇 개의 케이스 실행하기
지속적 통합(continuous integration)을 줄인 말인 CI에 워크플로우를 추가하고, 각 풀 리퀘스트마다 실행되도록 하세요. 이 워크플로우는 스모크 평가를 실행하는데, 이는 전체 스위트의 케이스 중 기다리는 동안 끝낼 수 있을 만큼 적은 수만 가져옵니다. 이 평가의 점수는 풀 리퀘스트의 체크를 통과시키거나 실패시킵니다. Meridian은 모든 종류의 보고서를 다루기 위해 50개 케이스 중 10개를 선택하고, 이를 Claude Haiku 4.5에서 약 1분 만에 실행합니다.
임계값은 통과 가능한 최저 점수이며, Meridian의 임계값은 88%이므로 10개 중 9개의 케이스가 성공해야 합니다. 워크플로우는 다음 순서로 네 가지 작업을 수행합니다:
- 평가 스크립트를 실행하고 그 결과를 JSON으로 저장합니다.
- 그 결과를 임계값과 비교해 채점합니다.
- 결과를 풀 리퀘스트에 댓글로 남깁니다.
- 점수가 임계값보다 낮으면 체크를 실패시킵니다.
Meridian은 이를 위해 GitHub Actions를 사용하지만, 평가 스크립트를 실행할 수 있는 어떤 CI 시스템이든 동일한 네 가지 작업을 수행할 수 있습니다. 파일 자체는 아래 상자에 있습니다.
통과할 때까지 풀 리퀘스트 병합 막기
스모크 평가를 필수 체크(required check)(새 탭에서 열림)로 만드는 브랜치 보호 규칙을 켜세요. 이는 풀 리퀘스트가 병합되기 전에 반드시 통과해야 하는 체크입니다. 이 규칙은 워크플로우 파일이 아니라 브랜치에 속하며, 이 규칙이 없으면 빨간 X는 그저 경고일 뿐입니다.
Meridian에서 한 엔지니어가 두 가지 규칙을 없애는 "추출 프롬프트 단순화"라는 풀 리퀘스트를 엽니다. 하나는 보고서에 최우선 리스크가 없을 때 Claude가 null을 반환하도록 지시하는 규칙이었고, 다른 하나는 Claude가 답하기 전에 리스크가 나온 줄을 인용하도록 하는 규칙이었습니다.
이번 실행은 80%를 기록해 88% 임계값에 미치지 못합니다. 두 실패 모두 리스크 누락(missing-risk) 케이스, 즉 리스크 섹션이 없는 보고서로, 각각 null이 돌아왔어야 하지만 Claude는 그래도 리스크를 하나 지목했습니다.
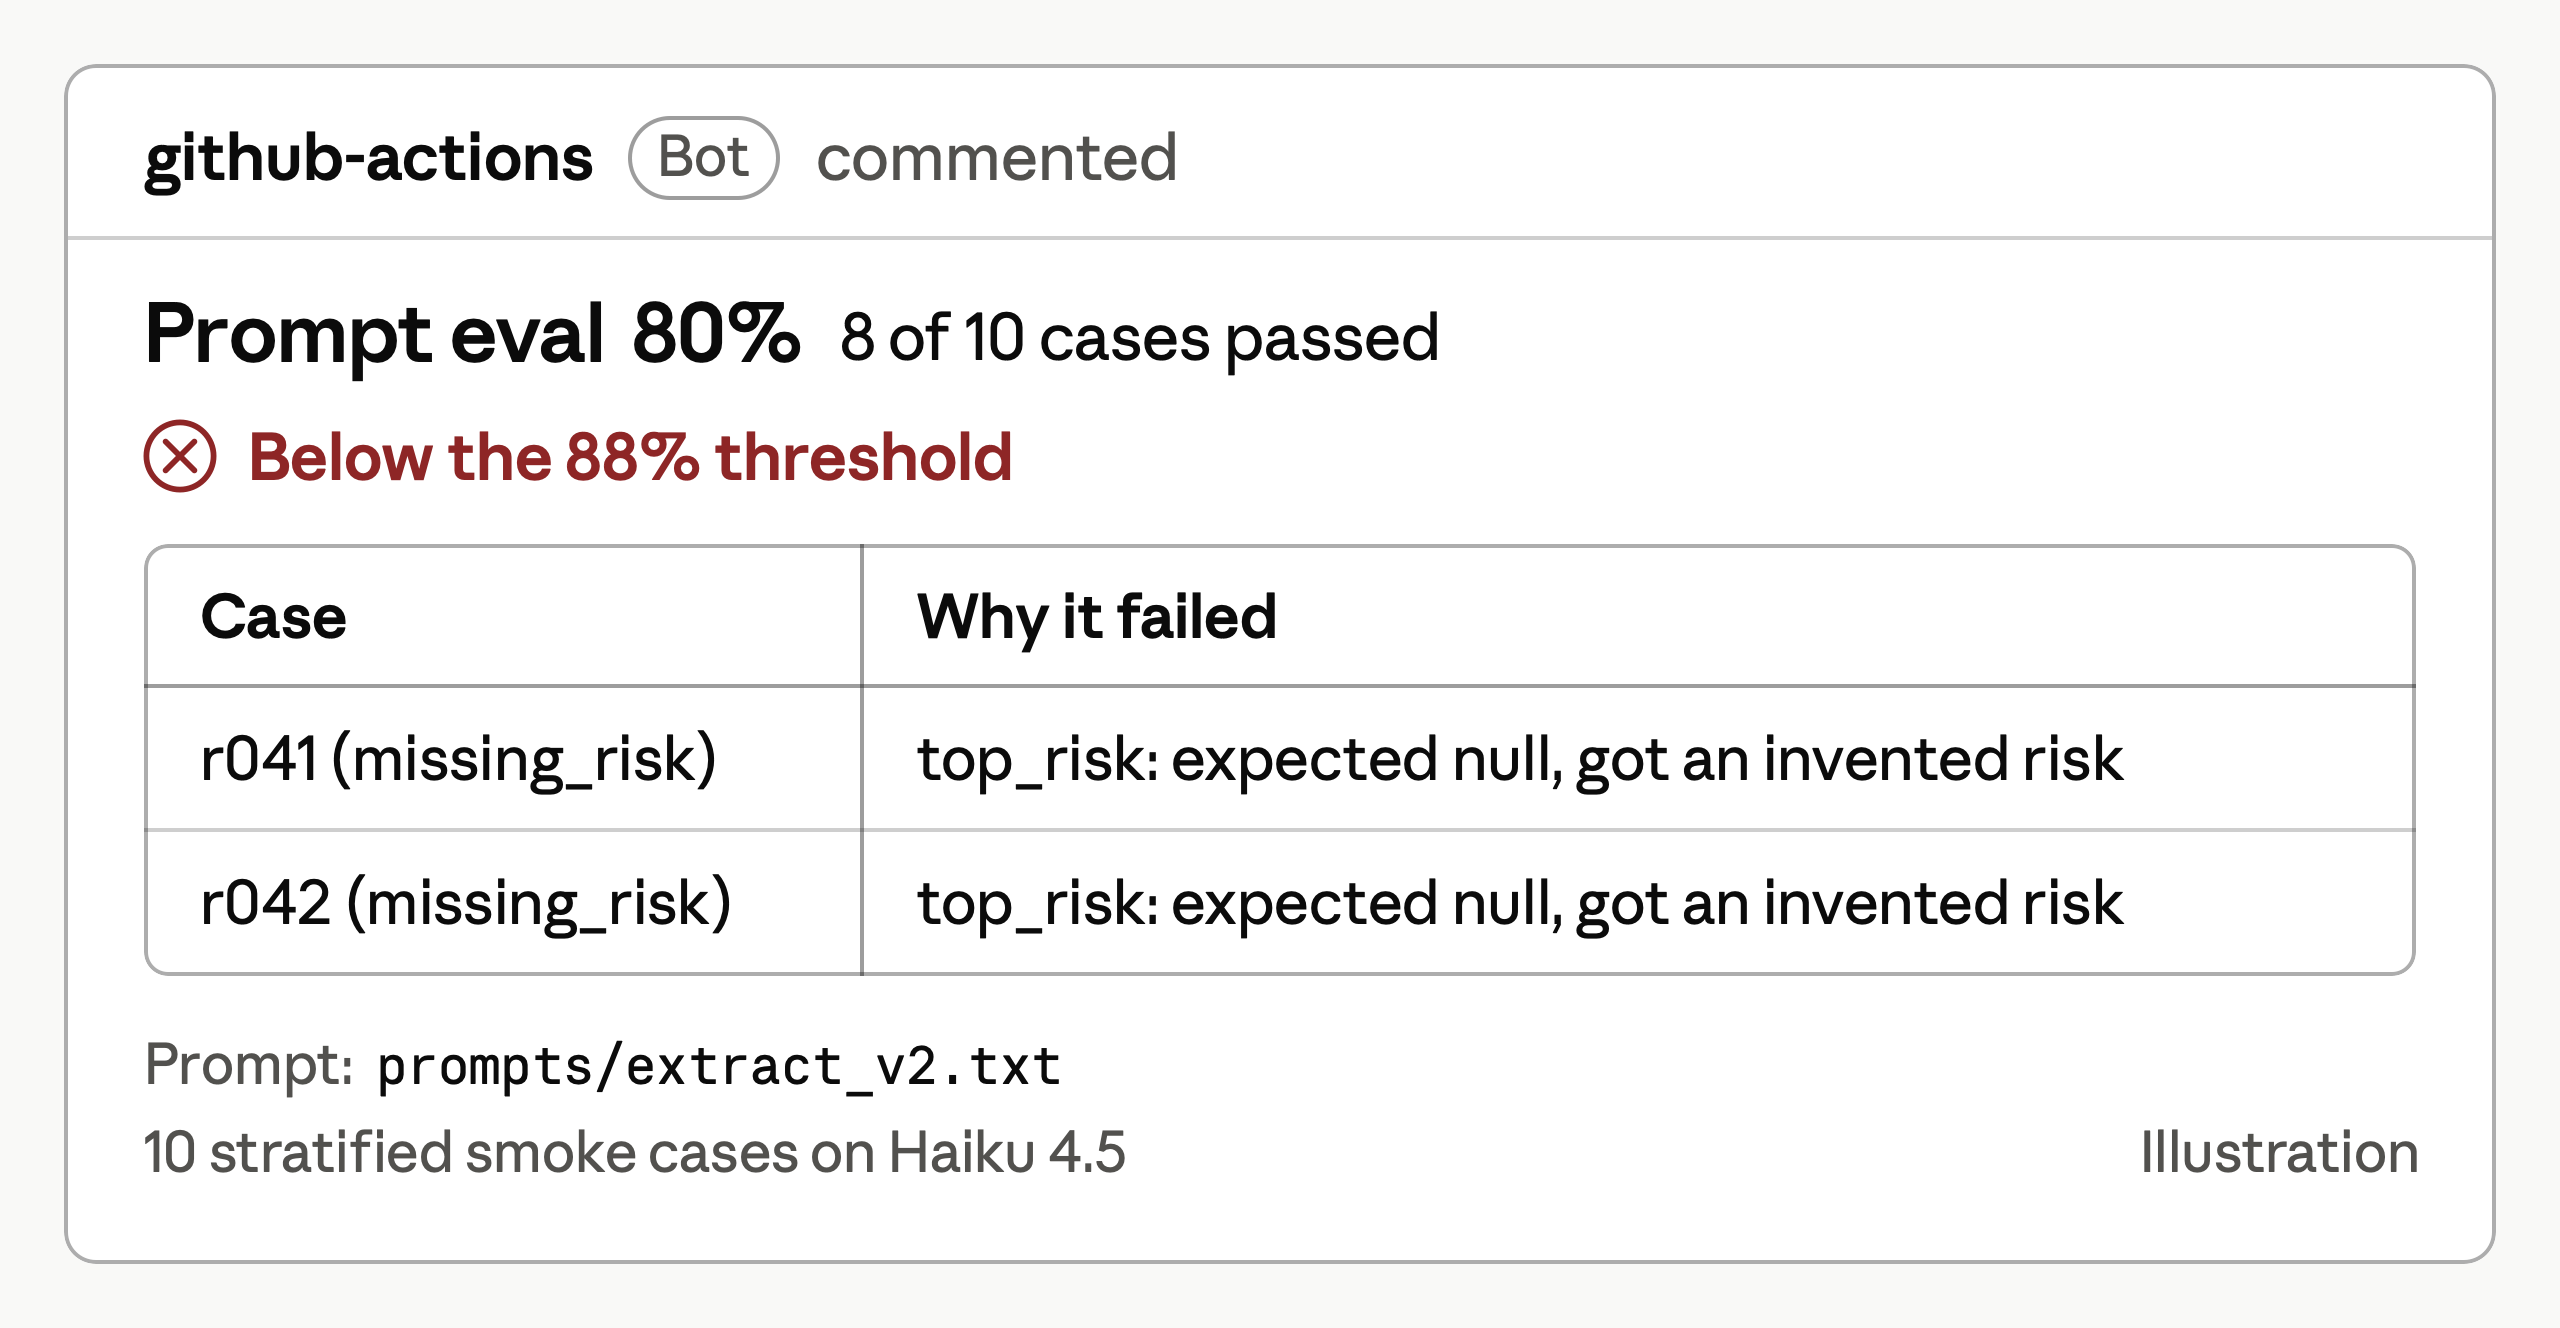
스모크 평가는 80%를 기록하며 88% 임계값에 미치지 못하는데, 두 개의 리스크 누락 케이스에서 Claude가 보고서에 없는 리스크를 지목했기 때문입니다.
빨간 체크는 병합 버튼을 회색으로 유지시키고, 댓글은 엔지니어에게 어떤 케이스가 깨졌는지 보여줍니다: r041과 r042. 프롬프트가 수정되어 푸시되면 체크는 초록색이 되고 병합이 진행될 수 있으므로, 고객은 깨진 프롬프트를 전혀 보지 못했습니다.
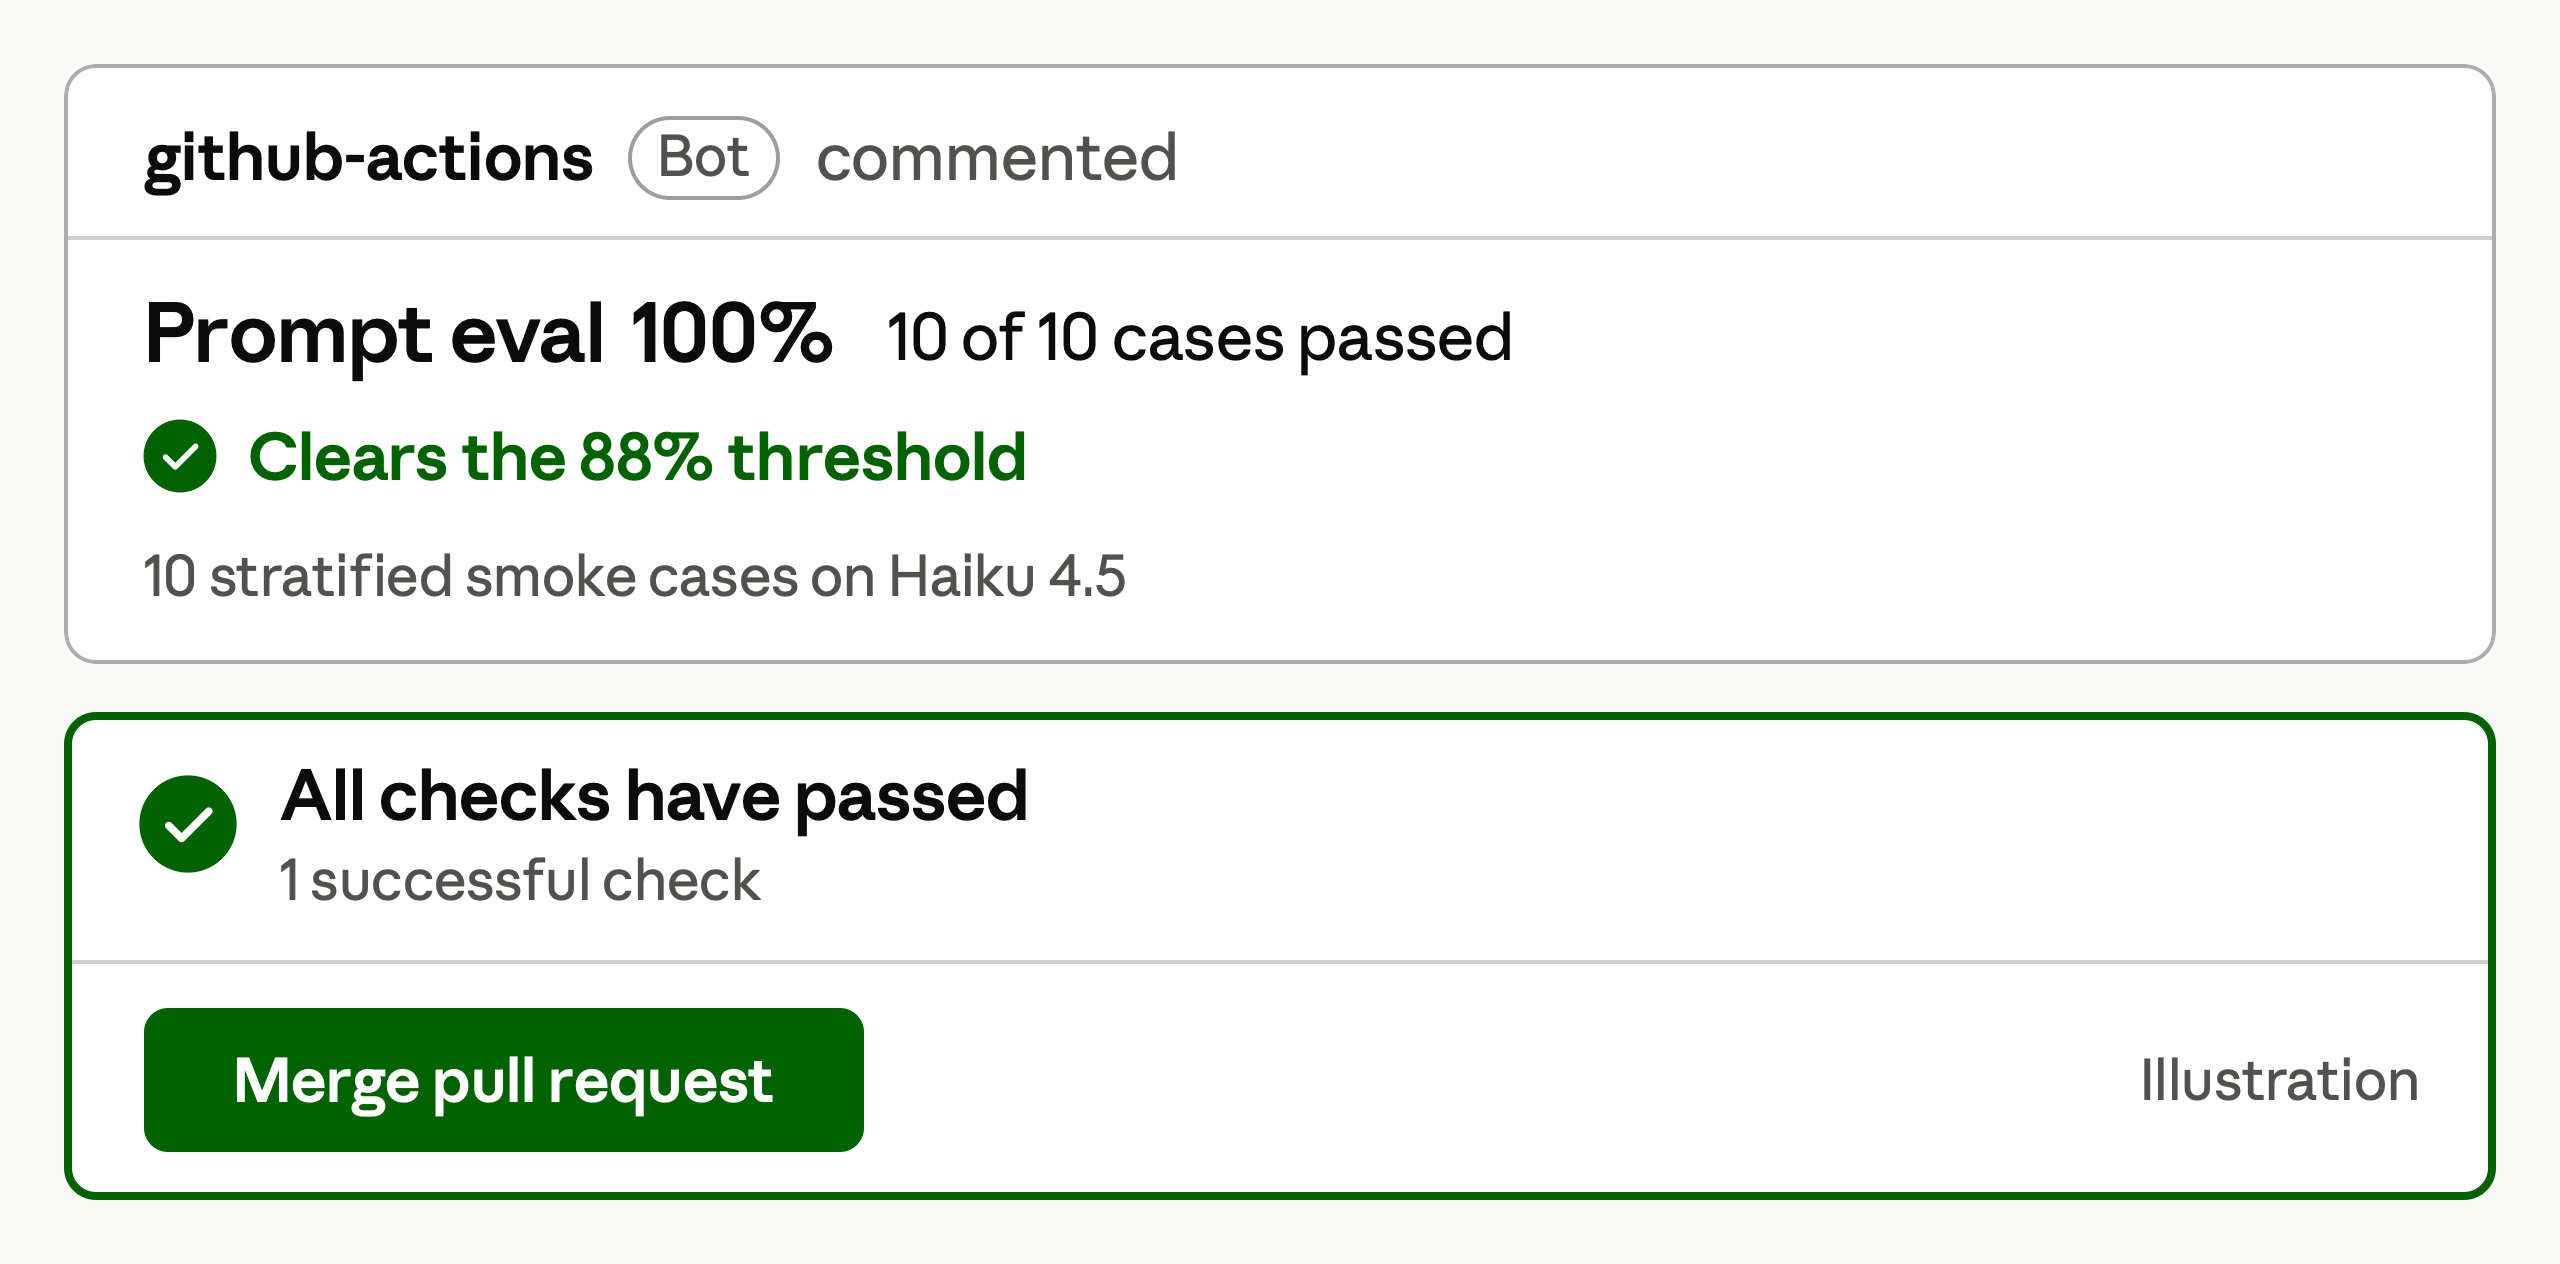
수정 후에는 모든 케이스가 100%로 통과하여, 더 이상 병합이 막히지 않습니다.
전체 스위트를 하나의 배치로 실행하기
프롬프트나 모델을 변경할 때마다(새 탭에서 열림) 전체 스위트를 실행하고, Batch API(새 탭에서 열림)를 통해 전송하세요. Meridian의 평가는 Haiku 4.5, Claude Sonnet 5, Claude Opus 5를 비교하므로, 배치에는 각 모델당 50개씩 총 150개의 요청이 들어갑니다. Batch API는 이를 모두 입력 및 출력 토큰의 평소 가격의 절반(새 탭에서 열림)으로 실행하며, 답변은 나중에 보통 한 시간 이내에(새 탭에서 열림) 수집됩니다.
| 모델 | 표준 가격 | Batch API 가격 |
|---|---|---|
| Haiku 4.5 | $0.0468 | $0.0234 |
| Sonnet 5 | $0.1301 | $0.0650 |
| Opus 5 | $0.3432 | $0.1716 |
2026년 8월 기준, 각 모델에서 Meridian의 50개 케이스를 한 번 실행할 때의 표준 가격 및 Batch API 가격입니다. 현재 가격(새 탭에서 열림).
아무도 기다리지 않는 요청은 배치로 처리하고, 누군가 기다리는 요청에는 표준 방식을 사용하세요(새 탭에서 열림). 병합이 기다리는 스모크 평가만 client.messages.create(...)를 그대로 사용합니다.
평가 스크립트에는 두 가지 변경이 필요합니다.
각 요청에 custom_id로 레이블을 붙이세요. 결과는 어떤 순서로든 도착할 수 있으므로(새 탭에서 열림), 이 레이블로 결과를 매칭하며, 이 레이블은 배치 내에서 고유해야 합니다. 각 케이스는 세 개의 모델로 전송되므로, r041_claude-haiku-4-5처럼 케이스 ID와 모델을 결합하세요.
batch = client.messages.batches.create(
    requests=[
        {
            "custom_id": f"{case['id']}_{model}",
            "params": {
                "model": model,
                "max_tokens": 1024,
                "messages": [{"role": "user", "content": case["prompt"]}],
            },
        }
        for model in MODELS
        for case in CASES
    ]
)
채점하기 전에 request_counts를 확인하세요. 이는 각 방식으로 종료된 요청 수를 집계하여, 실행 결과가 부족하게 돌아온 경우를 보여줍니다. 24시간 이내에 완료되지 않은 배치는 만료되며(새 탭에서 열림), 만료된 요청은 비용이 들지 않지만 답변도 없습니다(새 탭에서 열림).
batch = client.messages.batches.retrieve(batch.id)
print(batch.request_counts)

answers = {}
for result in client.messages.batches.results(batch.id):
    if result.result.type == "succeeded":
        answers[result.custom_id] = result.result.message
매일 밤 실제 트래픽의 샘플 채점하기
매일 밤, 앱이 처리하는 실제 요청인 실제 트래픽의 작은 샘플을 채점하세요. 전체 스위트는 구축 당시 가지고 있던 보고서만 알고 있으므로, 새 클라이언트가 어떤 케이스로도 다루지 않는 형식의 보고서를 보내기 시작하면, 답변의 품질이 나빠지는 동안에도 CI는 계속 초록색을 유지합니다. 이렇게 정확도가 서서히 떨어지는 것이 드리프트입니다.
방법은 다음과 같습니다:
- 샘플링. 실제 트래픽의 1~5%를 추출합니다.
- LLM 심사자(새 탭에서 열림)로 샘플을 채점합니다. 이는 보고서, Claude의 답변, 루브릭만을 사용하여 문서화된 규칙의 루브릭에 따라 각 답변을 채점하는 두 번째 모델로, 실제 트래픽에는 없는 기대 답변이 필요하지 않습니다. 그래도 가끔은 직접 몇 개의 답변을 읽어보세요(새 탭에서 열림), 심사자도 사람의 점검이 필요하기 때문입니다.
- 실제로 하락했을 때만 알림을 보냅니다. 이는 최근 며칠 밤의 평균인 이동 기준선보다 표준편차 2배 이상 낮은 밤의 점수를 의미합니다. 표준편차 2배는 평범한 밤에 나타나는 변화보다 큰 변화입니다.
- 심사자가 오답으로 표시한 각 답변을 케이스로 만듭니다. 기대 답변을 작성한 다음 그 케이스를 전체 스위트에 추가하세요. 실제 실패에서 나온 케이스(새 탭에서 열림)가 스위트를 실제 사용에 가깝게 유지해주기 때문입니다.
실제 트래픽은 전체 스위트가 놓치는 부분을 보여주며, 추가하는 각 실패 사례는 그 간극을 좁혀줍니다. 1~5%와 표준편차 2배라는 수치는 자신의 트래픽에 맞게 조정할 출발점으로 다루세요.
핵심 요약
- 각 풀 리퀘스트에서 스모크 평가를 실행시키고, 그 점수로 체크의 통과 또는 실패를 결정하게 하세요.
- 해당 체크를 필수로 만들어, 낮은 점수가 실제로 병합을 막도록 하세요.
- 전체 스위트를 배치로 실행하세요. 아무도 기다리지 않으므로 비용은 절반입니다.
- 매일 밤 실제 트래픽의 샘플을 채점하고, 점수가 평소보다 더 크게 떨어지면 알림을 보내며, 모든 실패를 전체 스위트의 새로운 케이스로 만드세요.