확장 사고는 Claude가 최종 응답을 생성하기 전에 복잡한 문제를 추론할 시간을 주는 고급 기능입니다. Claude의 내적 독백이라고 생각하면 됩니다 - Claude가 문제에 단계별로 어떻게 접근하는지 볼 수 있습니다.
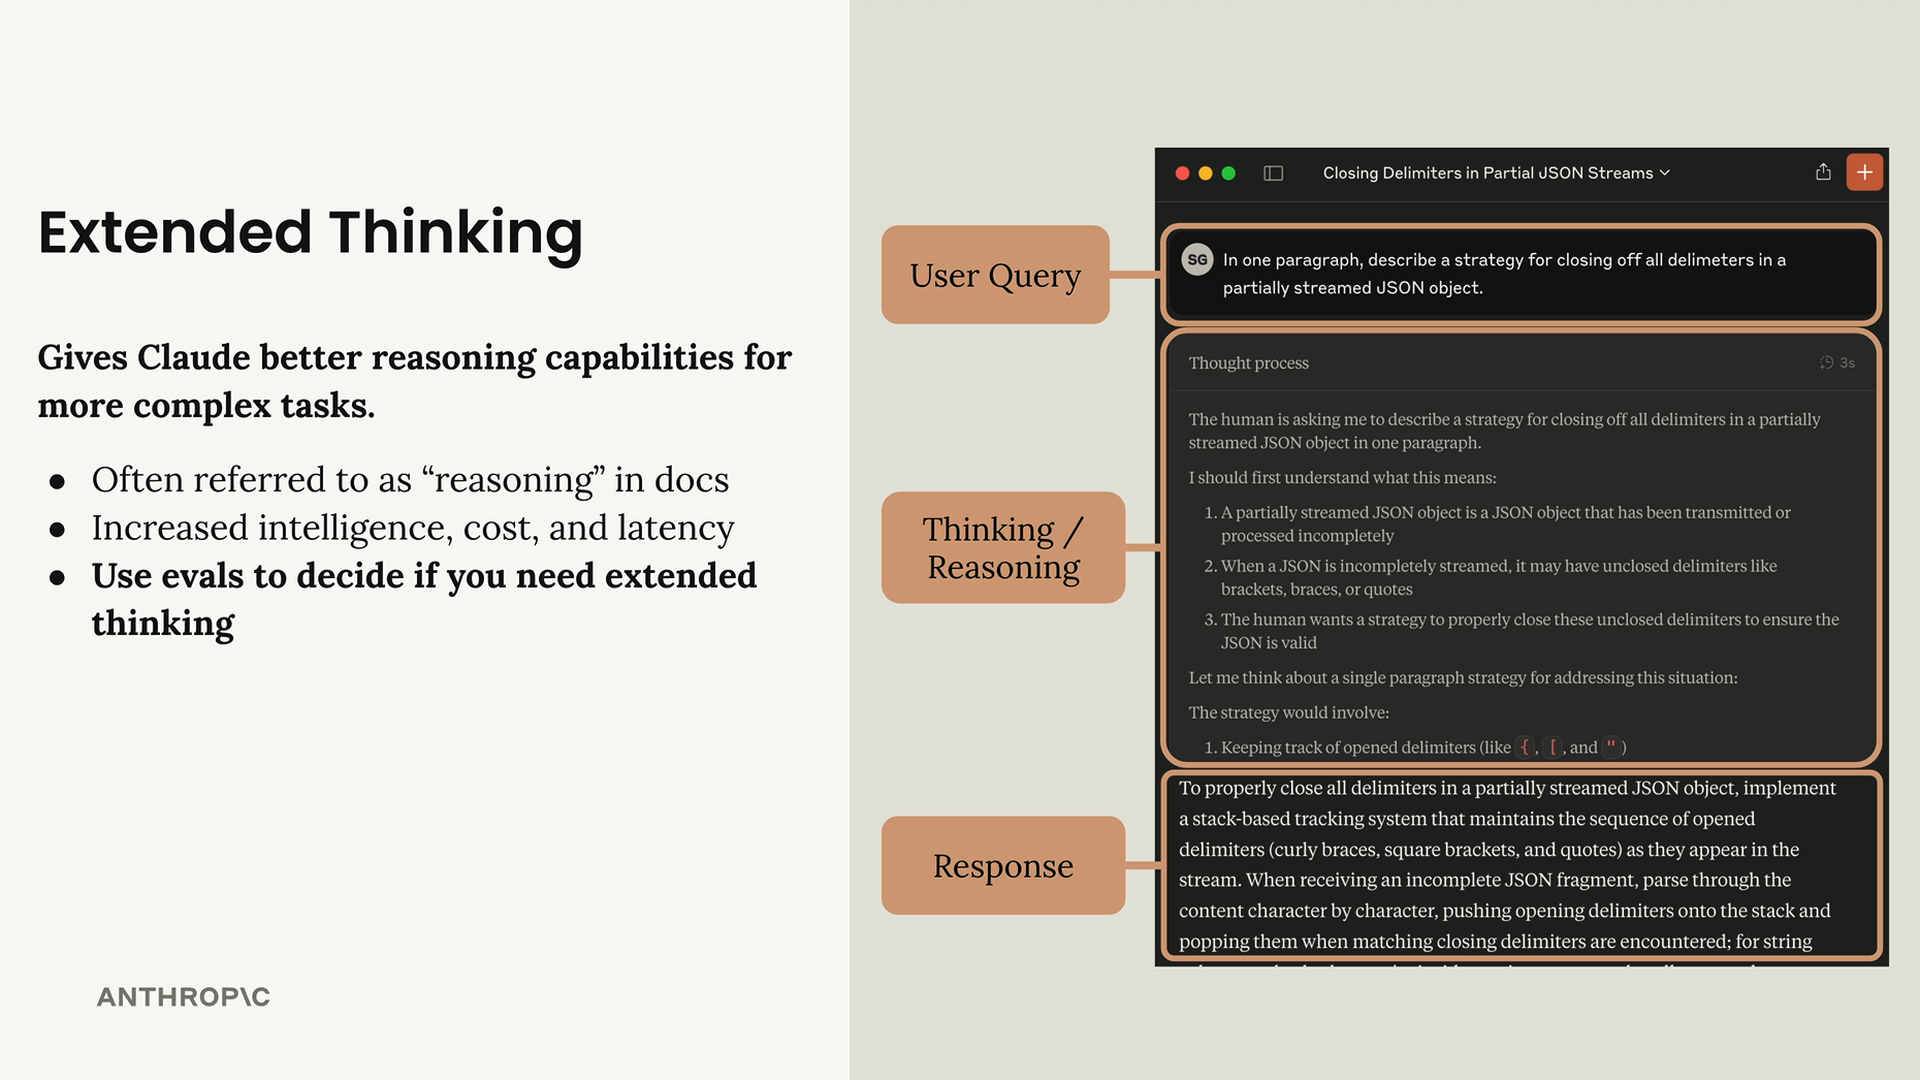
확장 사고의 작동 방식
확장 사고를 활성화하면 Claude의 응답은 하나가 아닌 두 부분으로 구성됩니다:
- 추론 콘텐츠 부분 - Claude의 내부 사고 과정
- 텍스트 부분 - 실제로 원했던 최종 응답
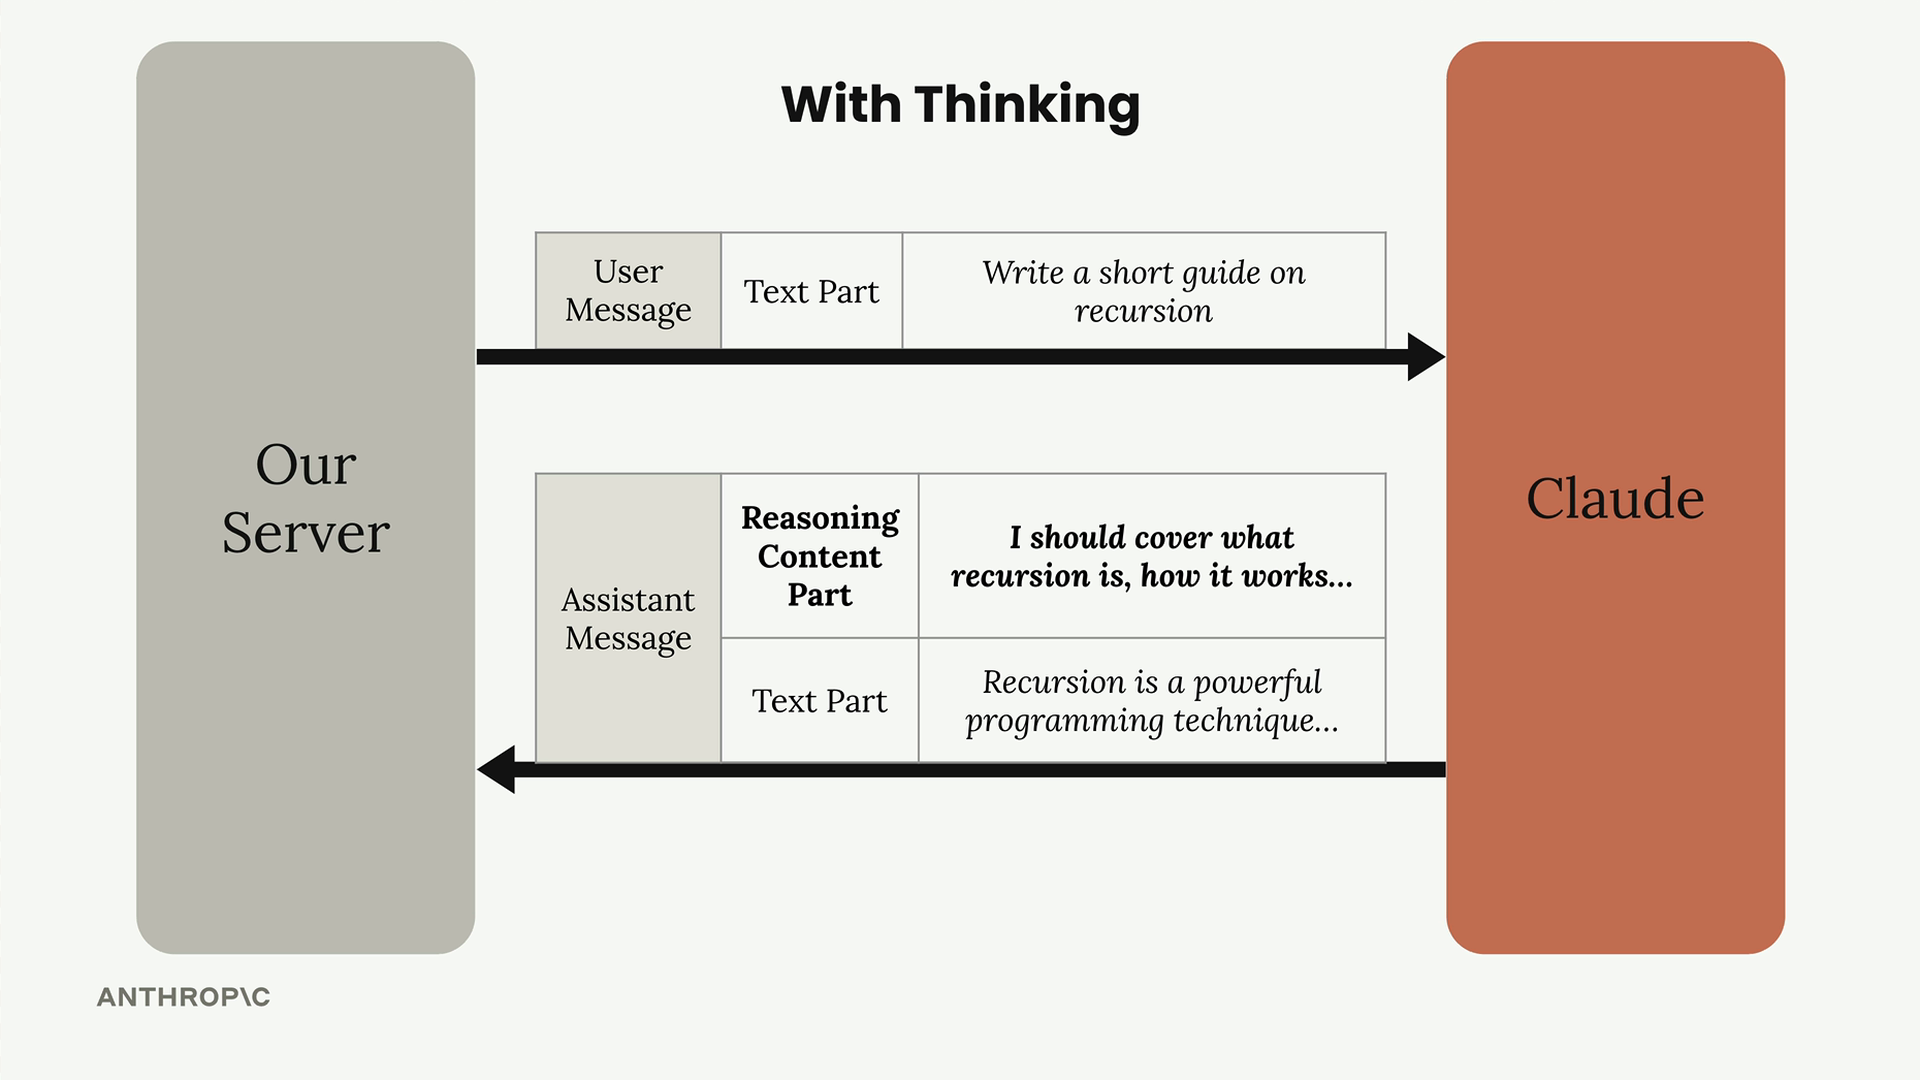
추론 콘텐츠는 Claude가 문제를 어떻게 분석하는지, 무엇을 고려하는지, 그리고 최종 답변에 어떻게 도달하는지를 정확히 보여줍니다. 이러한 투명성은 복잡한 작업을 이해하고 디버깅하는 데 매우 유용할 수 있습니다.
고려해야 할 트레이드오프
확장 사고에는 명확한 이점과 비용이 따릅니다:
- 복잡한 작업에서 더 나은 정확도
- 더 높은 비용 - 모든 사고 토큰에 대해 비용을 지불합니다
- 증가된 지연 시간 - 사고에는 시간이 걸립니다
핵심 결정 기준은 간단합니다: 평가를 활용하세요. 이미 프롬프트를 최적화했는데도 필요한 정확도를 얻지 못하고 있다면, 그때가 확장 사고를 고려할 가치가 있는 시점입니다.
서명 시스템
즉시 눈에 띄는 중요한 세부 사항 중 하나는 추론 콘텐츠에 첨부된 암호화 서명입니다:
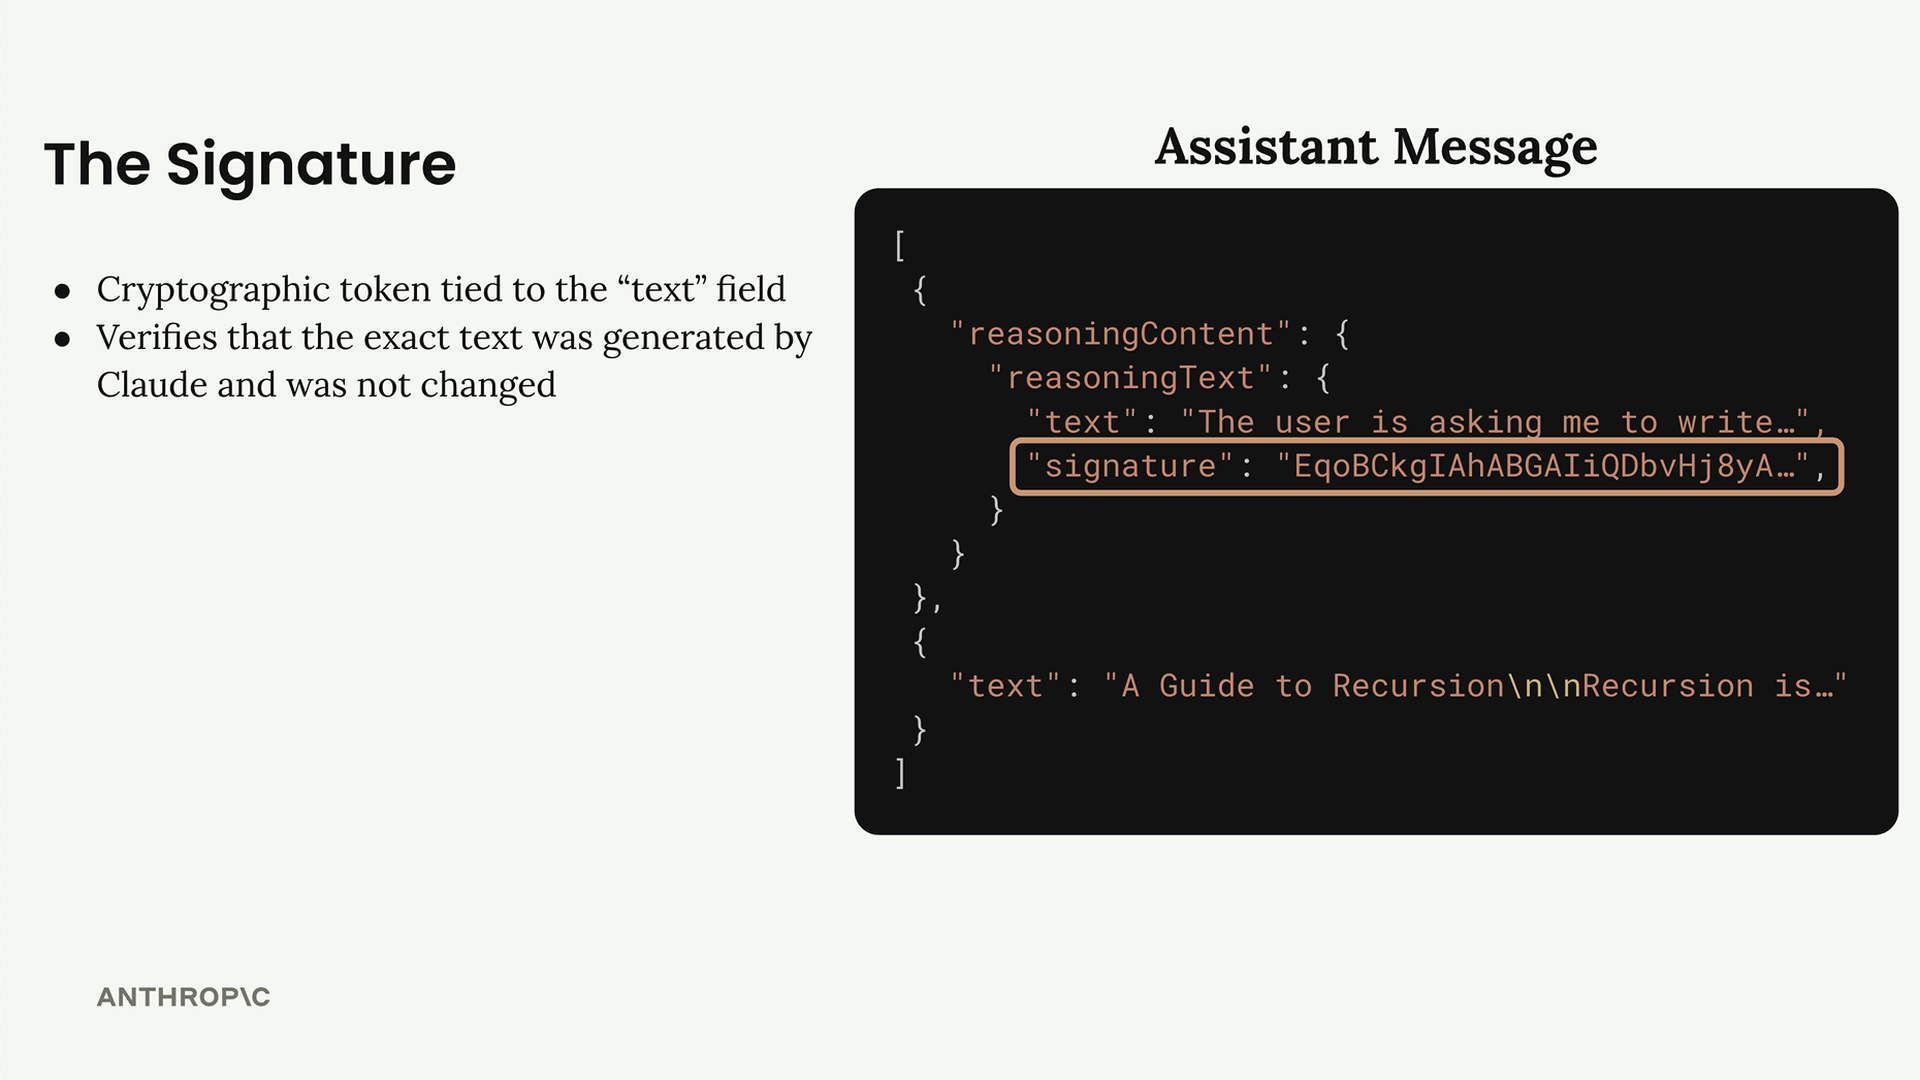
이 서명은 사고 텍스트를 수정할 수 없도록 보장합니다. 후속 대화에서 Claude의 이전 추론을 포함하려는 경우, 서명은 콘텐츠가 변조되지 않았음을 확인합니다. 이는 수정된 추론 텍스트로 인한 잠재적 안전 문제를 방지합니다.
편집된 콘텐츠
때때로 Claude의 사고가 안전 시스템에 의해 플래그가 지정됩니다. 이런 경우, 읽을 수 있는 사고 텍스트 대신 redactedContent 필드를 받게 됩니다:
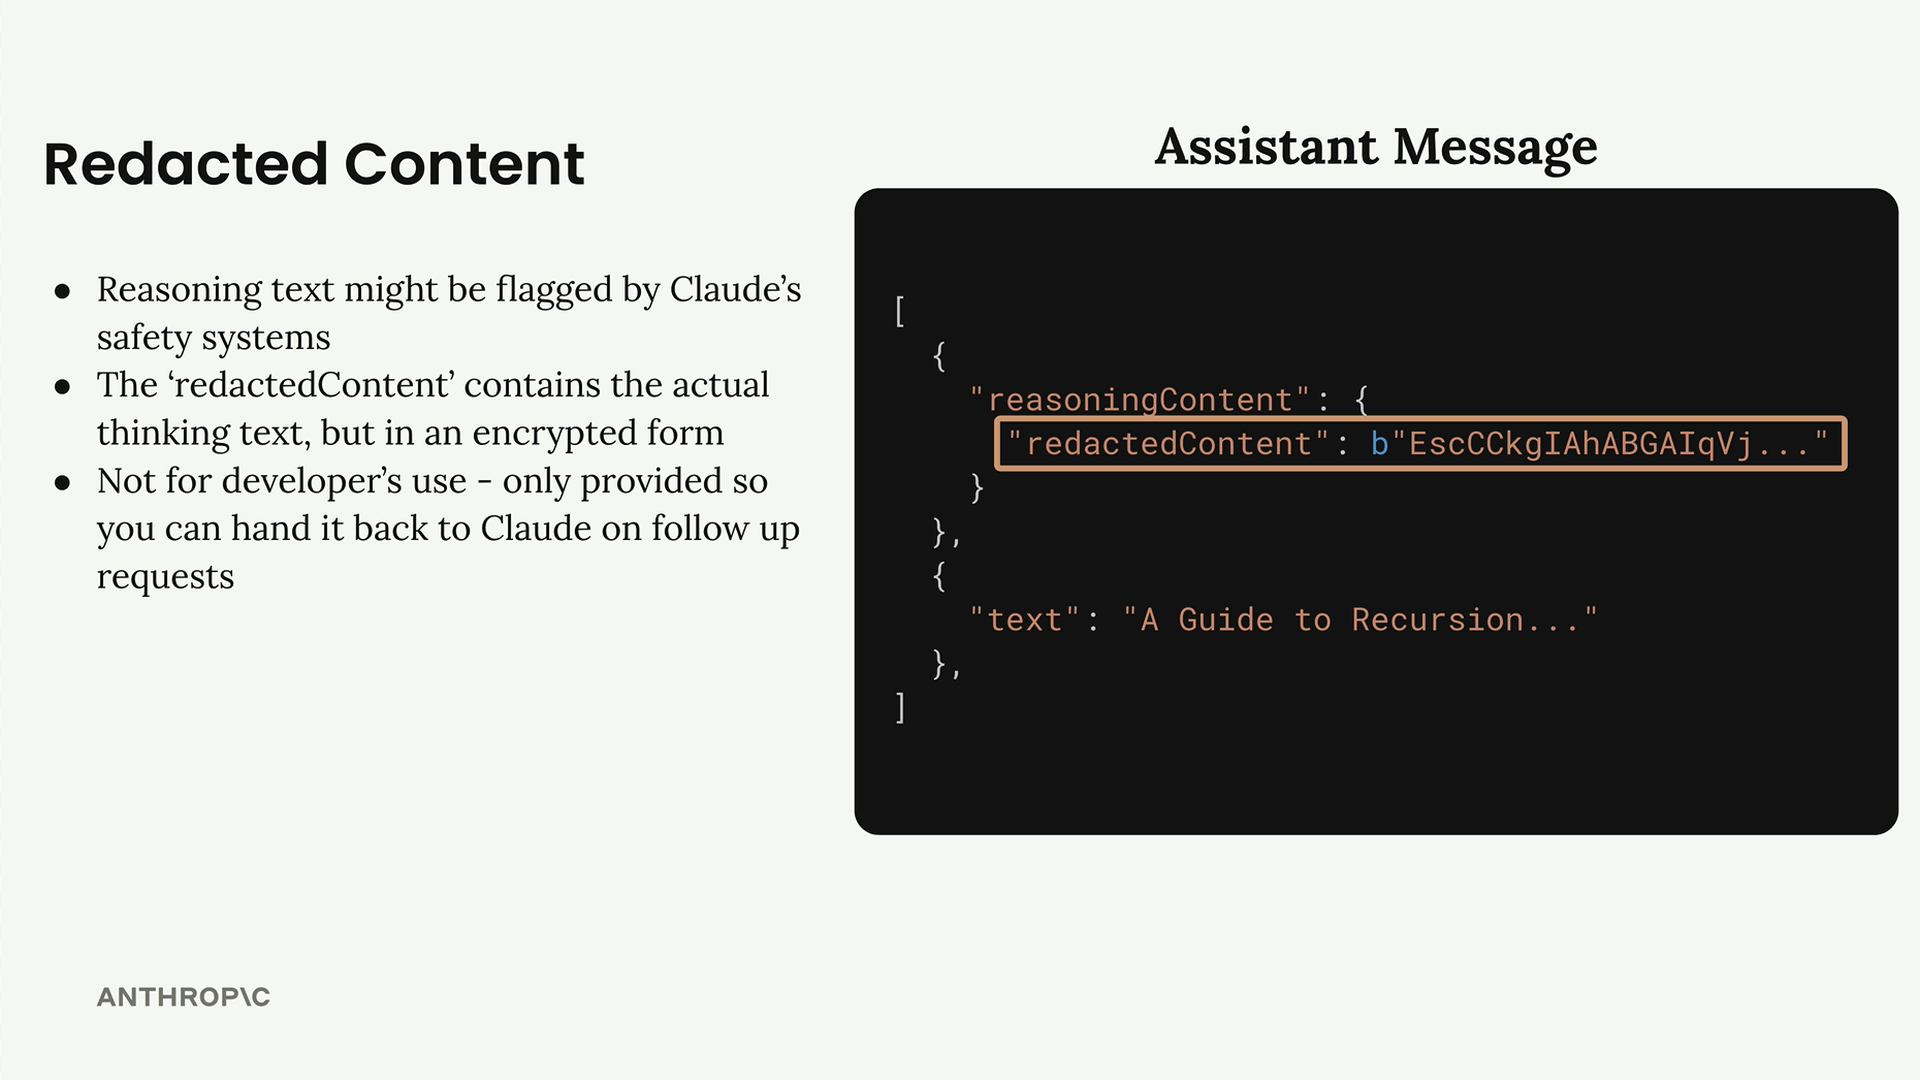
편집된 콘텐츠는 암호화되어 있지만 여전히 기능적입니다 - 향후 대화에서 컨텍스트를 잃지 않고 Claude에게 다시 전달할 수 있습니다. 다만 개발자인 당신이 읽을 수는 없습니다.
구현
Claude Opus 5 및 Claude Sonnet 5와 같은 현재 Claude 모델에서는 사고가 적응형 사고(adaptive thinking)로 실행되며 기본적으로 활성화되어 있습니다: Claude는 관리할 토큰 예산 없이 각 요청에 필요한 추론량을 스스로 결정합니다. 이러한 모델은 요청하지 않으면 추론 텍스트를 생략하므로, 이를 보려면 display를 summarized로 설정하세요:
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}
적응형 사고가 활성화되면, 간단한 질문은 대개 빠르게 돌아오고 더 어려운 질문은 더 많은 추론 시간을 갖게 됩니다. Claude가 얼마나 사고할지 안내하려면, 적응형 사고를 effort 매개변수와 결합할 수 있습니다. effort 수준은 Claude의 사고 할당에 대한 부드러운 가이드 역할을 하며, 그렇지 않으면 직접 관리해야 할 수동 토큰 예산을 대신합니다.
이전에 확장 사고를 사용해 본 적이 있다면, 수동 구성이 단계적으로 폐지되고 있다는 점에 유의하세요: budget_tokens를 사용하는 thinking.type: "enabled"는 Claude Opus 4.6 및 Claude Sonnet 4.6에서 지원 중단되었으며, Claude Opus 4.7 이후 모델(Claude Opus 5 및 Claude Sonnet 5 포함)은 이를 지원하지 않고 이러한 요청을 400 오류로 거부합니다. 대신 effort 매개변수와 함께 thinking.type: "adaptive"를 사용하세요.
적응형 사고를 지원하지 않는 모델
Claude 4.5 모델(Claude Haiku 4.5, Claude Sonnet 4.5, Claude Opus 4.5) 및 이전 모델은 적응형 사고를 지원하지 않습니다. 이러한 모델에서는 수동 토큰 예산으로 확장 사고를 활성화합니다:
additional_model_fields["thinking"] = {
    "type": "enabled",
    "budget_tokens": thinking_budget
}thinking_budget은 Claude가 추론에 사용할 수 있는 토큰 수를 제어합니다. 최소값은 1024 토큰이지만, 복잡한 문제의 경우 더 많이 필요할 수 있습니다. Claude와 관련된 다른 모든 것과 마찬가지로, 평가를 활용하여 사용 사례에 맞는 적절한 예산을 찾으세요.
업데이트된 chat 함수는 다음과 같습니다:
def chat(
    messages,
    system=None,
    temperature=1.0,
    stop_sequences=[],
    tools=None,
    tool_choice="auto",
    text_editor=None,
    thinking=False,
    thinking_budget=1024
):
구현 테스트하기
확장 사고를 처리하는 애플리케이션을 구축할 때는 일반적인 추론 콘텐츠와 편집된 콘텐츠 시나리오를 모두 테스트하고 싶을 것입니다. 실제로 Claude가 편집된 콘텐츠를 반환하도록 강제하는 특별한 테스트 문자열이 있습니다 - 코드가 두 경우를 모두 제대로 처리하는지 확인하는 데 유용합니다.
확장 사고에 대해 가장 중요하게 기억해야 할 점은 이를 사용할지 결정할 때 항상 데이터에 기반해야 한다는 것입니다. 먼저 평가를 실행하고, 프롬프트를 최적화한 다음, 복잡한 작업에서 정확도를 더 높여야 할 필요가 있을 때만 확장 사고를 고려하세요. 이러한 원칙은 간단한 습관에 기반합니다: 더 많은 기능을 사용하기 전에 좋은 결과가 어떤 모습인지 먼저 정의하는 것입니다. 작업에 필요한 정확도를 알고 있다면, 추측하는 대신 확장 사고가 그 비용을 정당화하는지 판단할 수 있습니다.
실습: 직접 적응형 사고 실행해보기
적응형 사고는 그것이 결정을 내리는 과정을 지켜보는 것으로 가장 쉽게 이해할 수 있습니다. chat 함수를 구축해 온 코드에서 이를 활성화하세요:
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}
이제 동일한 구성으로 두 개의 요청을 보내세요. 먼저 이미 답을 알고 있는 간단한 사실 질문을 하세요. 그다음 본인의 업무에서 나온 다단계 분석 문제처럼 진짜로 어려운 질문을 하세요. 적응형 사고를 지원하지 않는 모델로 작업하고 있다면, 위 섹션의 수동 budget_tokens 구성으로 사고를 활성화하고 동일한 두 요청을 실행하세요.
사고가 무엇을 했는지 확인하기
플래그를 설정하는 것만으로는 요청이 수락되었다는 것만 증명됩니다. 다음 확인 사항들은 사고가 실제로 무엇을 했는지 알려줍니다:
- 사고가 작동했는지 확인하세요. 이제 각 응답은 텍스트만 있는 것이 아니라 추론 콘텐츠와 최종 텍스트라는 두 부분을 포함해야 합니다. 한 가지 예외는 앞서 본 편집된 콘텐츠입니다:
redactedContent필드는 사고가 실행되었지만 텍스트가 암호화되었음을 의미합니다. - 추론 콘텐츠를 읽어보세요. 질문을 단순히 다시 말하는 것이 아니라 실제로 추론하고 있는지 확인하세요. 이는 나중에 복잡한 작업을 디버깅할 때 의존하게 될 것과 동일한 투명성입니다.
- 두 요청을 비교하세요. 간단한 질문은 대개 적은 추론으로 빠르게 돌아오고, 어려운 질문은 눈에 띄게 더 많은 추론을 받습니다. 이 차이가 바로 적응형 사고가 당신을 대신해 할당 결정을 내리는 모습입니다.
- 비용을 따져보세요. 모든 사고 토큰에 대해 비용을 지불하므로, 더 어려운 답변이 사고 없이 얻는 답변보다 더 나은지 확인하세요. 이를 판단하는 것은 평가이며, 추론 텍스트가 나타나는 것을 보는 것만으로는 그 역할을 대신할 수 없습니다.
이 레슨에서 유지할 가치가 있는 행동은 다음과 같습니다: 새로운 작업에서 확장 사고를 활성화할 때마다, 몇 가지 대표적인 요청에 대한 추론 콘텐츠를 읽고 해당 설정을 유지할지 결정하기 전에 평가를 다시 실행하세요.