本番環境のEvals:CI、バッチ処理、ドリフト
Evalにはローンチ後もやるべき仕事があります。プルリクエストのたびに、顧客が誤った回答を受け取る前に、 ケースを壊すプロンプトの変更を検知します。また、ライブトラフィックを採点してドリフト、つまり実際の入力 が変化するにつれて生じる精度のゆるやかな低下を検知します。
このビデオのデモは2026年8月に収録されました。Claude Haiku 4.5、Claude Sonnet 5、Claude Opus 5で実行されています。新しいモデルでは結果が異なります。各レッスンのデモは別々のeval実行であるため、そのスコアとコストは他のレッスンのものと一致しません。
ローンチ後もevalは実行され続けます。2つのものが変化し続けるからです。 チームはプロンプトを編集し、その編集が正しかった回答を壊すことがあります。実際の入力も変化し、やがてテストしたものとは似ても似つかないものになります。そのため、evalは出荷前のすべての編集時に実行され、出荷後はライブトラフィックに対して実行されます。
このレッスンでは、架空のエンジニアリングコンサルティング会社Meridianを追います。Meridianのプロンプトは毎月のプロジェクトレポートを読み込み、プロジェクトID、スケジュールステータス、最大のリスクという3つのフィールドを返します。Meridianのevalには50件のケースがあります。各ケースはレポートとそれに対する期待される回答から成り、50件すべてを合わせてフルスイートを構成します。
次の4つのステップにより、ローンチ後もMeridianのevalは機能し続けます。
- プルリクエストのたびにいくつかのケースを実行する。
- 合格するまでプルリクエストがマージされないようにする。
- フルスイートを1つのバッチとして実行する。
- 毎晩、ライブトラフィックのサンプルを採点する。
プルリクエストのたびにいくつかのケースを実行する
CI(継続的インテグレーション、continuous integrationの略)にワークフローを追加し、プルリクエストごとに実行させましょう。 このワークフローはスモークevalを実行します。これはフルスイートのケースのうち、待っている間に終わるくらい少数のケースを使うものです。そのスコアによって、プルリクエストのチェックが合格または不合格になります。Meridianは50件のケースのうちすべての種類のレポートを網羅する10件を選び、Claude Haiku 4.5で約1分かけて実行します。
しきい値とは合格とみなされる最低スコアのことで、Meridianの場合は88%です。つまり10件のうち9件が成功する必要があります。このワークフローは次の順序で4つのタスクを実行します。
- evalスクリプトを実行し、その返り値をJSONとして保存する。
- その結果をしきい値に照らして採点する。
- 結果をプルリクエストにコメントする。
- スコアがしきい値を下回っていればチェックを失敗させる。
Meridianはこれに GitHub Actionsを使っていますが、evalスクリプトを実行できるCIシステムであれば、どれでも同じ4つのタスクを実行できます。ファイル自体は下のボックスにあります。
合格するまでプルリクエストがマージされないようにする
スモークevalを必須チェック(新しいタブで開きます)にするブランチ保護ルールを有効にしましょう。これはプルリクエストがマージされる前に合格していなければならないチェックです。 このルールはワークフローファイルではなくブランチに属するものであり、これがなければ赤いXは単なる警告にすぎません。
Meridianでは、あるエンジニアが「Simplify extraction prompt」というプルリクエストを開き、2つのルールを削除しました。1つは、レポートに最大のリスクが記載されていない場合にClaudeがnullを返すというルールで、もう1つは回答前にリスクの出所となる行をClaudeが引用するというルールでした。
この実行では80%のスコアとなり、88%のしきい値を下回りました。両方の失敗はいずれもリスク欠落ケース、つまりリスクの項目がないレポートであり、本来ならnullが返るはずでしたが、Claudeは何らかのリスクを挙げてしまいました。
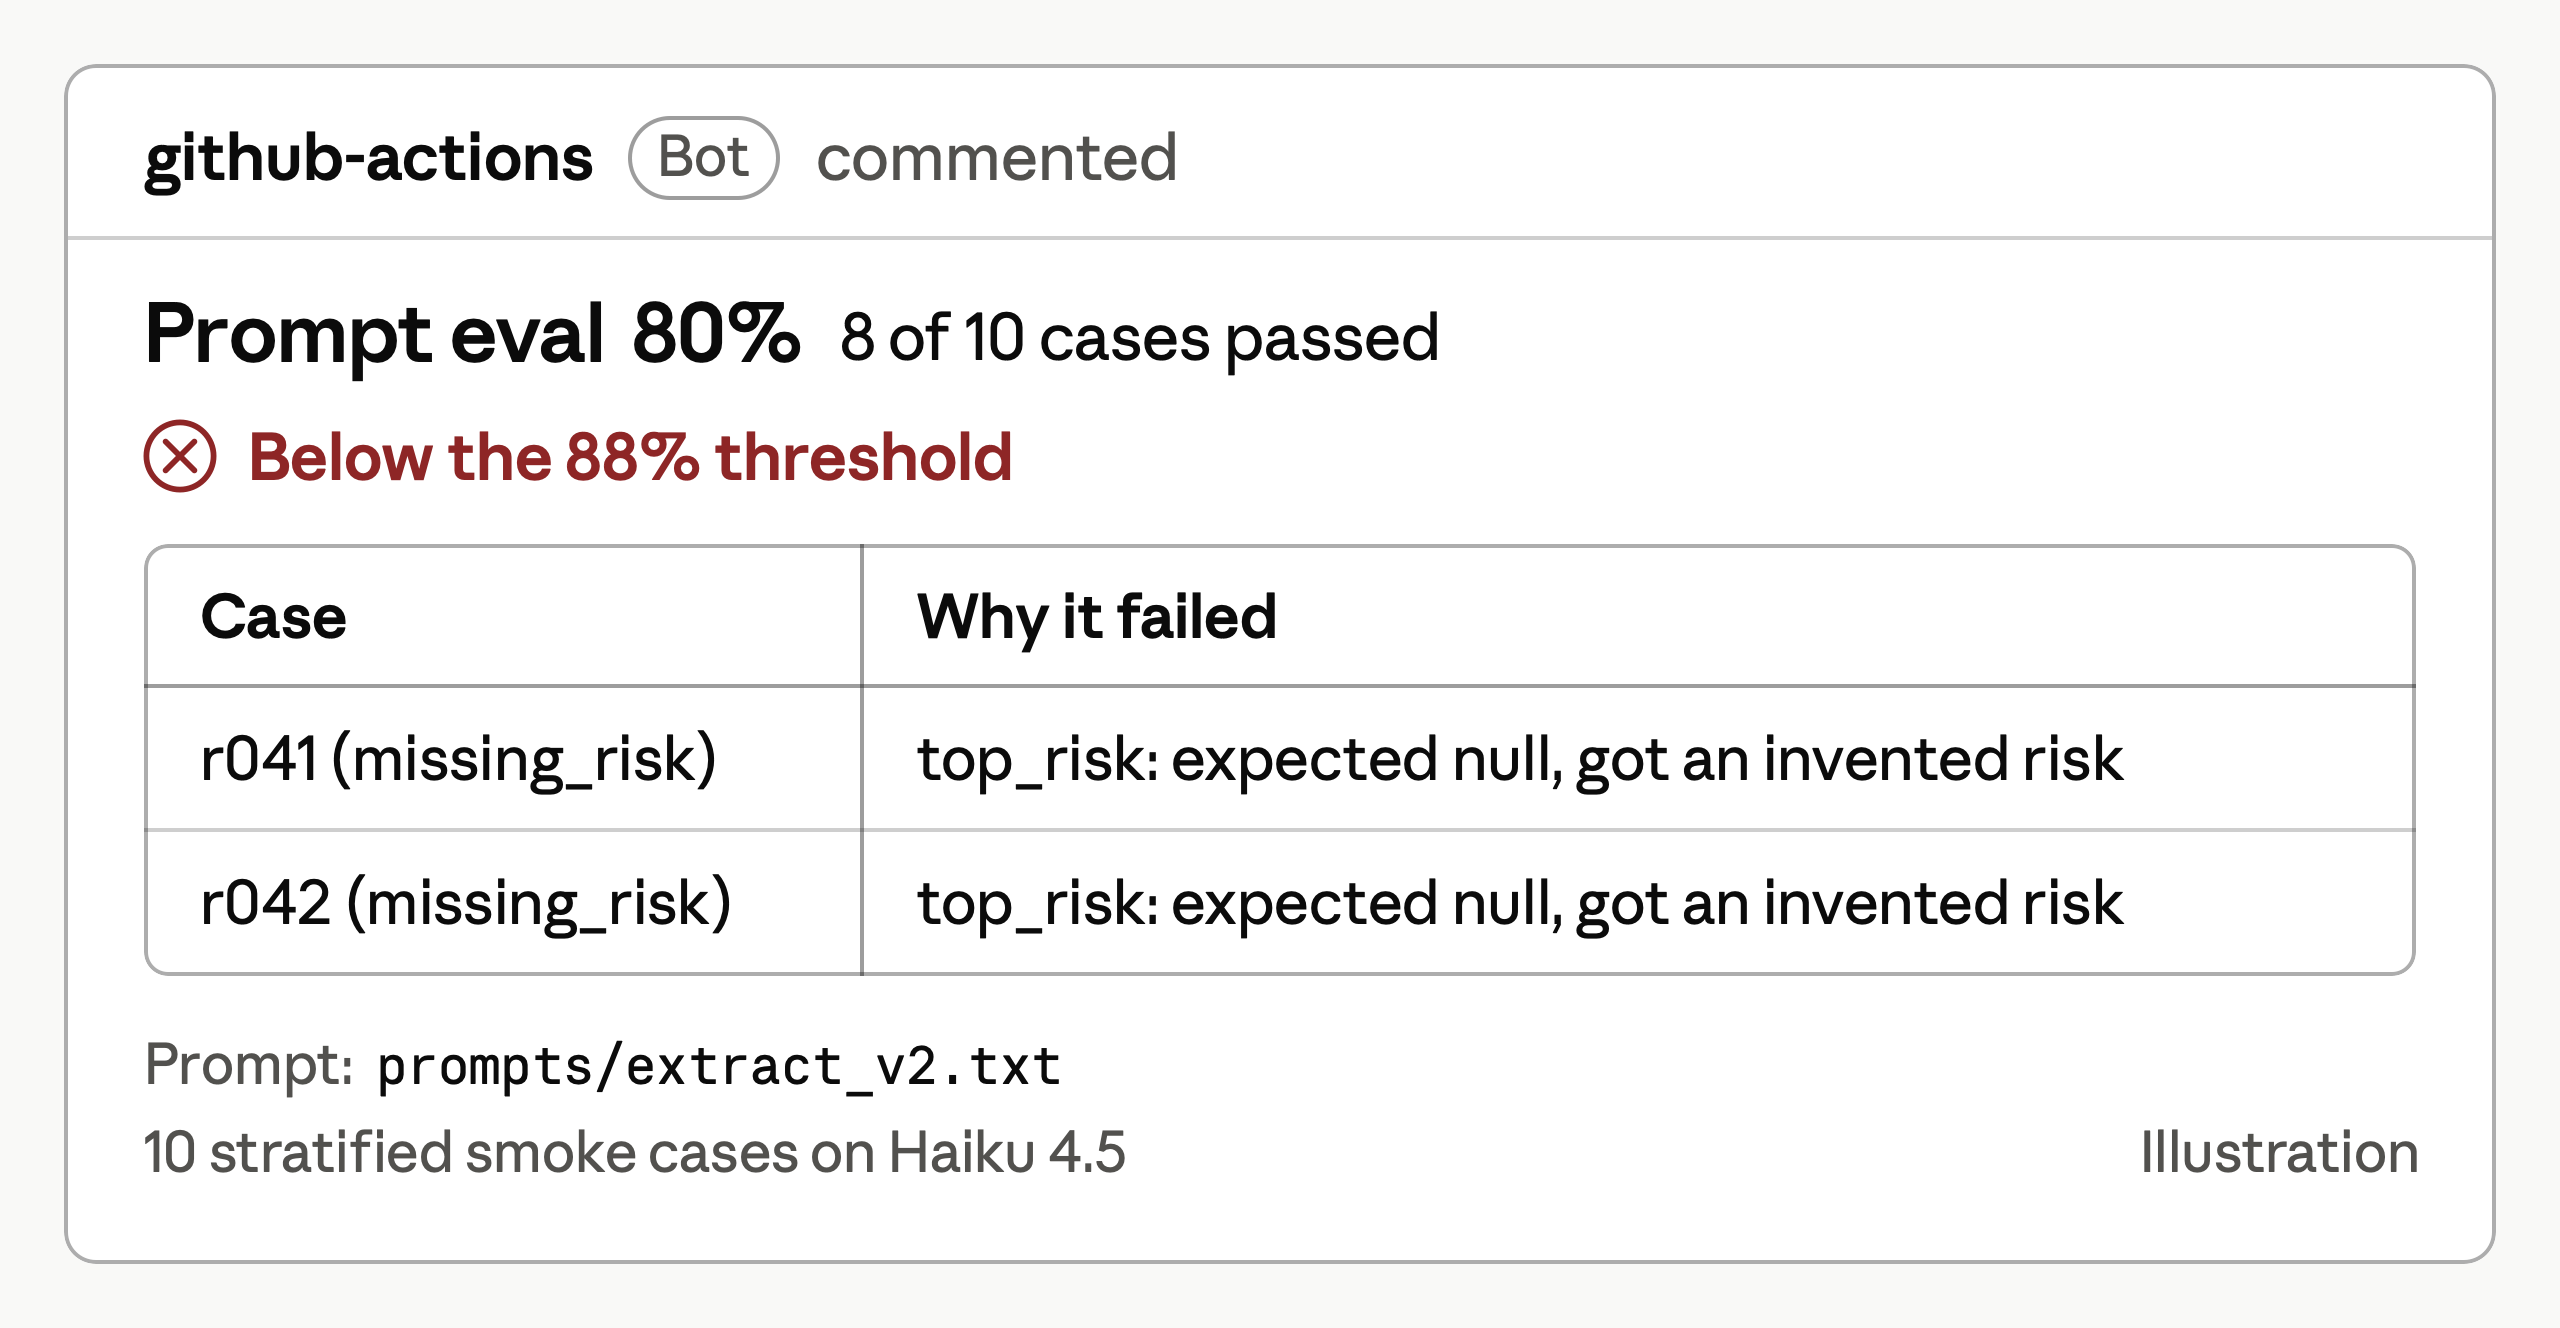
スモークevalは80%のスコアとなり、88%のしきい値に届きませんでした。2件のリスク欠落ケースでClaudeがレポートには一切ないリスクを挙げてしまったためです。
赤いチェックはマージボタンをグレーのままにし、そのコメントはどのケースが壊れたかをエンジニアに示します:r041とr042です。プロンプトが修正されてプッシュされると、チェックはグリーンになりマージを進めることができるため、壊れたプロンプトを顧客が目にすることは一切ありませんでした。
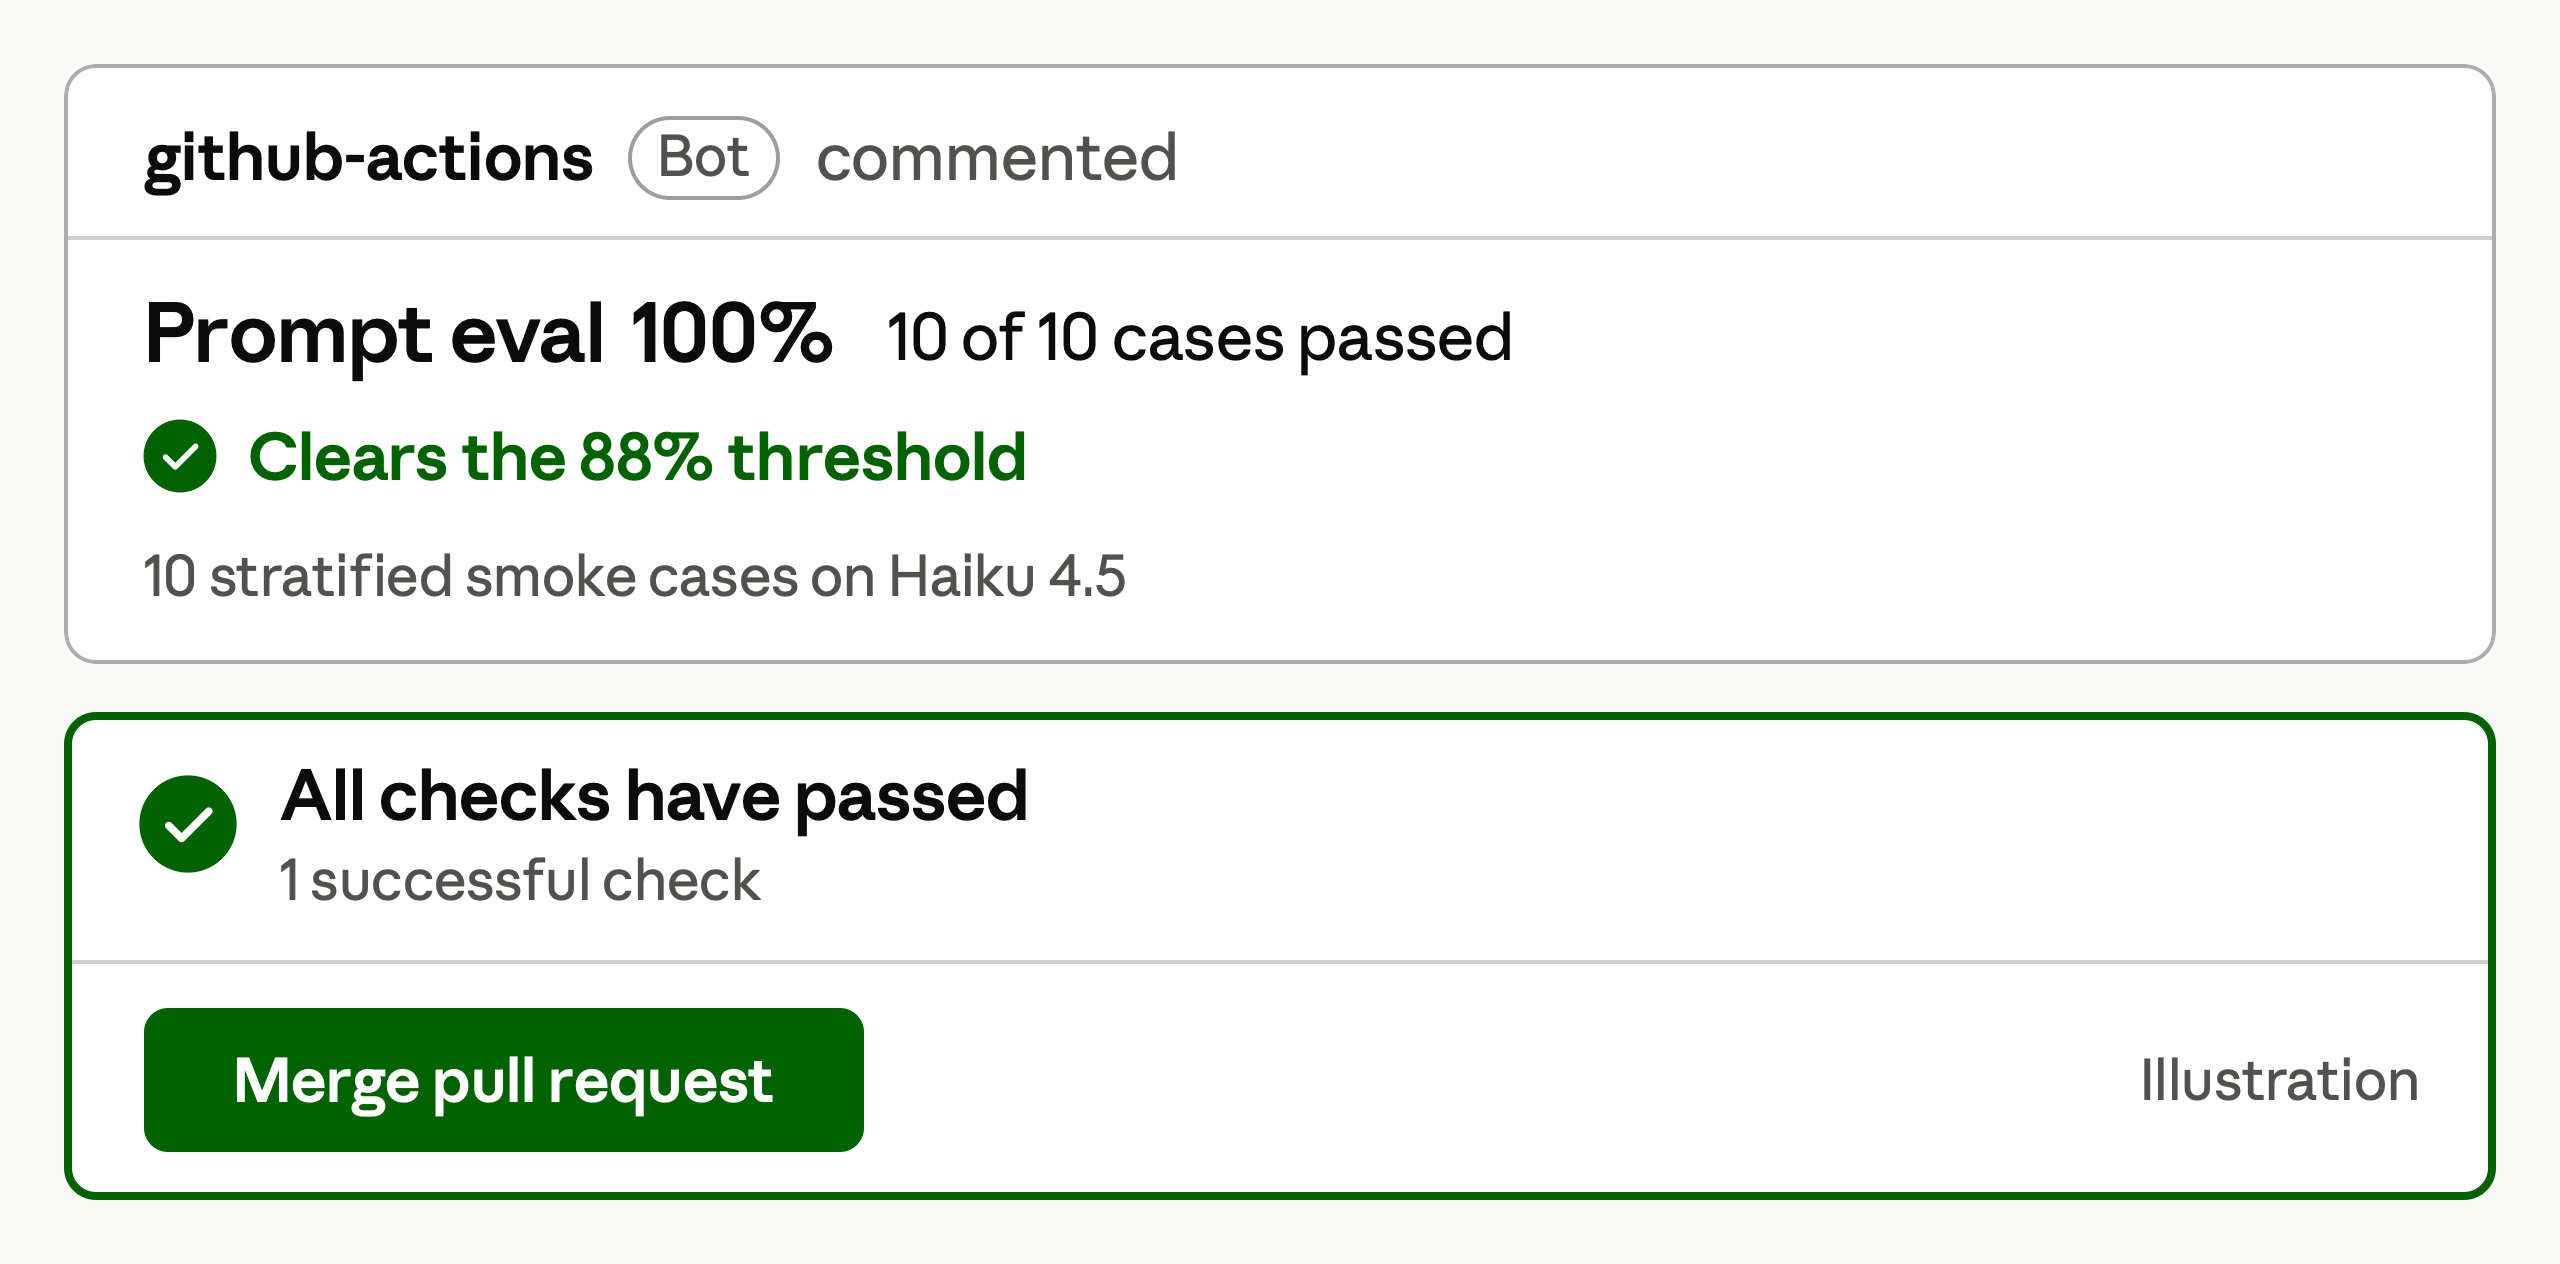
修正後はすべてのケースが100%で合格するため、マージはもはやブロックされません。
フルスイートを1つのバッチとして実行する
プロンプトまたはモデルを変更するたびに(新しいタブで開きます)フルスイートを実行し、Batch API(新しいタブで開きます)経由で送信しましょう。 Meridianのevalは Haiku 4.5、Claude Sonnet 5、Claude Opus 5を比較するため、そのバッチには150件のリクエスト、つまりそれぞれ全50件のケースが含まれます。Batch APIはすべてのリクエストを入力トークンと出力トークンの通常料金の半額(新しいタブで開きます)で実行し、通常は1時間以内に(新しいタブで開きます)結果を後から回収できます。
| モデル | 標準価格 | Batch API価格 |
|---|---|---|
| Haiku 4.5 | $0.0468 | $0.0234 |
| Sonnet 5 | $0.1301 | $0.0650 |
| Opus 5 | $0.3432 | $0.1716 |
2026年8月時点での、各モデルでMeridianの50件のケースを1回実行する場合の標準価格とBatch API価格。最新の価格(新しいタブで開きます)。
誰も待っていないリクエストはバッチ処理し、誰かが待っているリクエストには標準のものを使いましょう(新しいタブで開きます)。マージが待っているスモークevalだけが、client.messages.create(...)のままです。
evalスクリプトには2つの変更が必要です。
各リクエストにcustom_idでラベルを付けましょう。 結果はどんな順序でも届く可能性がある(新しいタブで開きます)ため、このラベルで照合することになり、それはバッチ内で一意でなければなりません。各ケースは3つのモデルに送られるため、r041_claude-haiku-4-5のようにケースIDとモデルを結合します。
batch = client.messages.batches.create(
    requests=[
        {
            "custom_id": f"{case['id']}_{model}",
            "params": {
                "model": model,
                "max_tokens": 1024,
                "messages": [{"role": "user", "content": case["prompt"]}],
            },
        }
        for model in MODELS
        for case in CASES
    ]
)採点の前にrequest_countsを確認しましょう。 これは各結果パターンで終わったリクエストの数を数えるもので、実行が不足した状態で戻ってきたことが分かります。24時間以内に完了しなかったバッチは期限切れになり(新しいタブで開きます)、期限切れのリクエストは料金はかかりませんが回答もありません(新しいタブで開きます)。
batch = client.messages.batches.retrieve(batch.id)
print(batch.request_counts)

answers = {}
for result in client.messages.batches.results(batch.id):
    if result.result.type == "succeeded":
        answers[result.custom_id] = result.result.message
毎晩、ライブトラフィックのサンプルを採点する
毎晩、ライブトラフィック、つまりアプリが実際に処理しているリクエストの小さなサンプルを採点しましょう。 フルスイートは構築時にあったレポートしか知らないため、新しいクライアントがどのケースにもカバーされていない形式でレポートを送信し始めると、回答の質が落ちていてもCIはグリーンのままになります。この緩やかな精度の低下がドリフトです。
方法は次のとおりです。
- サンプリングする。 ライブトラフィックの1〜5%を抽出します。
- LLM判定者(新しいタブで開きます)でサンプルを採点する。 これは、レポート、Claudeの回答、ルーブリックのみを使って、書かれたルールのルーブリックに照らして各回答を採点する2つ目のモデルです。そのため、ライブトラフィックにはない期待される回答を必要としません。とはいえ、時々自分でもいくつかの回答を読みましょう(新しいタブで開きます)。判定者も人によるチェックが必要だからです。
- 本物の低下のときだけアラートを出す。 これは、直近の夜の平均であるトレーリングベースラインを標準偏差2つ分以上下回る、ある夜のスコアのことです。標準偏差2つ分は、通常の夜に起こる変化よりも大きな変化です。
- 判定者が不正解とした各回答をケースにする。 その期待される回答を書き、そのケースをフルスイートに追加します。実際の失敗から得られたケース(新しいタブで開きます)が、スイートを実際の使用状況に近づけ続けるからです。
ライブトラフィックは、フルスイートが見逃しているものを示してくれます。追加する失敗のそれぞれが、その差を縮めます。1〜5%や標準偏差2つ分という数値は、自分のトラフィックに合わせて調整するための出発点として捉えましょう。
要点
- 各プルリクエストでスモークevalを実行させ、そのスコアでチェックを合格または不合格にしましょう。
- そのチェックを必須にし、低いスコアが本当にマージを止めるようにしましょう。
- フルスイートをバッチとして実行しましょう。誰も待っていないため、費用は半額になります。
- 毎晩ライブトラフィックのサンプルを採点し、スコアが通常より大きく下がったときにアラートを出し、すべての失敗をフルスイートの新しいケースに変えましょう。