Le sampling permet à un serveur d'accéder à un modèle de langage comme Claude par l'intermédiaire d'un client MCP connecté. Plutôt que le serveur appelle directement Claude, il demande au client d'effectuer l'appel en son nom. Cela transfère du serveur vers le client la responsabilité et le coût de la génération de texte.
Le problème que résout le sampling
Imaginez que vous disposiez d'un serveur MCP doté d'un outil de recherche qui récupère des informations sur Wikipédia. Une fois toutes ces données rassemblées, vous devez les résumer en un rapport cohérent. Vous avez deux options :
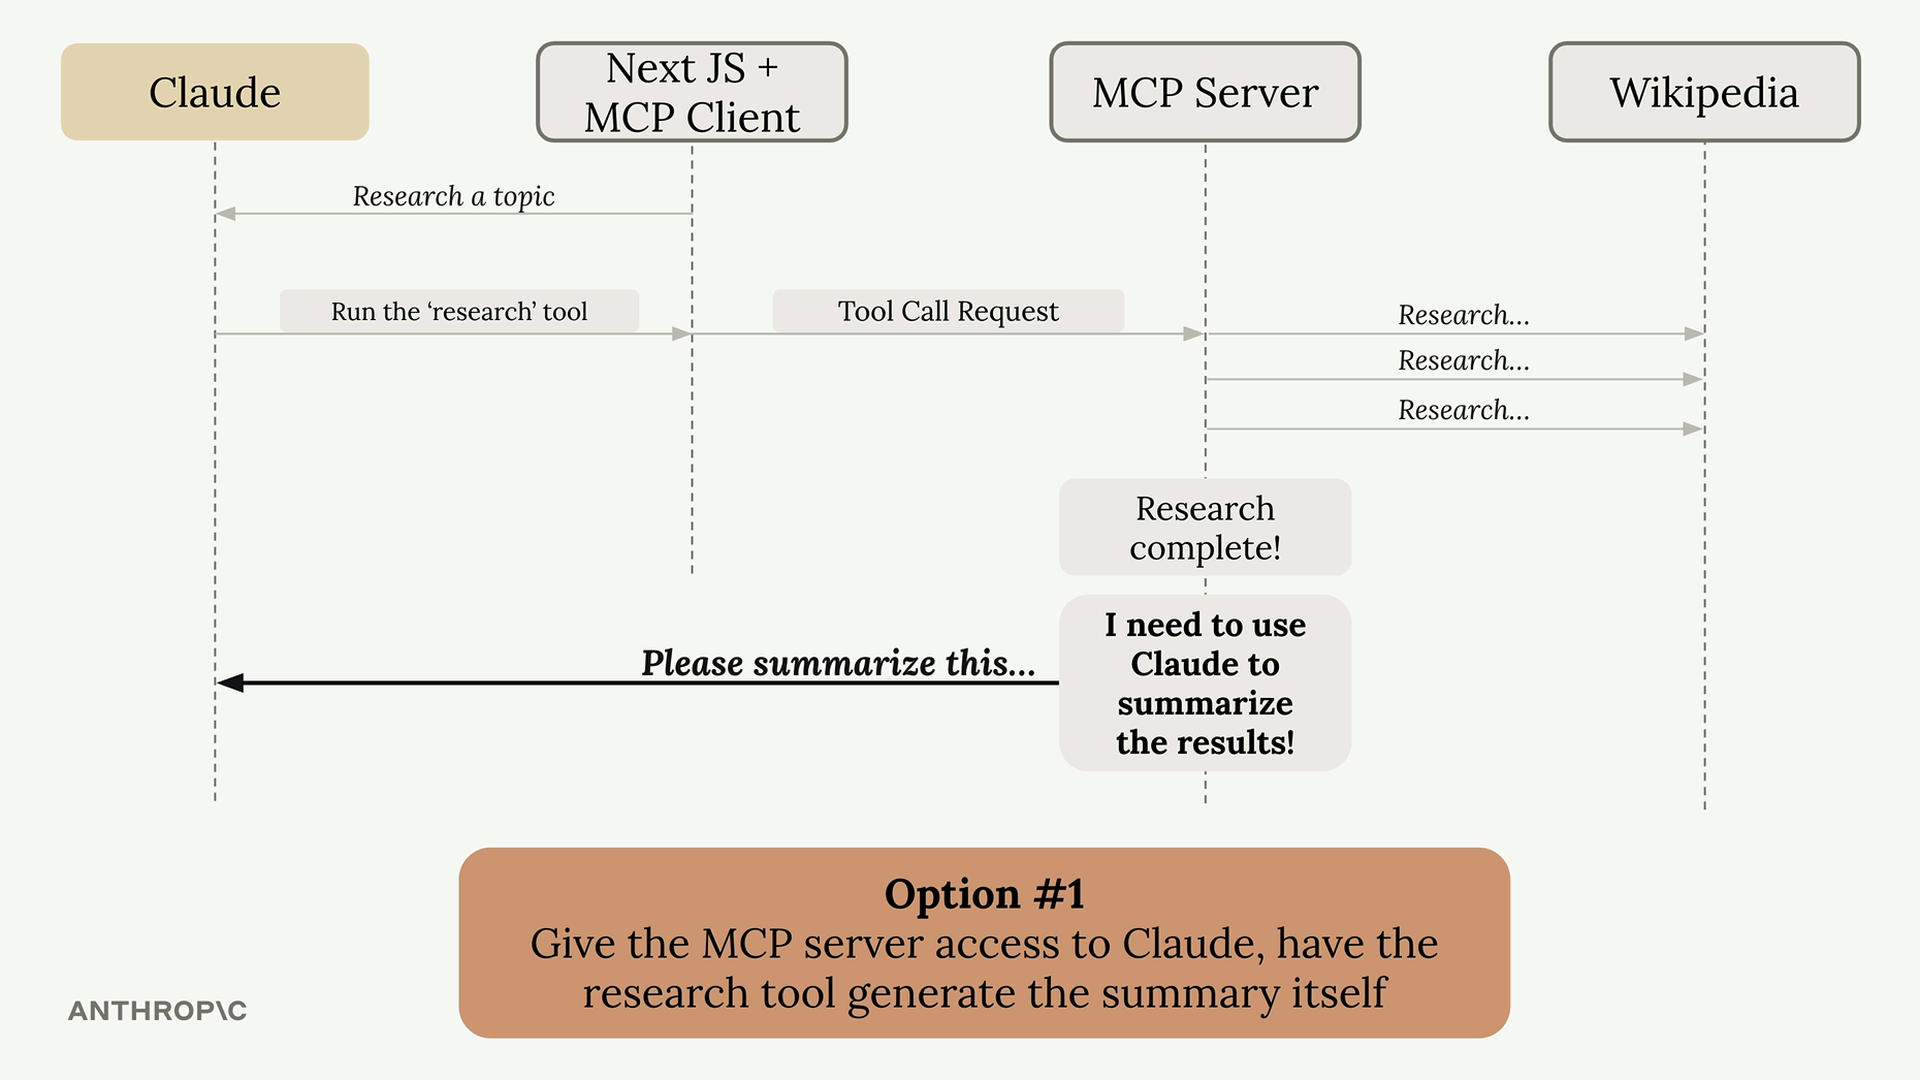
Option 1 : Donner au serveur MCP un accès direct à Claude. Le serveur aurait besoin de sa propre clé API, devrait gérer l'authentification, gérer les coûts et implémenter tout le code d'intégration de Claude. Cela fonctionne, mais ajoute une complexité considérable.
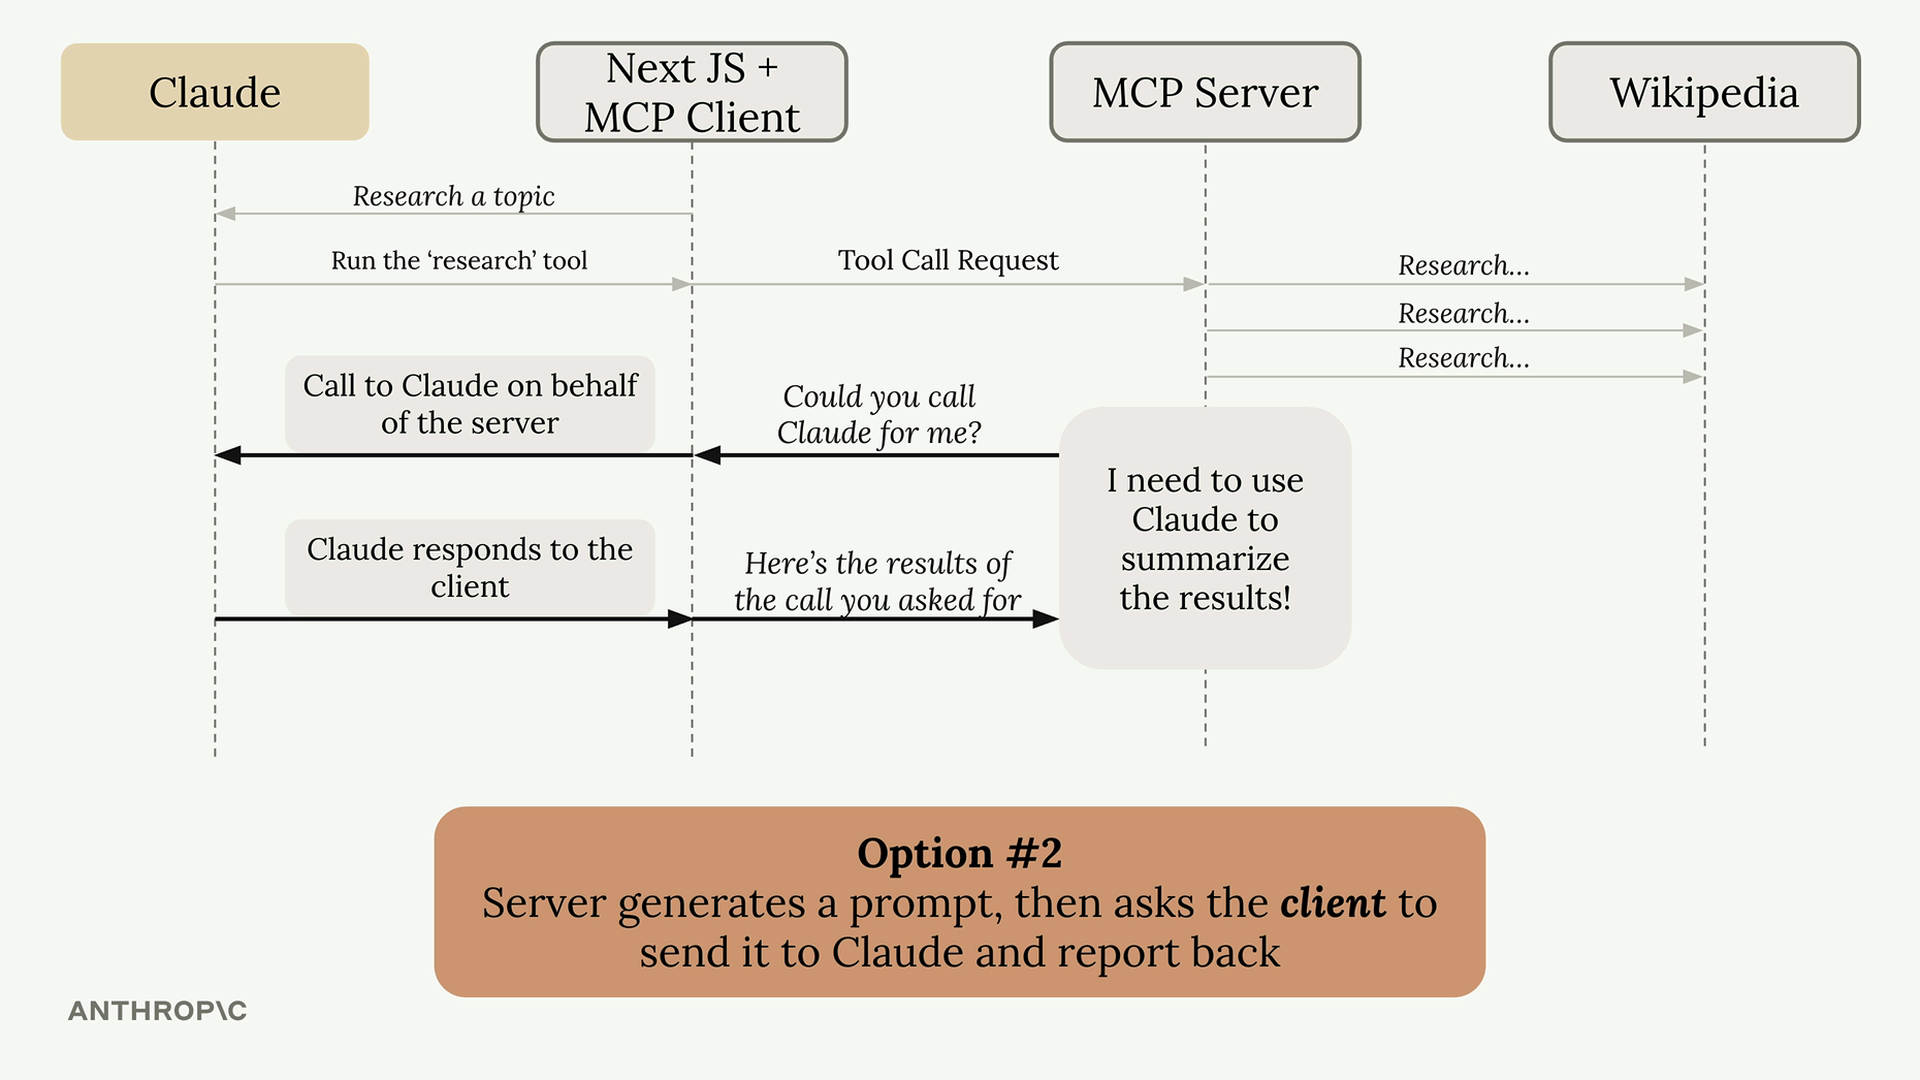
Option 2 : Utiliser le sampling. Le serveur génère une requête et demande au client « Pourriez-vous appeler Claude pour moi ? » Le client, qui dispose déjà d'une connexion à Claude, effectue l'appel et renvoie les résultats.
Comment fonctionne le sampling
Le déroulement est simple :
- Le serveur termine son travail (comme la récupération d'articles Wikipédia)
- Le serveur crée une requête demandant une génération de texte
- Le serveur envoie une demande de sampling au client
- Le client appelle Claude avec la requête fournie
- Le client renvoie le texte généré au serveur
- Le serveur utilise le texte généré dans sa réponse
Avantages du sampling
- Réduit la complexité du serveur : le serveur n'a pas besoin de s'intégrer directement aux modèles de langage
- Transfère la charge des coûts : c'est le client qui paie l'utilisation des jetons, pas le serveur
- Aucune clé API nécessaire : le serveur n'a pas besoin d'identifiants pour Claude
- Parfait pour les serveurs publics : vous ne voulez pas qu'un serveur public accumule des coûts d'IA pour chaque utilisateur
Mise en œuvre
La mise en place du sampling nécessite du code des deux côtés :
Côté serveur
Dans votre fonction d'outil, utilisez la fonction create_message pour demander une génération de texte :
@mcp.tool()
async def summarize(text_to_summarize: str, ctx: Context):
    prompt = f"""
    Please summarize the following text:
    {text_to_summarize}
    """

    result = await ctx.session.create_message(
        messages=[
            SamplingMessage(
                role="user",
                content=TextContent(
                    type="text",
                    text=prompt
                )
            )
        ],
        max_tokens=4000,
        system_prompt="You are a helpful research assistant",
    )

    if result.content.type == "text":
        return result.content.text
    else:
        raise ValueError("Sampling failed")
Côté client
Créez un callback de sampling qui gère les demandes du serveur :
async def sampling_callback(
    context: RequestContext, params: CreateMessageRequestParams
):
    # Appeler Claude à l'aide du SDK Anthropic
    text = await chat(params.messages)

    return CreateMessageResult(
        role="assistant",
        model=model,
        content=TextContent(type="text", text=text),
    )
Passez ensuite ce callback lors de l'initialisation de votre session client :
async with ClientSession(
    read,
    write,
    sampling_callback=sampling_callback
) as session:
    await session.initialize()
Quand utiliser le sampling
Le sampling est particulièrement utile lors de la création de serveurs MCP accessibles publiquement. Vous ne voulez pas que des utilisateurs aléatoires génèrent du texte sans limite à vos frais. En utilisant le sampling, chaque client paie sa propre utilisation de l'IA tout en bénéficiant des fonctionnalités de votre serveur.
Cette technique déplace essentiellement la complexité de l'intégration de l'IA de votre serveur vers le client, qui dispose souvent déjà des connexions et des identifiants nécessaires.