Les évaluations en production : CI, traitement par lots et dérive
Une évaluation a encore du travail à faire après le lancement. À chaque pull request, elle détecte une modification de requête qui casse des cas avant qu'un client ne reçoive une mauvaise réponse. Elle note aussi le trafic en direct pour détecter la dérive, une baisse lente de précision qui survient à mesure que les entrées réelles changent.
La démonstration de cette vidéo a été enregistrée en août 2026. Elle a été exécutée sur Claude Haiku 4.5, Claude Sonnet 5 et Claude Opus 5. Les résultats seront différents sur les modèles plus récents. La démonstration de chaque leçon est une exécution d'évaluation distincte, donc ses scores et ses coûts ne correspondront pas à ceux des autres leçons.
Votre évaluation continue de s'exécuter après le lancement, car deux éléments ne cessent de changer. Votre équipe modifiera la requête, et une modification peut casser des réponses qui étaient correctes. Les entrées réelles changent elles aussi, jusqu'à ne plus ressembler à celles que vous avez testées. L'évaluation s'exécute donc à chaque modification avant sa mise en production, puis sur le trafic en direct ensuite.
Cette leçon suit Meridian, un cabinet de conseil en ingénierie fictif dont la requête lit chaque rapport de projet mensuel et renvoie trois champs : l'identifiant du projet, le statut du calendrier et le principal risque. L'évaluation de Meridian comporte 50 cas. Chaque cas est constitué d'un rapport et de la réponse attendue pour celui-ci, et les 50 cas réunis constituent la suite complète.
Ces quatre étapes permettent à l'évaluation de Meridian de continuer à fonctionner après le lancement :
- Exécuter quelques cas à chaque pull request.
- Empêcher une pull request de fusionner tant qu'elle n'a pas réussi.
- Exécuter la suite complète en un seul lot.
- Noter chaque nuit un échantillon du trafic en direct.
Exécuter quelques cas à chaque pull request
Ajoutez un workflow à la CI, abréviation d'intégration continue, et faites-le s'exécuter à chaque pull request. Le workflow exécute une évaluation de fumée, qui prend suffisamment peu de cas de la suite complète pour se terminer pendant que vous attendez. Son score fait réussir ou échouer une vérification sur la pull request. Meridian sélectionne 10 de ses 50 cas pour couvrir chaque type de rapport, et les exécute sur Claude Haiku 4.5 en environ une minute.
Le seuil est le score de réussite minimal, et celui de Meridian est de 88 %, donc neuf des dix cas doivent réussir. Le workflow effectue quatre tâches, dans cet ordre :
- Exécuter le script d'évaluation et enregistrer ce qu'il renvoie au format JSON.
- Noter ces résultats par rapport au seuil.
- Commenter la pull request avec les résultats.
- Faire échouer la vérification si le score est inférieur au seuil.
Meridian utilise GitHub Actions pour cela, mais tout système de CI capable d'exécuter votre script d'évaluation peut effectuer les mêmes quatre tâches. Le fichier lui-même se trouve dans l'encadré ci-dessous.
Empêcher une pull request de fusionner tant qu'elle n'a pas réussi
Activez une règle de protection de branche qui fait de l'évaluation de fumée une vérification obligatoire(s’ouvre dans un nouvel onglet), c'est-à-dire une vérification qui doit réussir avant qu'une pull request puisse être fusionnée. La règle appartient à la branche, et non au fichier de workflow, et sans elle, une croix rouge n'est qu'un avertissement.
Chez Meridian, un ingénieur ouvre une pull request intitulée « Simplifier la requête d'extraction » qui supprime deux règles. L'une indiquait à Claude de renvoyer null lorsqu'un rapport ne mentionne aucun risque principal, et l'autre demandait à Claude de citer la ligne dont provient le risque avant de répondre.
L'exécution obtient un score de 80 %, en dessous du seuil de 88 %. Les deux échecs sont des cas sans risque, des rapports qui n'ont pas de section risque, et chacun aurait donc dû renvoyer null, mais Claude a tout de même nommé un risque.
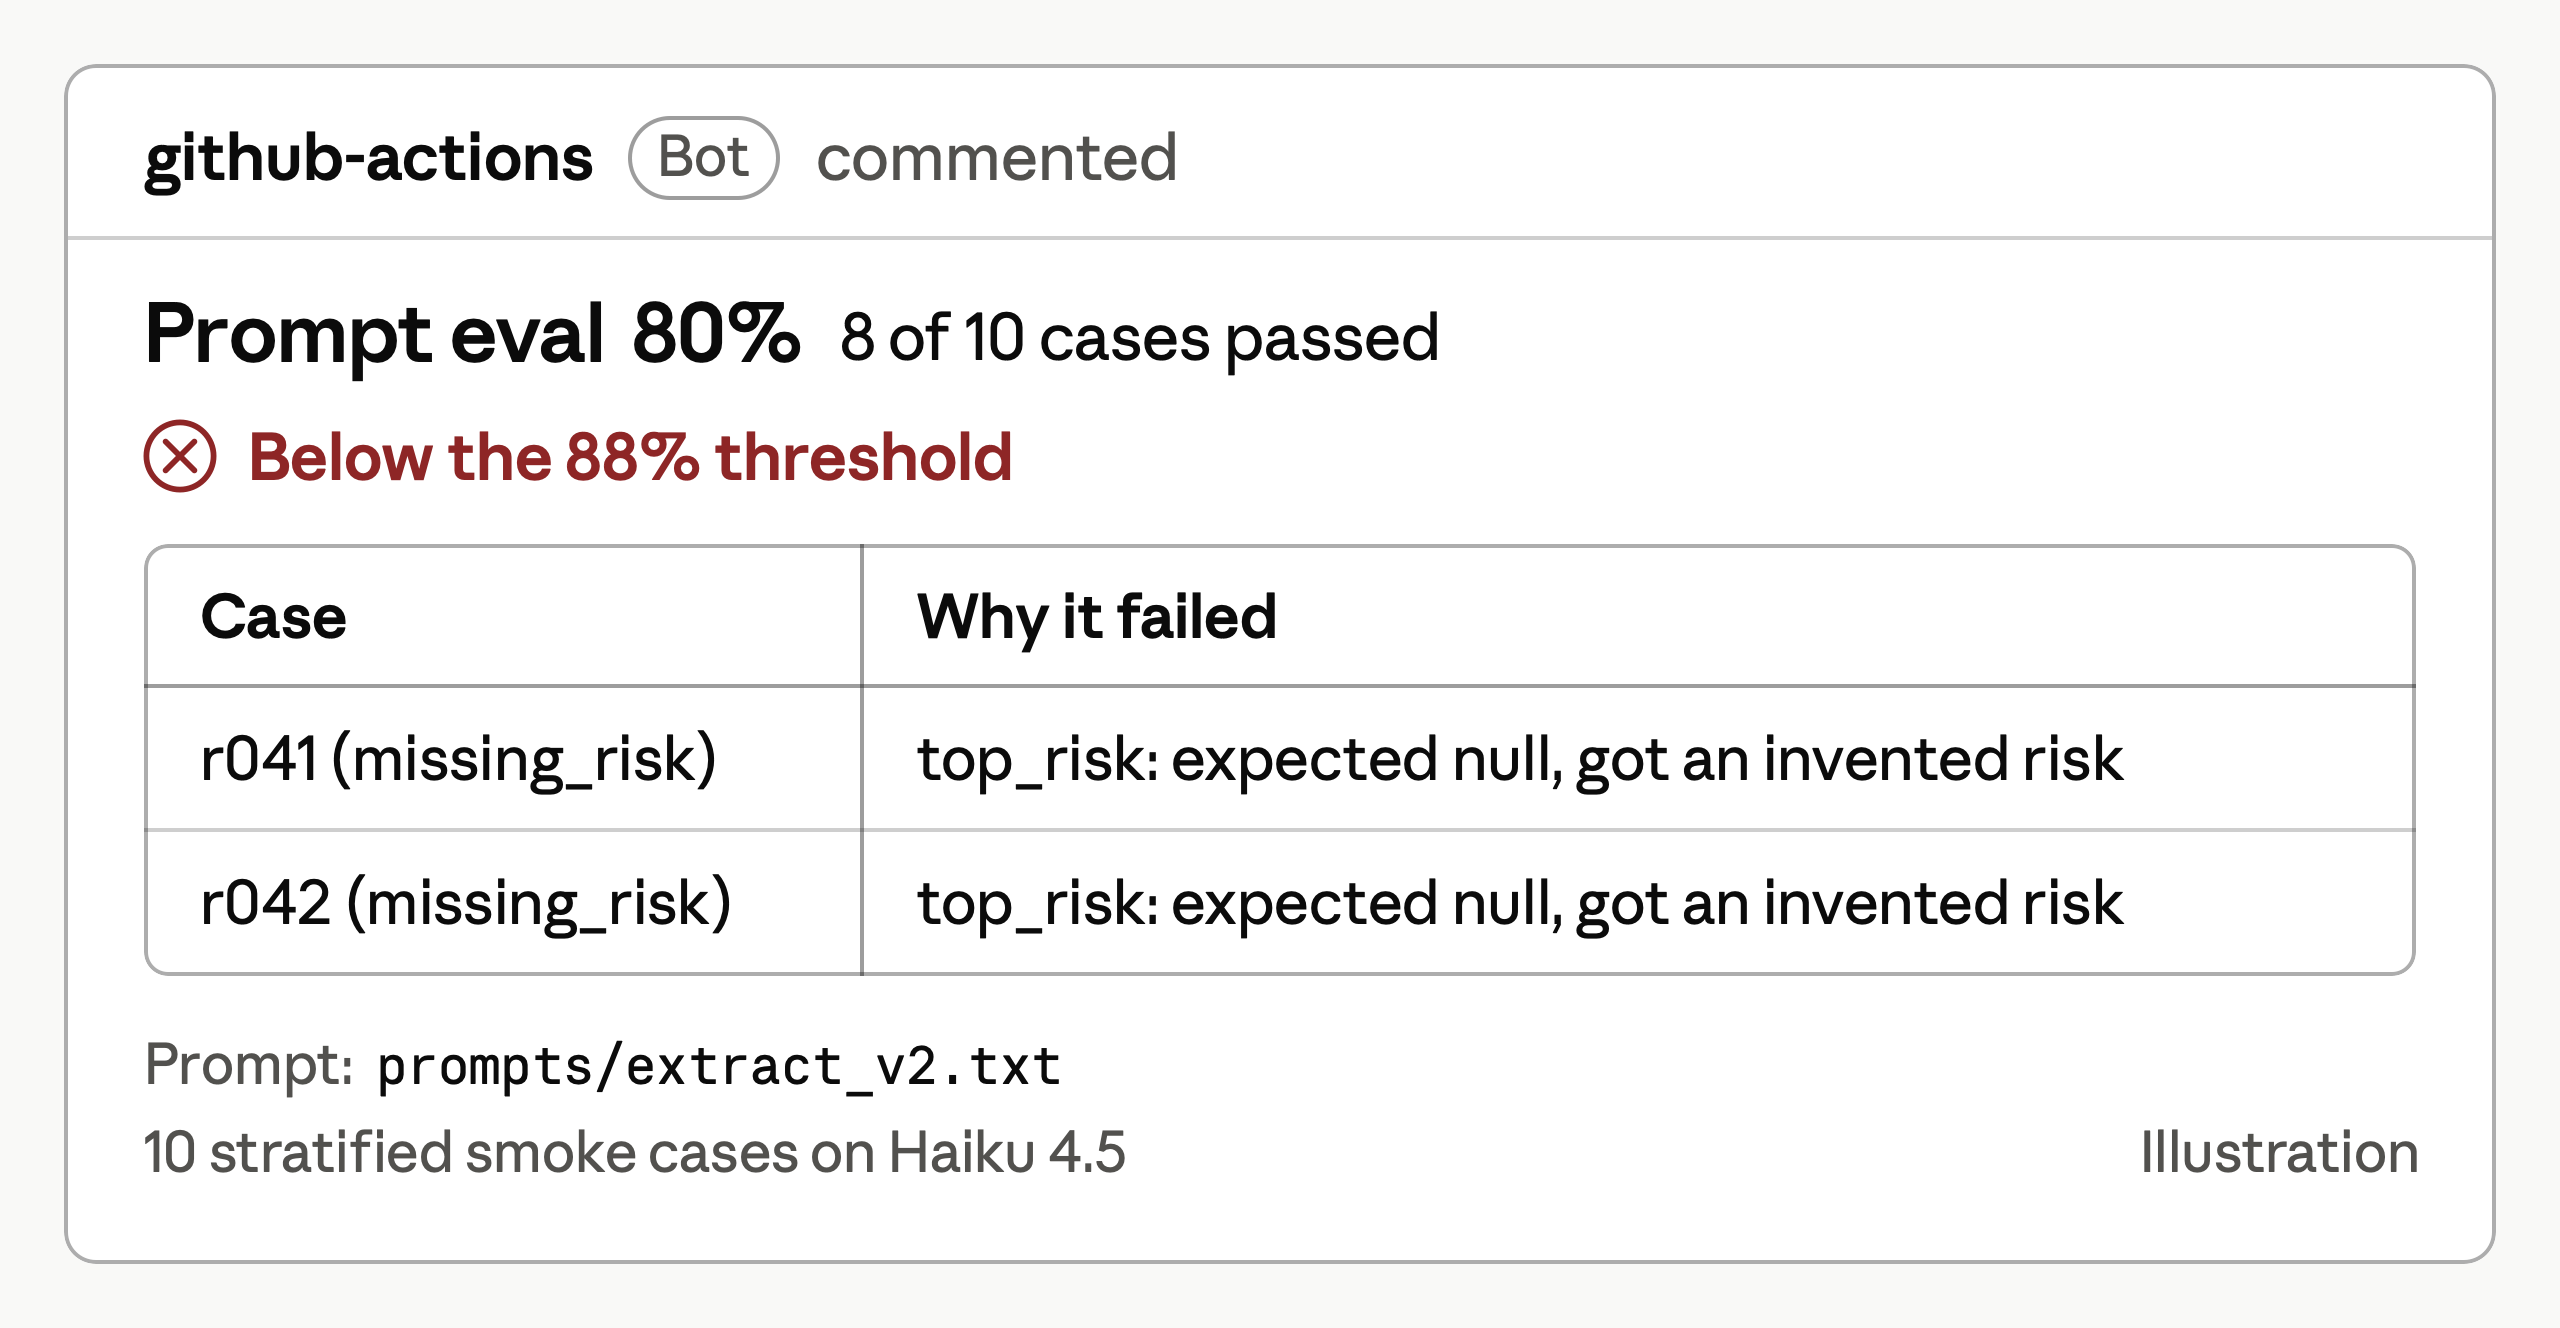
L'évaluation de fumée obtient un score de 80 % et n'atteint pas le seuil de 88 %, car dans deux cas sans risque, Claude a nommé un risque que le rapport ne mentionne jamais.
La vérification rouge maintient le bouton de fusion grisé, et son commentaire indique à l'ingénieur quels cas ont échoué : r041 et r042. Une fois la requête corrigée et envoyée, la vérification passe au vert et la fusion peut avoir lieu, si bien qu'aucun client n'a jamais vu la requête défectueuse.
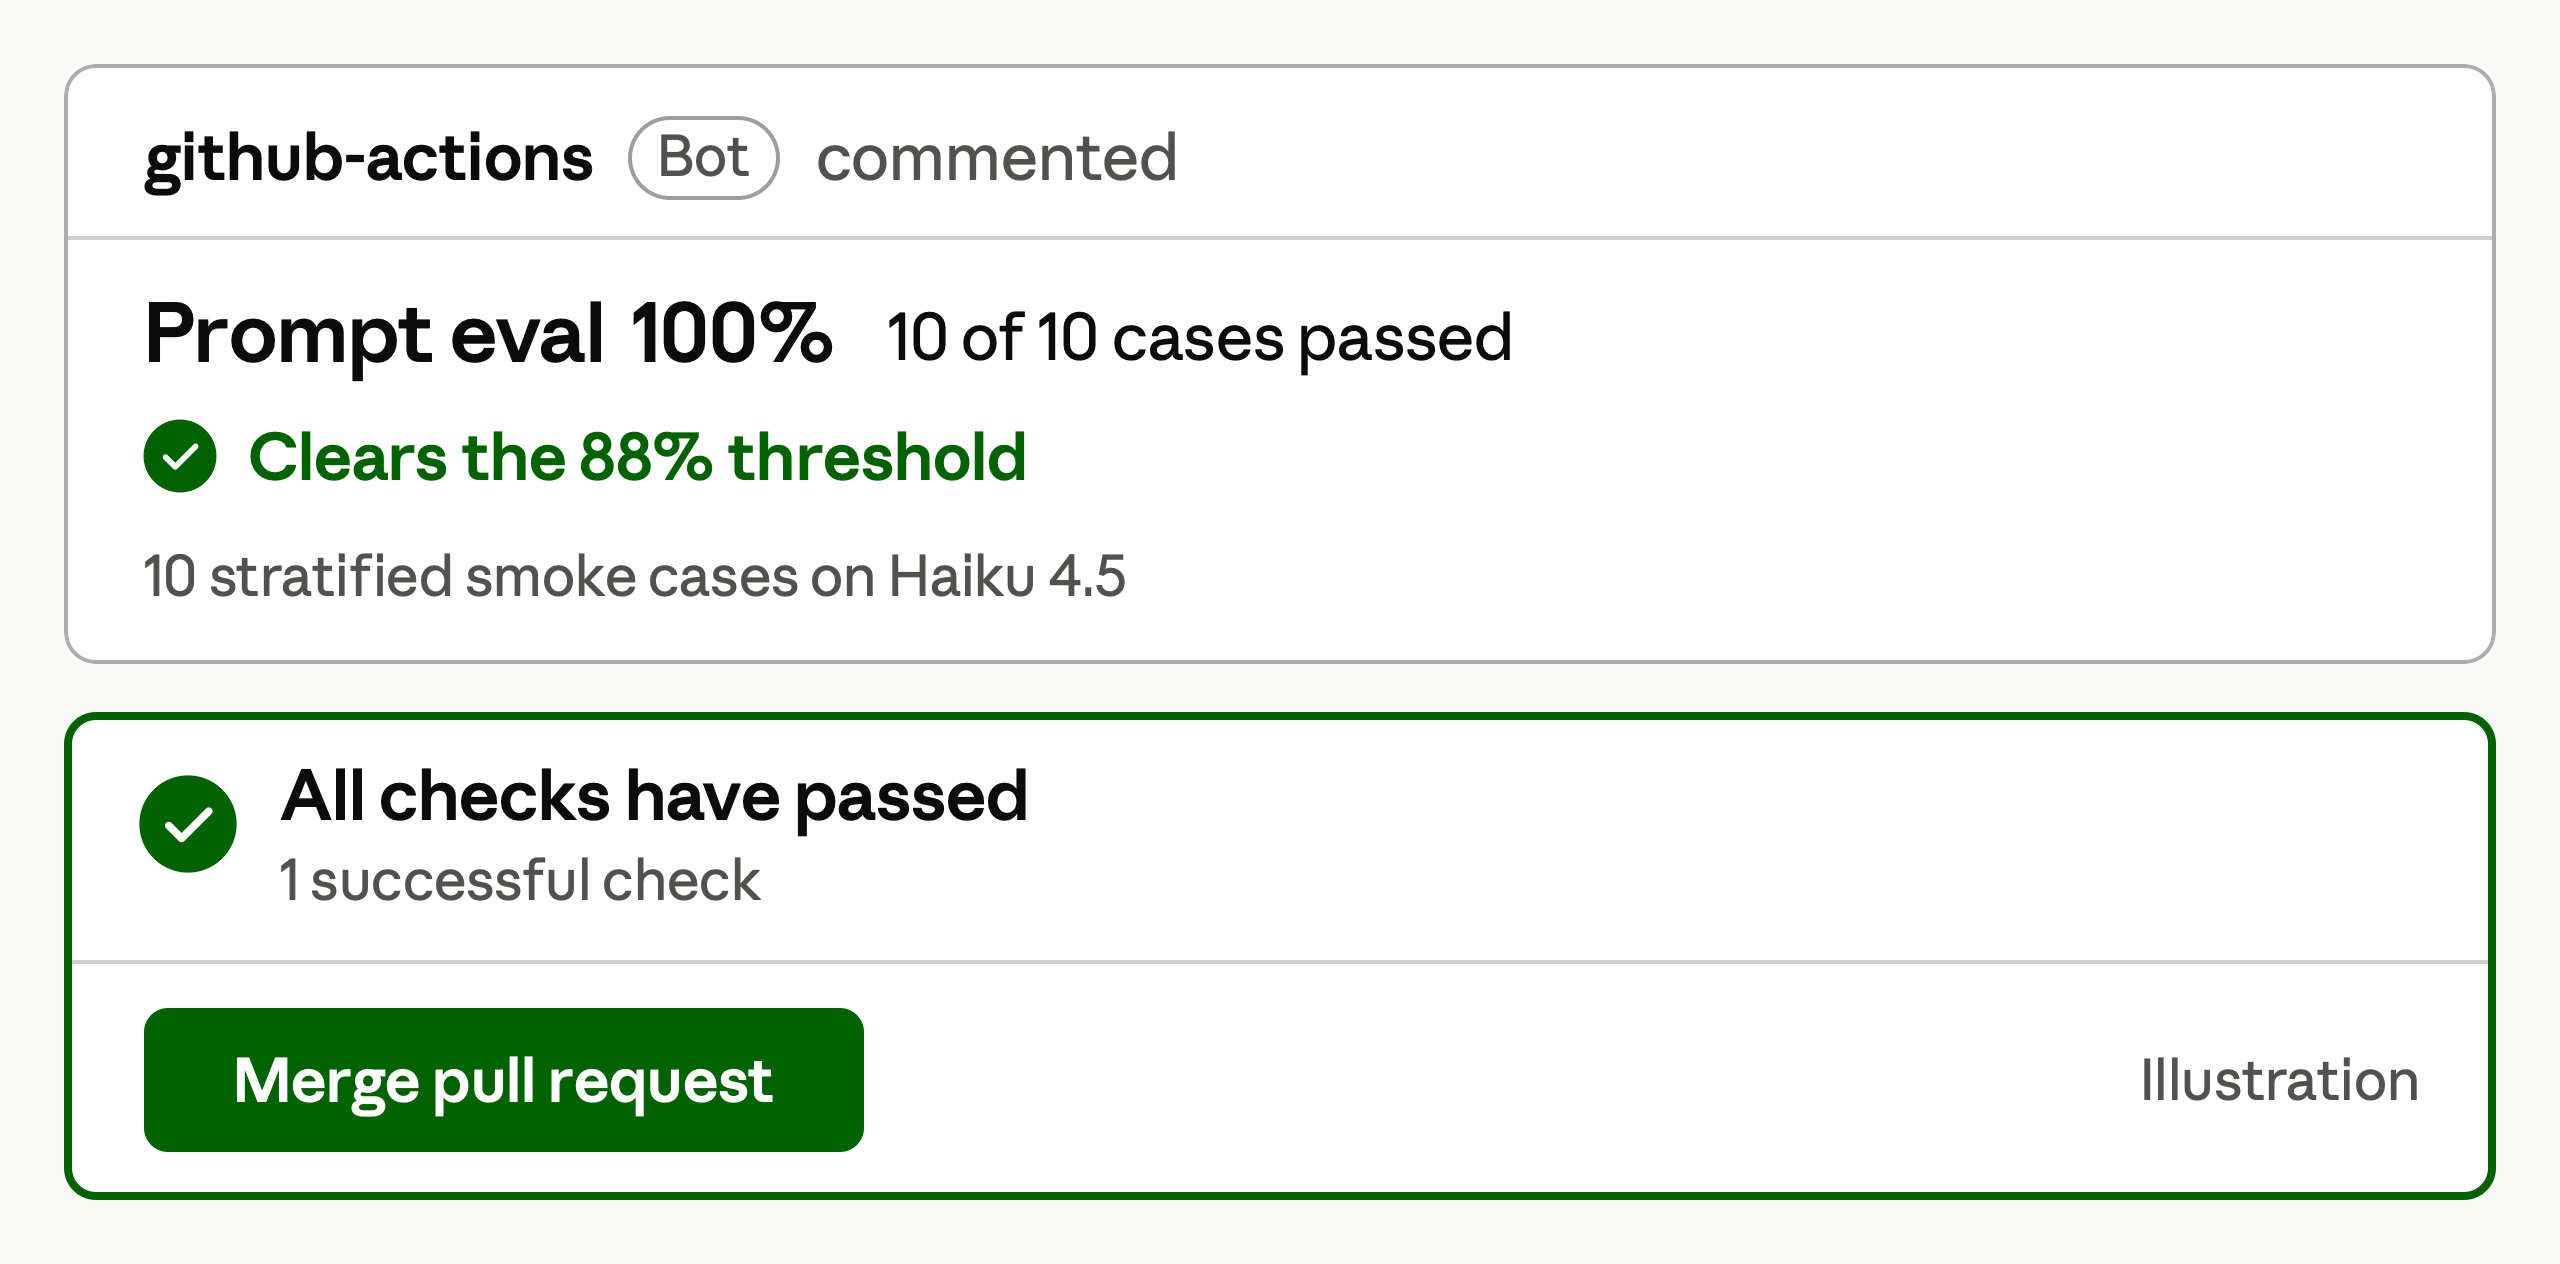
Après la correction, tous les cas réussissent à 100 %, donc la fusion n'est plus bloquée.
Exécuter la suite complète en un seul lot
Exécutez la suite complète chaque fois que vous modifiez la requête ou le modèle(s’ouvre dans un nouvel onglet), et envoyez-la via la Batch API(s’ouvre dans un nouvel onglet). L'évaluation de Meridian compare Haiku 4.5, Claude Sonnet 5 et Claude Opus 5, donc son lot contient 150 requêtes, soit les 50 cas pour chacun. La Batch API les exécute tous pour la moitié du prix habituel des jetons d'entrée et de sortie(s’ouvre dans un nouvel onglet), et vous récupérez les réponses plus tard, généralement dans l'heure(s’ouvre dans un nouvel onglet).
| Modèle | Prix standard | Prix Batch API |
|---|---|---|
| Haiku 4.5 | 0,0468 $ | 0,0234 $ |
| Sonnet 5 | 0,1301 $ | 0,0650 $ |
| Opus 5 | 0,3432 $ | 0,1716 $ |
Prix standard et Batch API pour un passage à travers les 50 cas de Meridian sur chaque modèle, en date d'août 2026. Prix actuels(s’ouvre dans un nouvel onglet).
Traitez par lots les requêtes que personne n'attend, et utilisez des requêtes standard là où quelqu'un attend(s’ouvre dans un nouvel onglet). Seule l'évaluation de fumée, dont une fusion dépend, reste sur client.messages.create(...).
Le script d'évaluation nécessite deux modifications.
Étiquetez chaque requête avec un custom_id. Les résultats peuvent arriver dans n'importe quel ordre(s’ouvre dans un nouvel onglet), vous les associez donc grâce à cette étiquette, qui doit être unique au sein du lot. Chaque cas est envoyé à trois modèles, donc associez l'identifiant du cas au modèle, comme dans r041_claude-haiku-4-5.
batch = client.messages.batches.create(
    requests=[
        {
            "custom_id": f"{case['id']}_{model}",
            "params": {
                "model": model,
                "max_tokens": 1024,
                "messages": [{"role": "user", "content": case["prompt"]}],
            },
        }
        for model in MODELS
        for case in CASES
    ]
)
Lisez request_counts avant de noter. Il compte le nombre de requêtes ayant terminé selon chaque issue, ce qui indique quand une exécution s'est arrêtée en cours de route. Un lot non terminé dans les 24 heures expire(s’ouvre dans un nouvel onglet), et une requête expirée ne coûte rien mais n'a pas de réponse(s’ouvre dans un nouvel onglet).
batch = client.messages.batches.retrieve(batch.id)
print(batch.request_counts)

answers = {}
for result in client.messages.batches.results(batch.id):
    if result.result.type == "succeeded":
        answers[result.custom_id] = result.result.message
Noter chaque nuit un échantillon du trafic en direct
Notez chaque nuit un petit échantillon du trafic en direct, les requêtes réelles traitées par votre application. La suite complète ne connaît que les rapports que vous aviez au moment de sa création, donc si un nouveau client commence à envoyer des rapports dans un format qu'aucun de vos cas ne couvre, votre CI reste au vert alors que les réponses se dégradent. Cette perte lente de précision est la dérive.
Voici comment procéder :
- Échantillonnez. Sélectionnez entre 1 et 5 % du trafic en direct.
- Notez l'échantillon avec un LLM juge(s’ouvre dans un nouvel onglet). Il s'agit d'un second modèle qui note chaque réponse selon une grille de règles écrites, en utilisant uniquement le rapport, la réponse de Claude et la grille, il n'a donc pas besoin de réponses attendues, qui manquent au trafic en direct. Néanmoins, lisez vous-même quelques réponses de temps en temps(s’ouvre dans un nouvel onglet), car un juge doit lui aussi être vérifié par une personne.
- N'alertez qu'en cas de baisse réelle. Il s'agit d'un score nocturne inférieur de plus de deux écarts-types à la référence glissante, la moyenne des nuits récentes. Deux écarts-types représentent un changement plus important que celui qu'apporte une nuit normale.
- Transformez en cas chaque réponse que le juge marque comme incorrecte. Rédigez sa réponse attendue, puis ajoutez le cas à la suite complète, car les cas issus d'échecs réels(s’ouvre dans un nouvel onglet) maintiennent la suite proche de l'usage réel.
Le trafic en direct vous montre ce que la suite complète manque, et chaque échec que vous ajoutez réduit cet écart. Considérez les 1 à 5 % et les deux écarts-types comme des points de départ à ajuster pour votre propre trafic.
L'essentiel à retenir
- Faites exécuter une évaluation de fumée à chaque pull request, et laissez son score faire réussir ou échouer la vérification.
- Rendez cette vérification obligatoire, afin qu'un score faible bloque réellement la fusion.
- Exécutez la suite complète sous forme de lot, ce qui coûte deux fois moins cher, car personne ne l'attend.
- Notez chaque nuit un échantillon du trafic en direct, déclenchez une alerte lorsque le score baisse plus que d'habitude, et transformez chaque échec en nouveau cas dans la suite complète.