Sampling permite que un servidor acceda a un modelo de lenguaje como Claude a través de un cliente MCP conectado. En lugar de que el servidor llame directamente a Claude, le pide al cliente que haga la llamada en su nombre. Esto traslada la responsabilidad y el costo de la generación de texto del servidor al cliente.
El problema que resuelve Sampling
Imagina que tienes un servidor MCP con una herramienta de investigación que obtiene información de Wikipedia. Después de reunir todos esos datos, necesitas resumirlos en un informe coherente. Tienes dos opciones:
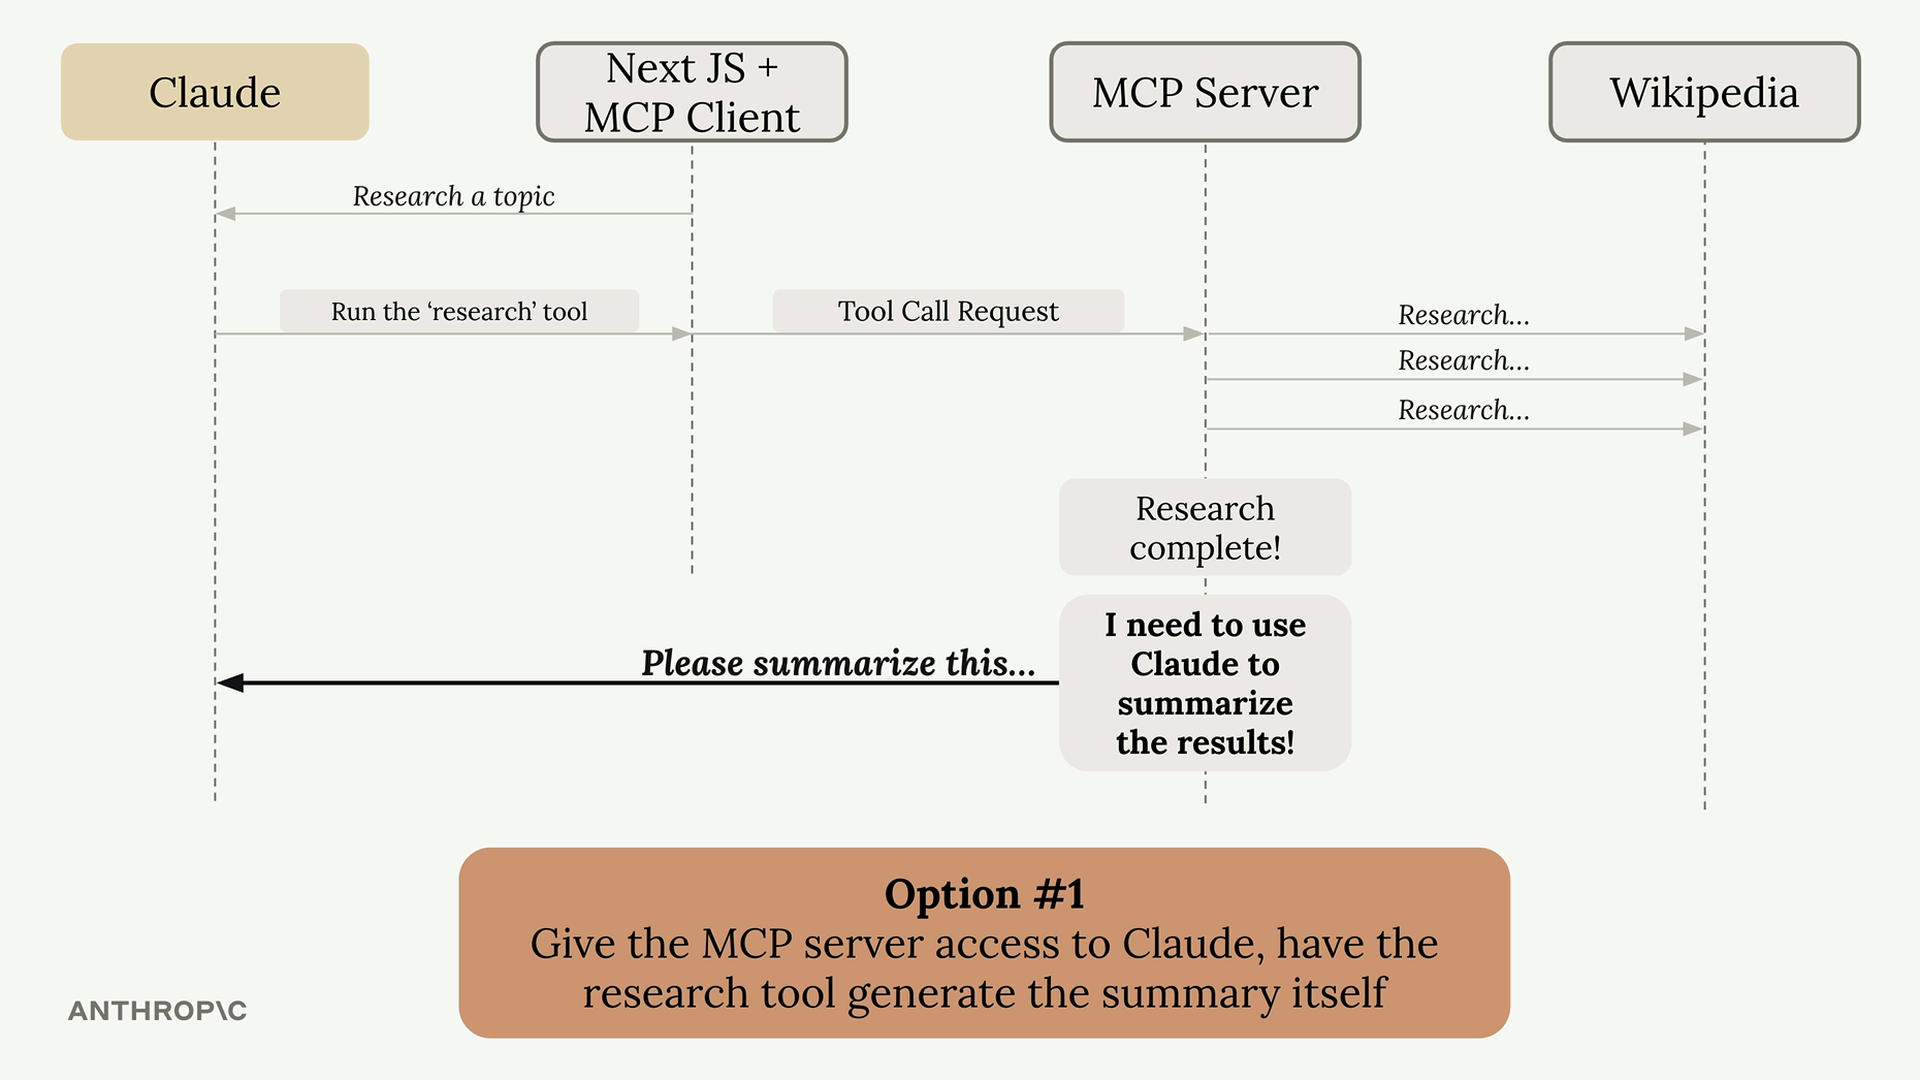
Opción 1: Dale al servidor MCP acceso directo a Claude. El servidor necesitaría su propia clave de API, manejar la autenticación, gestionar los costos e implementar todo el código de integración con Claude. Esto funciona, pero añade una complejidad significativa.
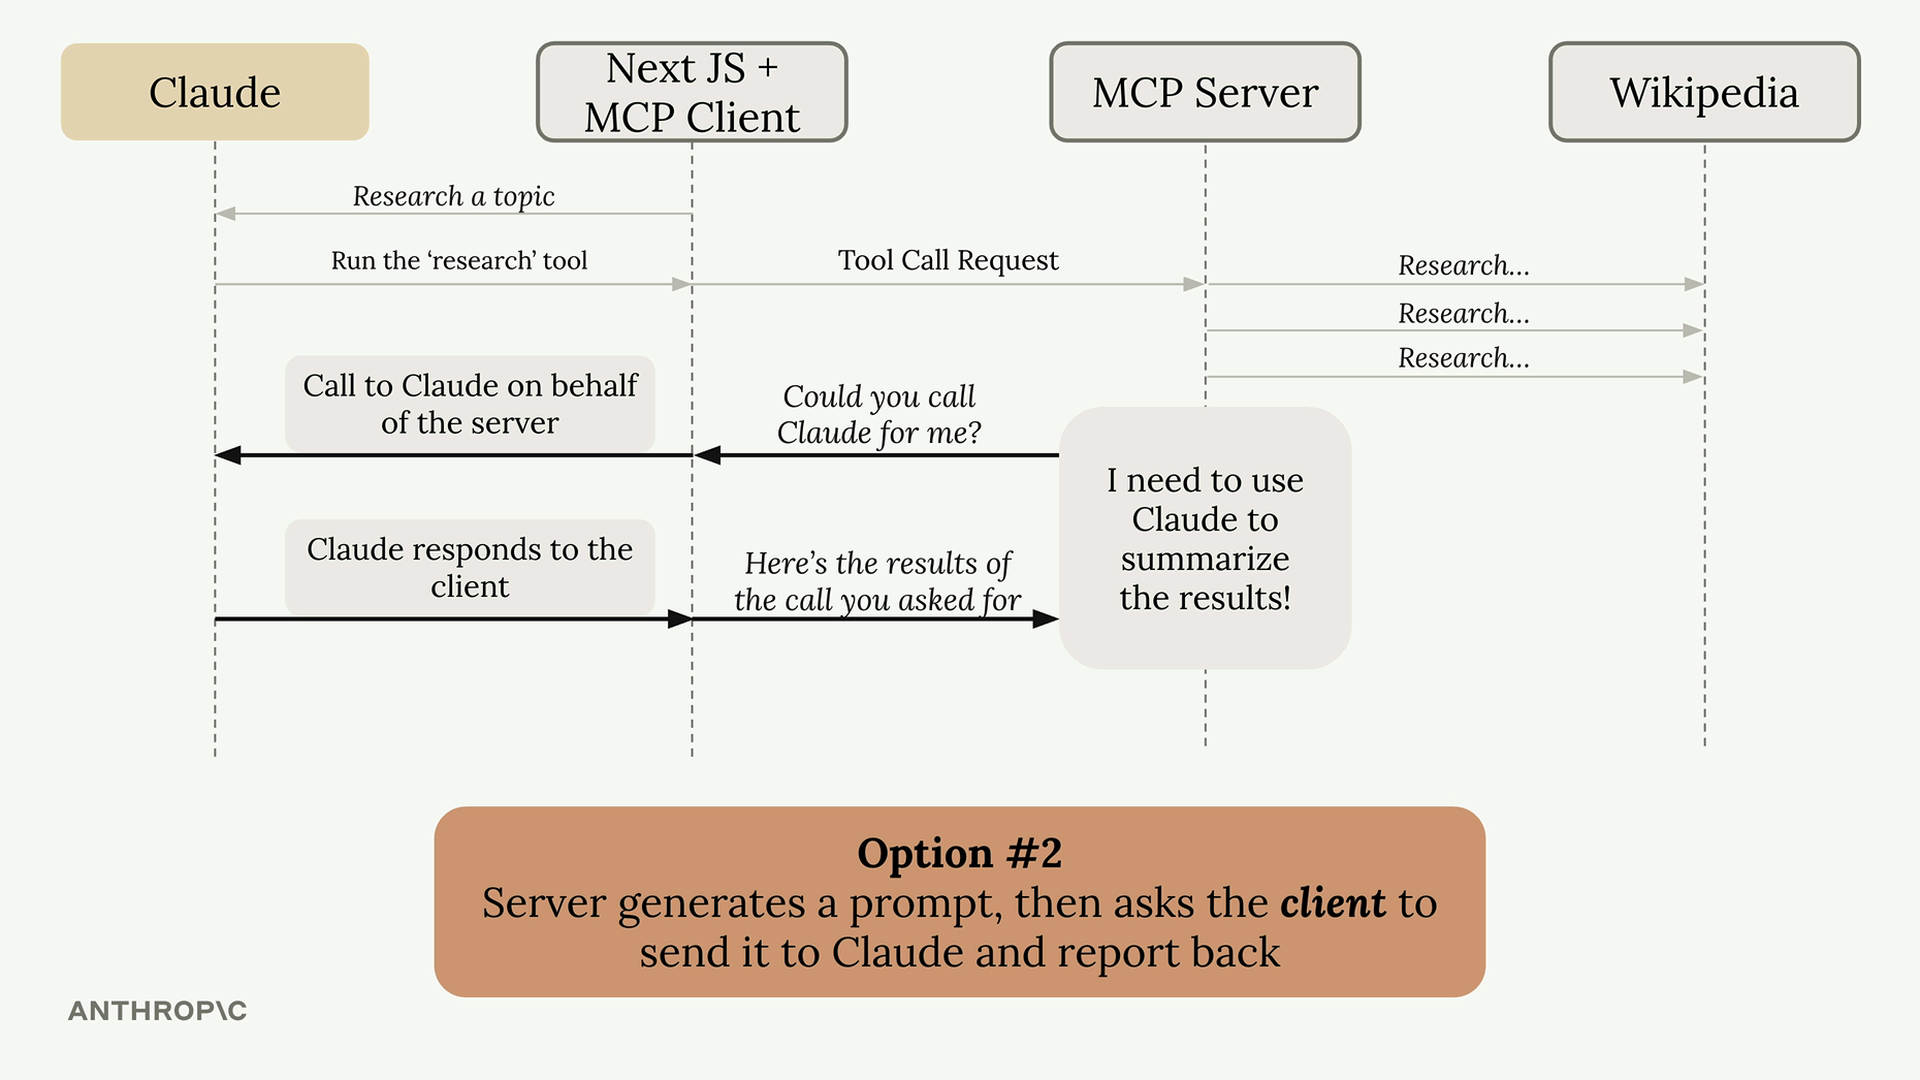
Opción 2: Usa sampling. El servidor genera un prompt y le pregunta al cliente "¿Podrías llamar a Claude por mí?". El cliente, que ya tiene una conexión con Claude, hace la llamada y devuelve los resultados.
Cómo funciona Sampling
El flujo es sencillo:
- El servidor completa su trabajo (como obtener artículos de Wikipedia)
- El servidor crea un prompt solicitando la generación de texto
- El servidor envía una solicitud de sampling al cliente
- El cliente llama a Claude con el prompt proporcionado
- El cliente devuelve el texto generado al servidor
- El servidor usa el texto generado en su respuesta
Beneficios de Sampling
- Reduce la complejidad del servidor: El servidor no necesita integrarse directamente con modelos de lenguaje
- Traslada la carga de costos: El cliente paga por el uso de tokens, no el servidor
- No se necesitan claves de API: El servidor no necesita credenciales para Claude
- Perfecto para servidores públicos: No quieres que un servidor público acumule costos de IA por cada usuario
Implementación
Configurar sampling requiere código en ambos lados:
Lado del servidor
En tu función de herramienta, usa la función create_message para solicitar la generación de texto:
@mcp.tool()
async def summarize(text_to_summarize: str, ctx: Context):
    prompt = f"""
    Please summarize the following text:
    {text_to_summarize}
    """

    result = await ctx.session.create_message(
        messages=[
            SamplingMessage(
                role="user",
                content=TextContent(
                    type="text",
                    text=prompt
                )
            )
        ],
        max_tokens=4000,
        system_prompt="You are a helpful research assistant",
    )

    if result.content.type == "text":
        return result.content.text
    else:
        raise ValueError("Sampling failed")
Lado del cliente
Crea un callback de sampling que maneje las solicitudes del servidor:
async def sampling_callback(
    context: RequestContext, params: CreateMessageRequestParams
):
    # Llama a Claude usando el SDK de Anthropic
    text = await chat(params.messages)

    return CreateMessageResult(
        role="assistant",
        model=model,
        content=TextContent(type="text", text=text),
    )
Luego pasa este callback al inicializar tu sesión de cliente:
async with ClientSession(
    read,
    write,
    sampling_callback=sampling_callback
) as session:
    await session.initialize()
Cuándo usar Sampling
Sampling es más valioso cuando se construyen servidores MCP de acceso público. No quieres que usuarios aleatorios generen texto ilimitado a tu costa. Al usar sampling, cada cliente paga por su propio uso de IA mientras sigue beneficiándose de la funcionalidad de tu servidor.
Esta técnica básicamente traslada la complejidad de la integración de IA de tu servidor al cliente, que a menudo ya cuenta con las conexiones y credenciales necesarias.