Evals en producción: CI, batch y drift
Un eval todavía tiene trabajo que hacer después del lanzamiento. En cada pull request, detecta un cambio de prompt que rompe casos antes de que un cliente reciba una respuesta incorrecta. También califica el tráfico en vivo para detectar el drift, una caída lenta en la precisión que ocurre a medida que cambian las entradas reales.
La demostración de este video se grabó en agosto de 2026. Se ejecutó en Claude Haiku 4.5, Claude Sonnet 5 y Claude Opus 5. Los resultados serán diferentes en modelos más nuevos. La demostración de cada lección es una ejecución de eval independiente, por lo que sus puntuaciones y costos no coincidirán con los de otras lecciones.
Tu eval sigue ejecutándose después del lanzamiento, porque dos cosas siguen cambiando. Tu equipo editará el prompt, y una edición puede romper respuestas que antes eran correctas. Las entradas reales también cambian, hasta que dejan de parecerse a las que probaste. Así que el eval se ejecuta en cada edición antes de que se publique, y en el tráfico en vivo después.
Esta lección sigue a Meridian, una consultoría de ingeniería ficticia cuyo prompt lee cada informe mensual de proyecto y devuelve tres campos: el ID del proyecto, el estado del cronograma y el riesgo principal. El eval de Meridian tiene 50 casos. Cada caso es un informe más la respuesta que esperas para él, y los 50 juntos conforman la suite completa.
Estos cuatro pasos mantienen el eval de Meridian funcionando después del lanzamiento:
- Ejecuta algunos casos en cada pull request.
- Evita que un pull request se fusione hasta que pase.
- Ejecuta la suite completa como un solo batch.
- Califica una muestra del tráfico en vivo cada noche.
Ejecuta algunos casos en cada pull request
Agrega un workflow a CI, abreviatura de integración continua, y haz que se ejecute en cada pull request. El workflow ejecuta un smoke eval, que toma suficientemente pocos casos de la suite completa para terminar mientras esperas. Su puntuación aprueba o reprueba una verificación en el pull request. Meridian elige 10 de sus 50 casos para cubrir cada tipo de informe, y los ejecuta en Claude Haiku 4.5 en aproximadamente un minuto.
El umbral es la puntuación mínima para aprobar, y el de Meridian es del 88%, por lo que nueve de los diez casos tienen que tener éxito. El workflow realiza cuatro tareas, en este orden:
- Ejecuta el script de eval y guarda lo que devuelve como JSON.
- Califica esos resultados contra el umbral.
- Comenta en el pull request con los resultados.
- Hace fallar la verificación si la puntuación está por debajo del umbral.
Meridian usa GitHub Actions para esto, pero cualquier sistema de CI capaz de ejecutar tu script de eval puede realizar las mismas cuatro tareas. El archivo en sí está en el recuadro de abajo.
Evita que un pull request se fusione hasta que pase
Activa una regla de protección de rama que convierta el smoke eval en una verificación requerida(se abre en una pestaña nueva), una que debe pasar antes de que un pull request pueda fusionarse. La regla pertenece a la rama, no al archivo de workflow, y sin ella una X roja es solo una advertencia.
En Meridian, un ingeniero abre un pull request llamado "Simplify extraction prompt" que elimina dos reglas. Una le decía a Claude que devolviera null cuando un informe no da ningún riesgo principal, y la otra hacía que Claude citara la línea de la que proviene el riesgo antes de responder.
La ejecución obtiene 80%, por debajo del umbral del 88%. Ambos fallos son casos de riesgo ausente, informes que no tienen sección de riesgo, así que cada uno debería haber devuelto null, pero Claude nombró un riesgo de todas formas.
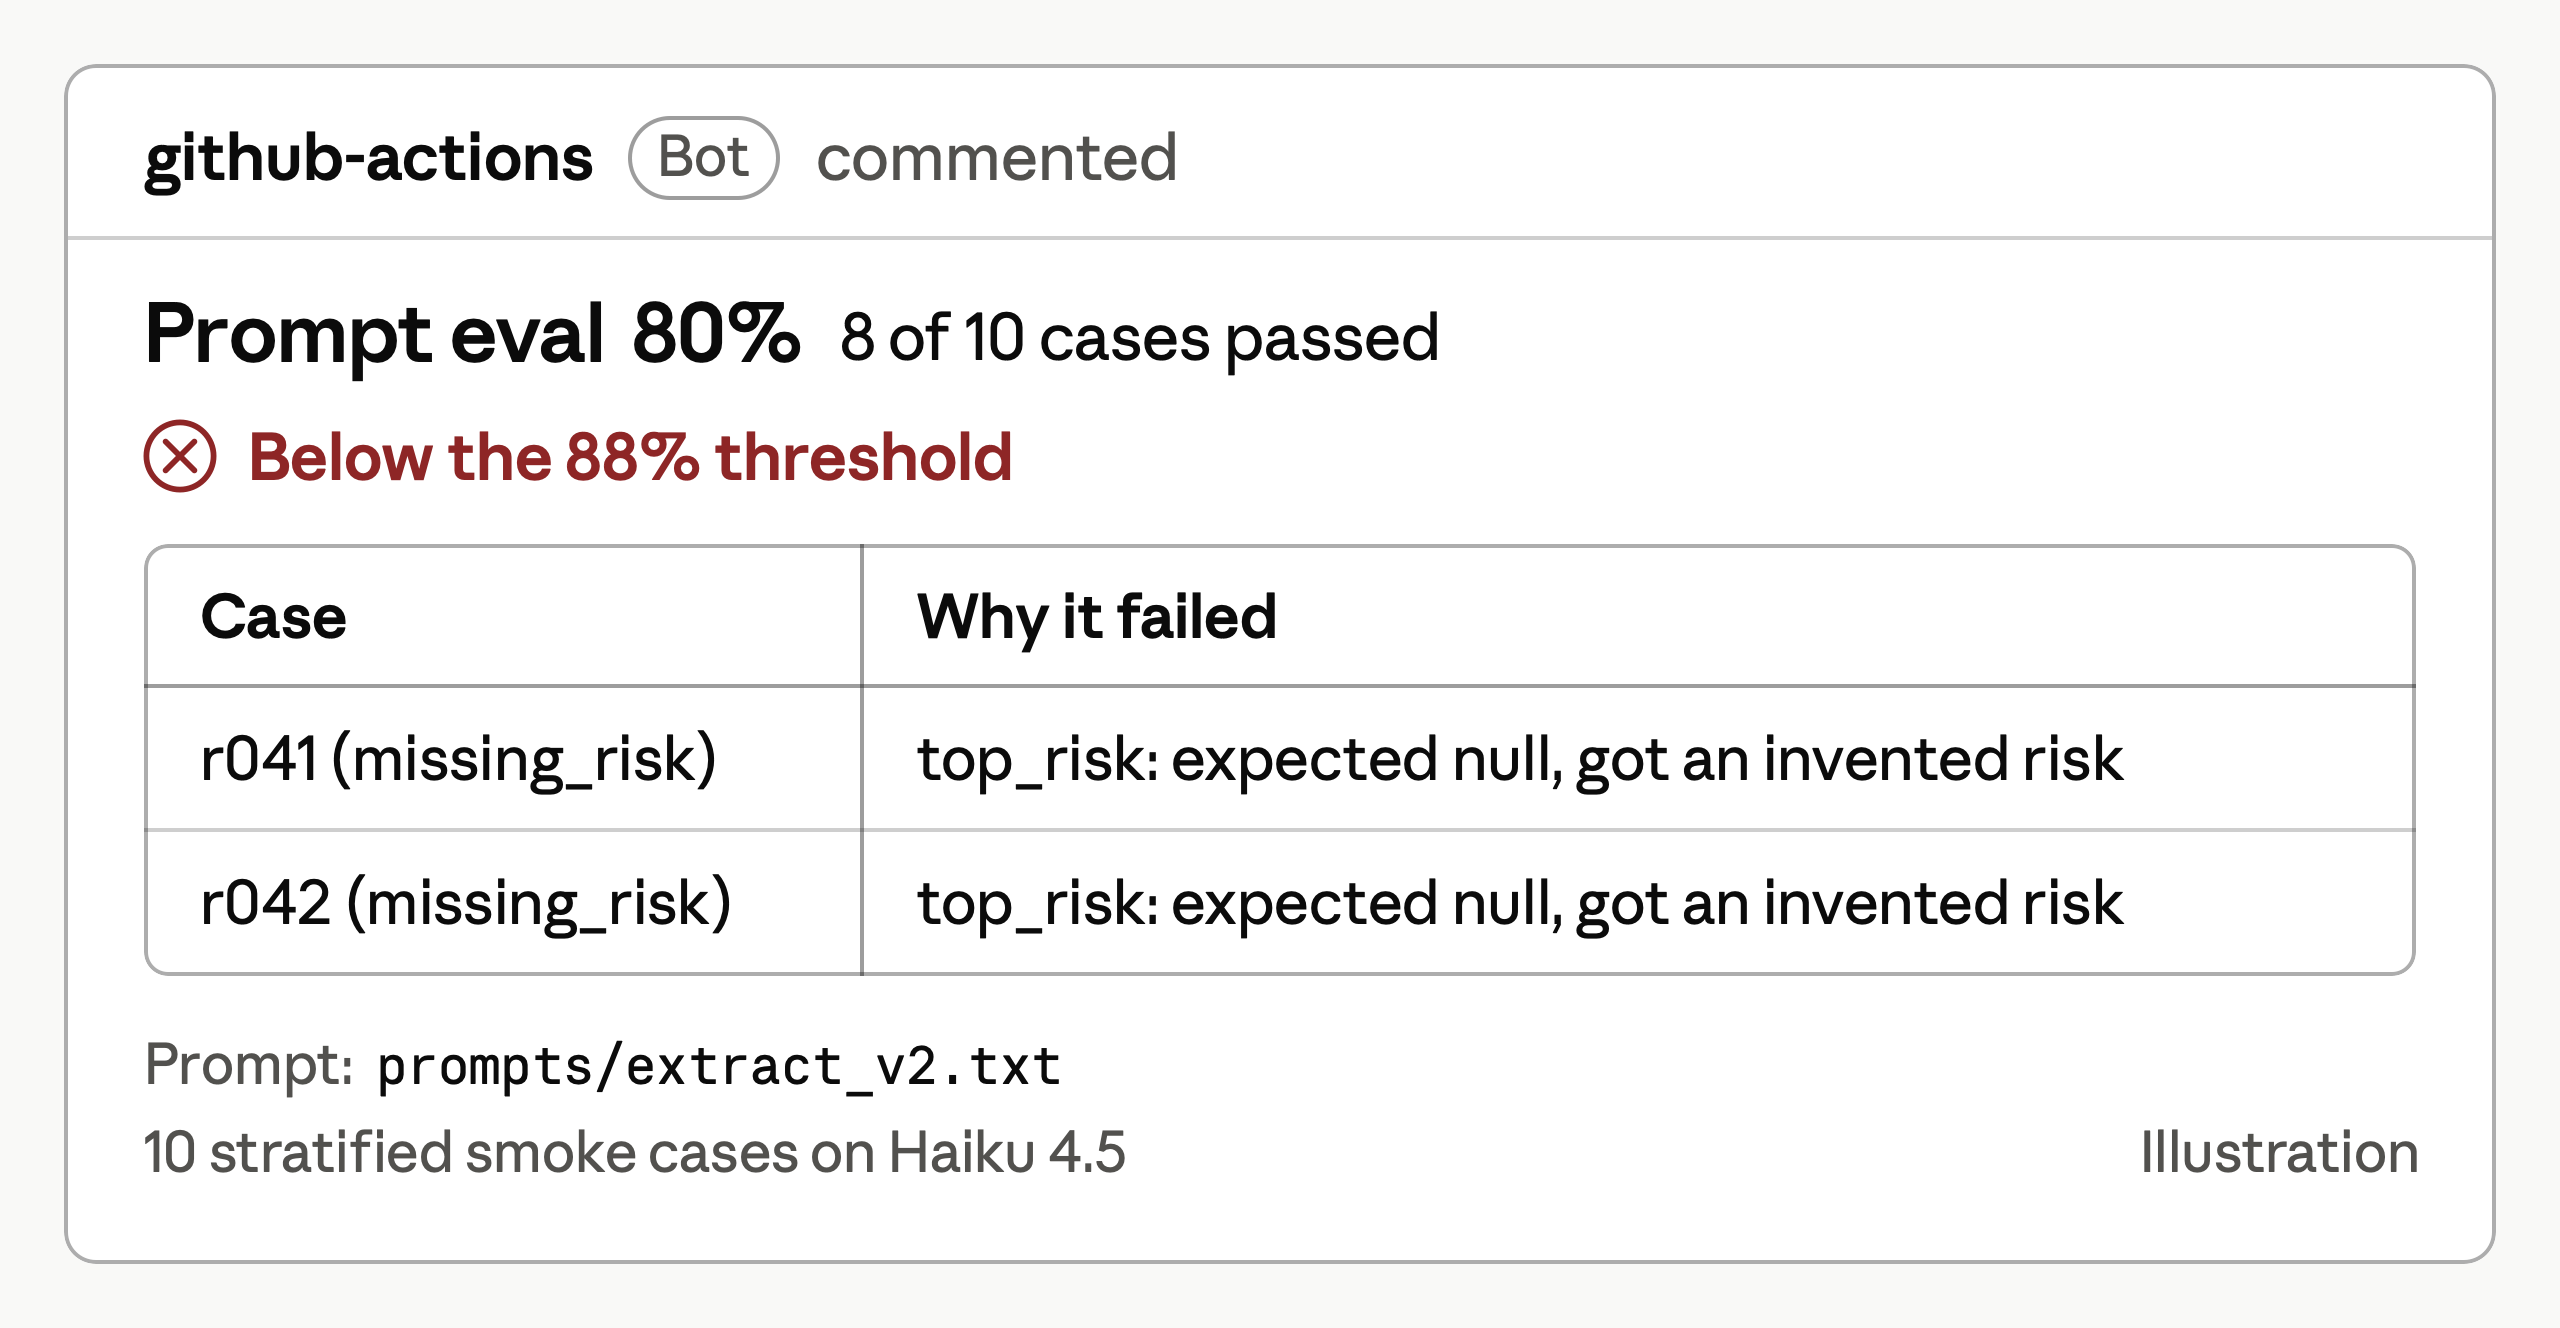
El smoke eval obtiene 80% y no alcanza el umbral del 88%, porque en dos casos de riesgo ausente Claude nombró un riesgo que el informe nunca da.
La verificación roja mantiene el botón de fusión en gris, y su comentario le muestra al ingeniero qué casos fallaron: r041 y r042. Una vez que el prompt se corrige y se envía, la verificación se pone en verde y la fusión puede continuar, por lo que ningún cliente llegó a ver el prompt roto.
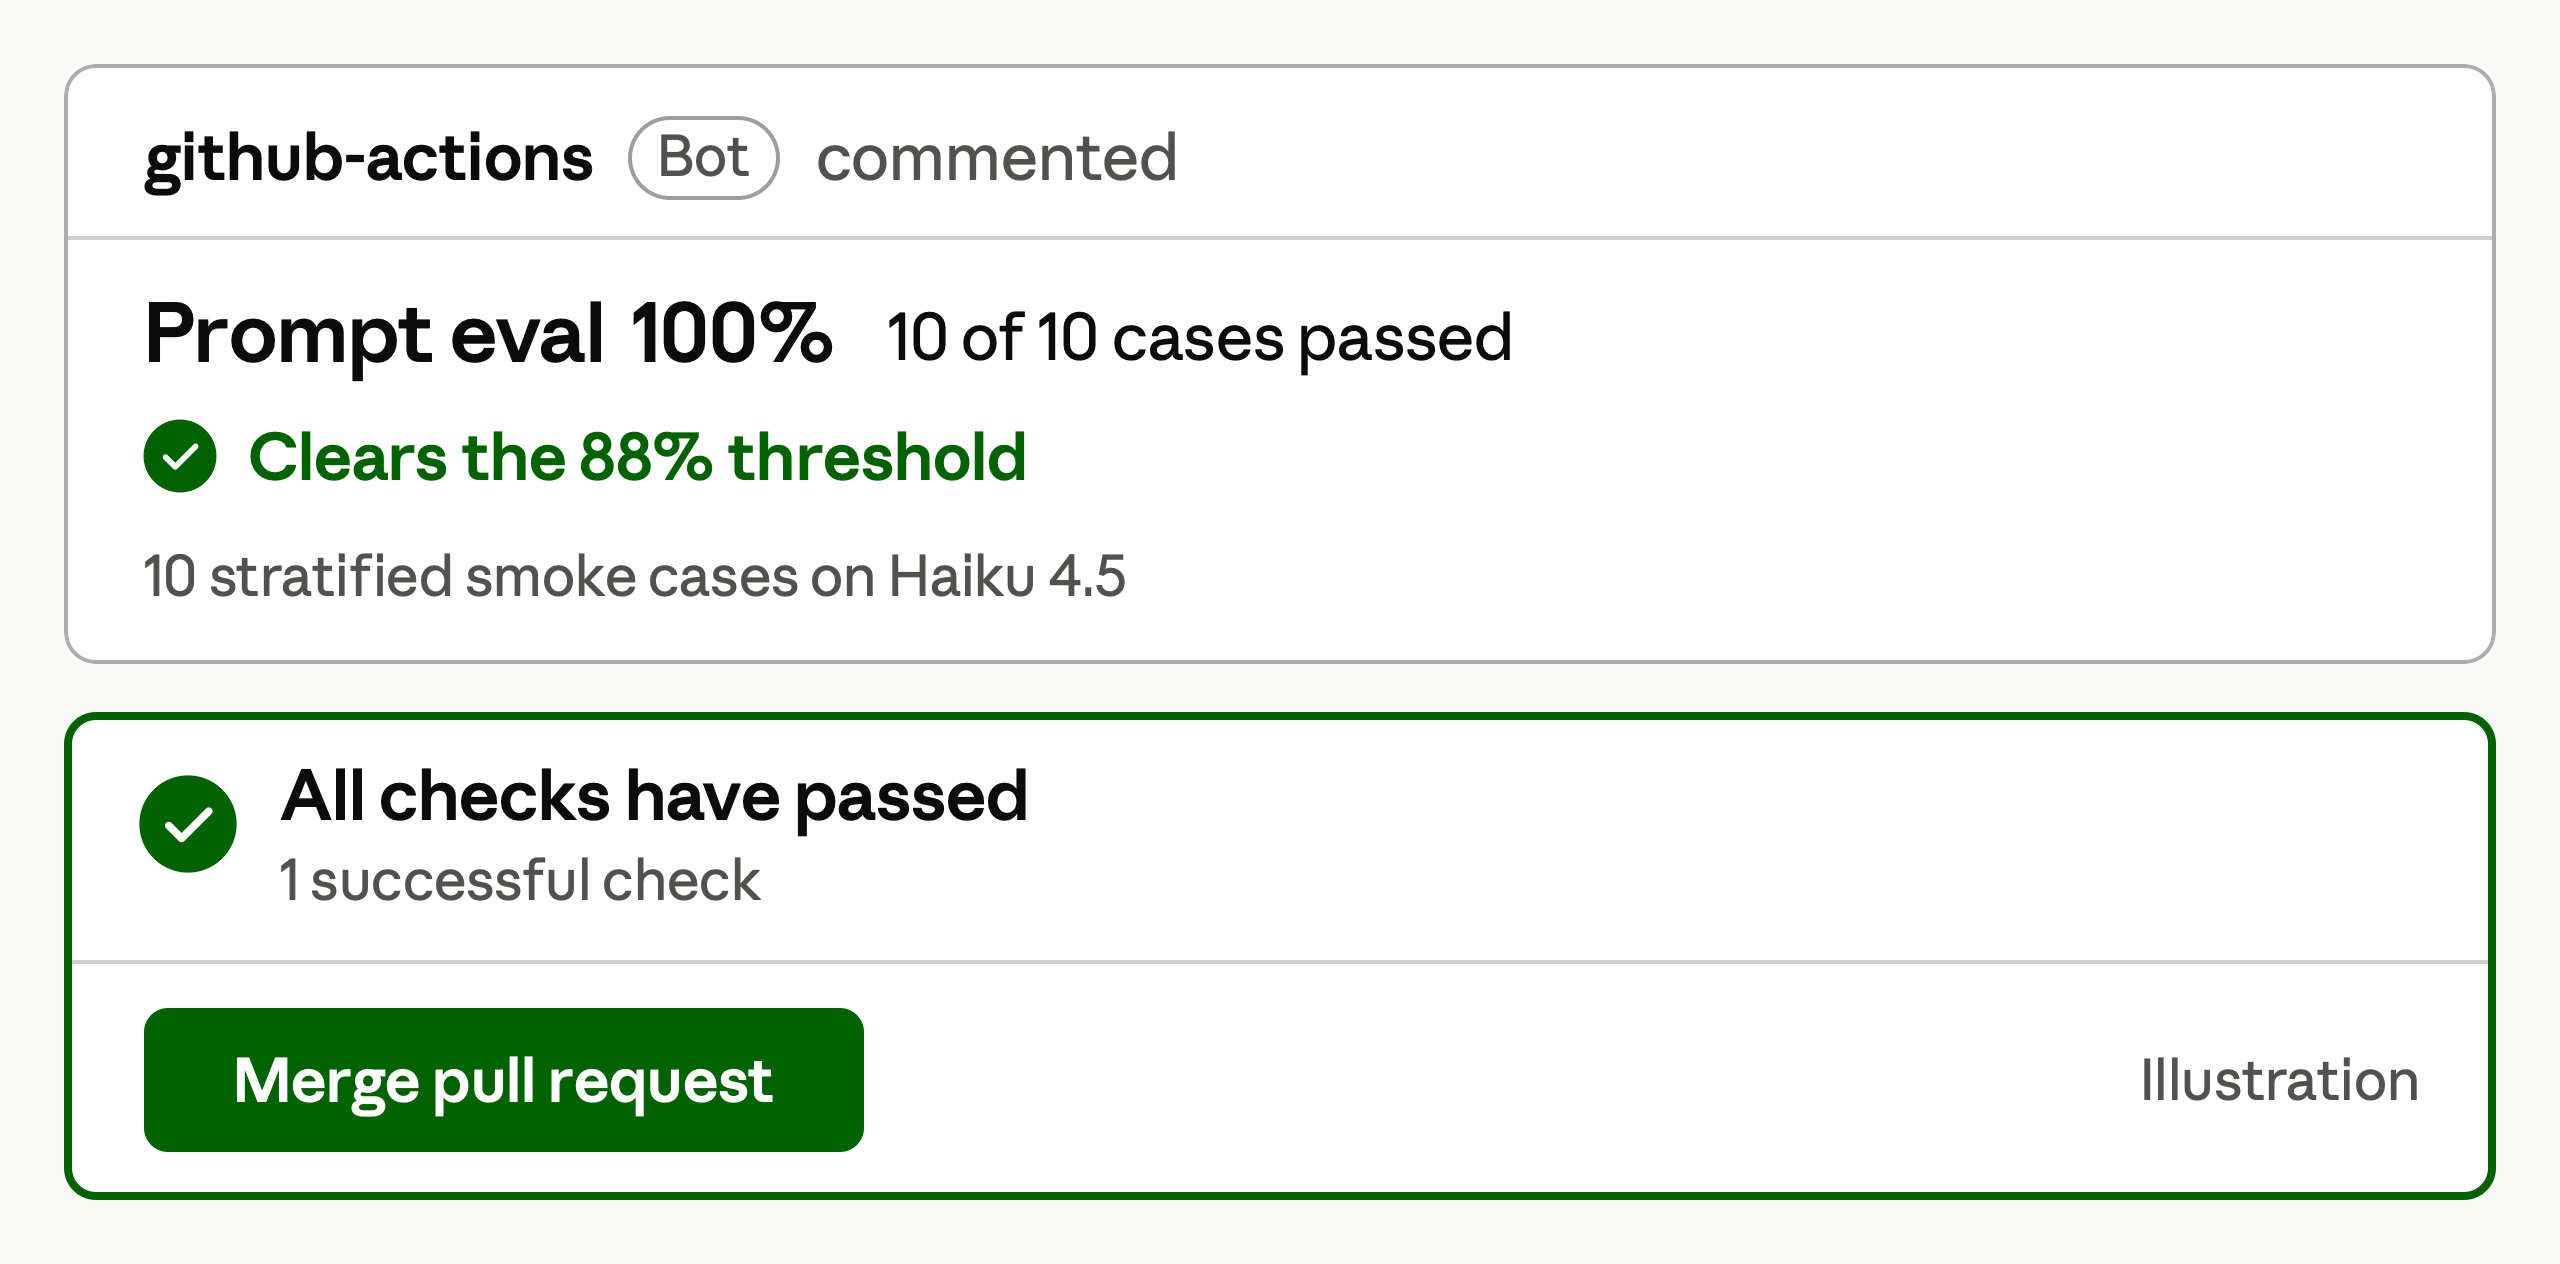
Después de la corrección, todos los casos pasan al 100%, por lo que la fusión ya no está bloqueada.
Ejecuta la suite completa como un solo batch
Ejecuta la suite completa cada vez que cambies el prompt o el modelo(se abre en una pestaña nueva), y envíala a través de la Batch API(se abre en una pestaña nueva). El eval de Meridian compara Haiku 4.5, Claude Sonnet 5 y Claude Opus 5, por lo que su batch contiene 150 solicitudes, los 50 casos completos para cada uno. La Batch API las ejecuta todas por la mitad del precio habitual de los tokens de entrada y salida(se abre en una pestaña nueva), y recoges las respuestas más tarde, generalmente dentro de la hora(se abre en una pestaña nueva).
| Modelo | Precio estándar | Precio Batch API |
|---|---|---|
| Haiku 4.5 | $0.0468 | $0.0234 |
| Sonnet 5 | $0.1301 | $0.0650 |
| Opus 5 | $0.3432 | $0.1716 |
Precios estándar y de Batch API para una pasada por los 50 casos de Meridian en cada modelo, a partir de agosto de 2026. Precios actuales(se abre en una pestaña nueva).
Agrupa en batch las solicitudes que nadie espera, y usa las estándar donde alguien sí espera(se abre en una pestaña nueva). Solo el smoke eval, que una fusión sí espera, se queda en client.messages.create(...).
El script de eval necesita dos cambios.
Etiqueta cada solicitud con un custom_id. Los resultados pueden llegar en cualquier orden(se abre en una pestaña nueva), así que los haces coincidir mediante esta etiqueta, y debe ser única dentro del batch. Cada caso va a tres modelos, así que une el ID del caso al modelo, como en r041_claude-haiku-4-5.
batch = client.messages.batches.create(
    requests=[
        {
            "custom_id": f"{case['id']}_{model}",
            "params": {
                "model": model,
                "max_tokens": 1024,
                "messages": [{"role": "user", "content": case["prompt"]}],
            },
        }
        for model in MODELS
        for case in CASES
    ]
)
Lee request_counts antes de calificar. Cuenta cuántas solicitudes terminaron de cada forma, lo que muestra cuándo una ejecución quedó incompleta. Un batch que no termina dentro de 24 horas expira(se abre en una pestaña nueva), y una solicitud expirada no cuesta nada pero no tiene respuesta(se abre en una pestaña nueva).
batch = client.messages.batches.retrieve(batch.id)
print(batch.request_counts)

answers = {}
for result in client.messages.batches.results(batch.id):
    if result.result.type == "succeeded":
        answers[result.custom_id] = result.result.message
Califica una muestra del tráfico en vivo cada noche
Califica una pequeña muestra del tráfico en vivo, las solicitudes reales que maneja tu aplicación, cada noche. La suite completa solo conoce los informes que tenías cuando la construiste, así que si un nuevo cliente empieza a enviar informes en un formato que ninguno de tus casos cubre, tu CI se mantiene en verde mientras las respuestas empeoran. Esa pérdida lenta de precisión es el drift.
Así es como:
- Muestrea. Elige entre el 1 y el 5% del tráfico en vivo.
- Califica la muestra con un juez LLM(se abre en una pestaña nueva). Eso es un segundo modelo que califica cada respuesta contra una rúbrica de reglas escritas, usando solo el informe, la respuesta de Claude y la rúbrica, por lo que no necesita respuestas esperadas, que el tráfico en vivo no tiene. Aun así, lee tú mismo algunas respuestas de vez en cuando(se abre en una pestaña nueva), porque un juez también necesita ser revisado por una persona.
- Alerta solo ante una caída real. Eso es una puntuación nocturna más de dos desviaciones estándar por debajo de la línea base móvil, el promedio de las noches recientes. Dos desviaciones estándar es un cambio mayor que el que trae una noche normal.
- Crea un caso de cada respuesta que el juez marque como incorrecta. Escribe su respuesta esperada, luego agrega el caso a la suite completa, porque los casos de fallos reales(se abre en una pestaña nueva) mantienen la suite cercana al uso real.
El tráfico en vivo te muestra lo que la suite completa pasa por alto, y cada fallo que agregas reduce esa brecha. Trata el 1 al 5% y las dos desviaciones estándar como puntos de partida para ajustar según tu propio tráfico.
En resumen
- Haz que un smoke eval se ejecute en cada pull request, y deja que su puntuación apruebe o repruebe la verificación.
- Haz que esa verificación sea requerida, para que una puntuación baja realmente detenga la fusión.
- Ejecuta la suite completa como un batch, que cuesta la mitad, porque nadie está esperando por ella.
- Califica una muestra nocturna del tráfico en vivo, alerta cuando la puntuación caiga más de lo usual, y convierte cada fallo en un nuevo caso dentro de la suite completa.