Elegir el modelo correcto
Vas a lanzar una app con Claude. ¿Qué modelo eliges? Si optas por el más inteligente por defecto, tu factura de la API te sorprenderá. Elige el más económico, y puede que el resultado no esté a la altura. Cada modelo tiene distintas compensaciones, y elegir el correcto afecta tanto a la calidad como al costo.
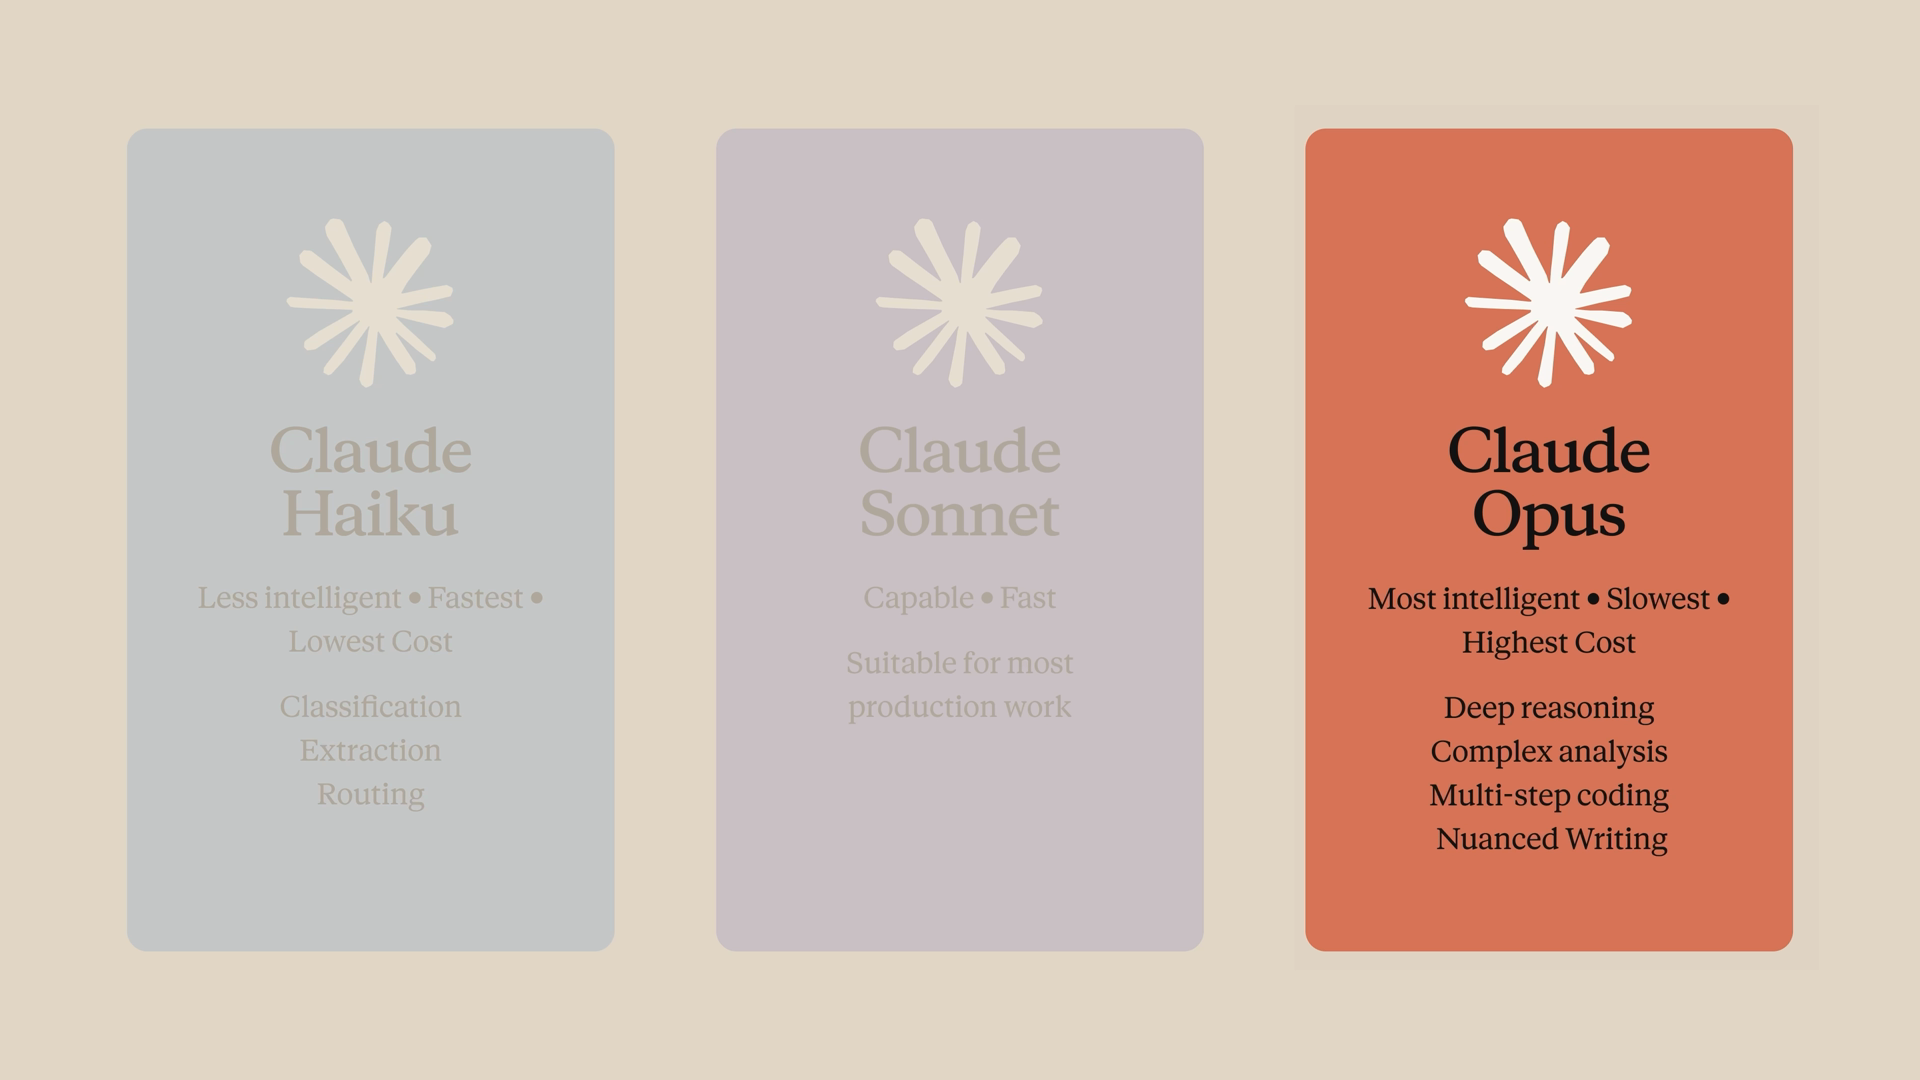
Los niveles de modelos
Anthropic ofrece actualmente cuatro niveles de modelos, y eliges entre ellos con el parámetro model en tu llamada a la API.
- Claude Fable es nuestro modelo más capaz hasta el momento: un nuevo nivel que se sitúa por encima de Opus, diseñado para tus desafíos más exigentes. Tiene un costo mayor que Opus, así que resérvalo para trabajos donde esa capacidad adicional valga la pena pagarse. El modelo Fable actual es Claude Fable 5.1 (
claude-fable-5-1). - Claude Opus es el más capaz de las tres familias de modelos principales, pero también el más lento y el de mayor costo de las tres. Úsalo para razonamiento profundo, análisis complejos, programación de varios pasos y escritura matizada. El modelo Opus actual es Claude Opus 5.5 (
claude-opus-5-5). - Claude Haiku es el más rápido y económico, optimizado para la velocidad y la eficiencia de costos en lugar de la máxima inteligencia. Úsalo para trabajos de alto volumen y baja complejidad, como clasificación, extracción y enrutamiento. El modelo Haiku actual es Claude Haiku 4.5 (
claude-haiku-4-5). - Claude Sonnet se sitúa en el punto óptimo: una combinación equilibrada de inteligencia, velocidad y costo que funciona bien para la mayoría del trabajo en producción. El modelo Sonnet actual es Claude Sonnet 5 (
claude-sonnet-5).
Comienza con una evaluación simple
Antes de escribir código de producción, configura una evaluación simple: un conjunto de ejemplos de entrada que ejecutas en cada modelo y calificas según lo que significa un buen resultado para tu caso de uso. No necesitas nada sofisticado: con 20 o 30 ejemplos representativos de tu carga de trabajo real es suficiente para empezar.
Luego, ve avanzando por los niveles:
- Ejecuta tus ejemplos primero con Haiku. Si la calidad se mantiene, ya terminaste, y acabas de ahorrar mucho dinero.
- Si no es así, sube a Sonnet.
- Recurre a Opus solo cuando la tarea lo requiera.
Comparando los niveles lado a lado
Veamos la diferencia entre los niveles, no solo hablemos de ella. Enviaremos el mismo prompt a través de los tres modelos y observaremos la latencia y los conteos de tokens:
models = ["claude-haiku-4-5", "claude-sonnet-5", "claude-opus-5-5"]

for model in models:
    response = client.messages.create(
        model=model,
        max_tokens=300,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, response.usage)
Aquí están sucediendo dos cosas:
- El bucle cambia el campo
modelen cada solicitud. Mismo prompt, mismo número máximo de tokens; solo cambia el modelo. response.usagete devuelve directamente desde la API los tokens de entrada y de salida, que es sobre lo que se calcula tu factura.
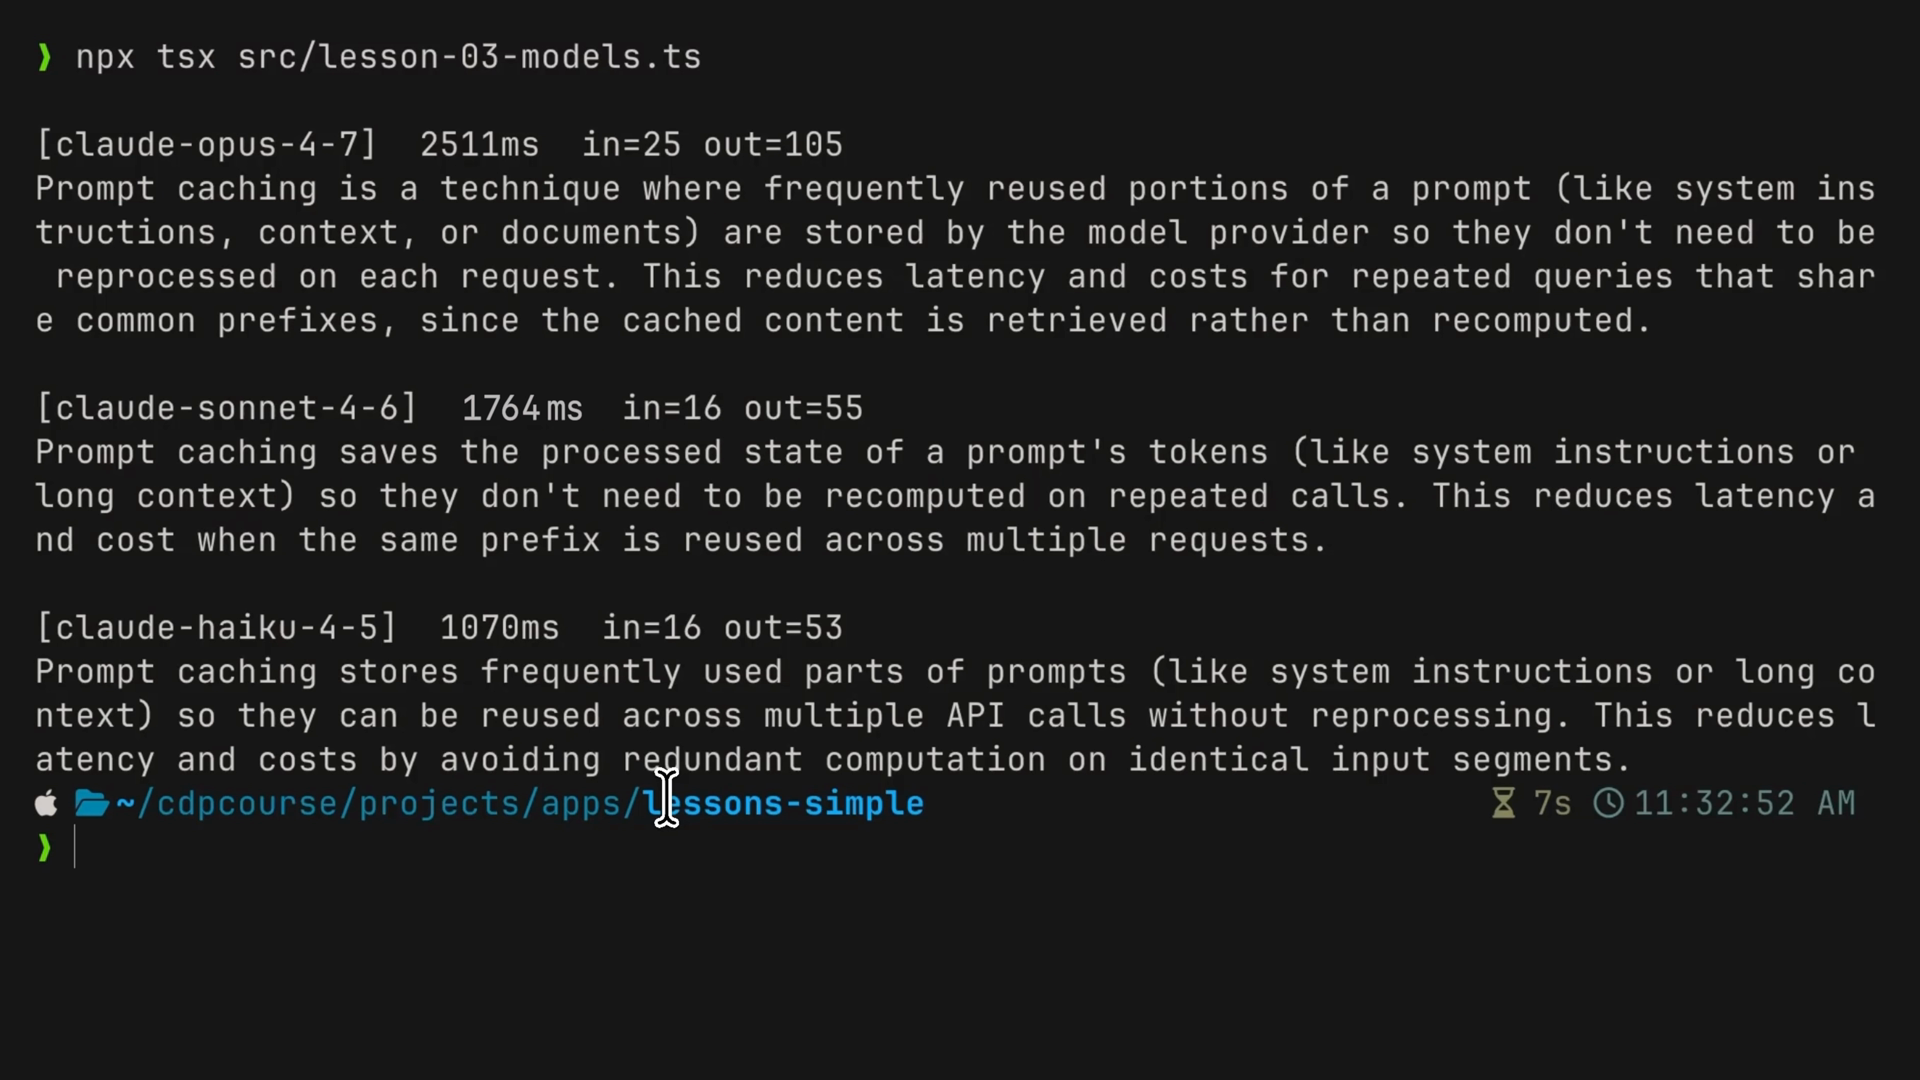
Ejecútalo y verás tres modelos y tres conjuntos de números. Opus tarda más y se lee más pulido, pero para una definición de dos frases, ese pulido se desperdicia. Sonnet ajusta un poco la redacción. Y Haiku responde, a menudo en menos de un segundo, con una respuesta de dos frases muy competente. Es, honestamente, perfecto para este tipo de escenario.
Y en eso consiste todo: el modelo correcto es el más económico cuyo resultado realmente lanzarías. Para una definición, Haiku es más que suficiente. Para redactar una respuesta regulatoria, harías la misma comparación y probablemente terminarías usando Opus. La evaluación tiene la misma estructura siempre.
Enrutar distintos trabajos a distintos modelos
En una app real, enrutarías distintos tipos de trabajo a distintos modelos dentro del mismo endpoint. Toma como ejemplo un panel de operaciones con una ruta de procesamiento de documentos:
- Cada archivo entrante se clasifica con Haiku.
- Las actualizaciones para clientes se redactan con Sonnet.
- Solo las respuestas a RFP recurren a Opus.
Una cola, tres modelos, elegidos según la tarea.
Resumen
- Anthropic ofrece cuatro niveles de modelos: Fable para la máxima capacidad disponible, Opus para problemas difíciles, Sonnet para el trabajo diario y Haiku para volumen.
- Configura una evaluación simple (20 o 30 ejemplos representativos de tu carga de trabajo real) antes de escribir código de producción.
- Ejecuta la evaluación desde Haiku hacia arriba y detente en el modelo más económico cuyo resultado realmente lanzarías.
response.usagereporta los tokens de entrada y de salida, que es en lo que se basa tu factura.- En producción, enruta distintas tareas a distintos modelos dentro del mismo endpoint en lugar de elegir un solo modelo para todo.