Sampling ermöglicht es einem Server, über einen verbundenen MCP-Client auf ein Sprachmodell wie Claude zuzugreifen. Anstatt dass der Server Claude direkt aufruft, bittet er den Client, den Aufruf in seinem Namen durchzuführen. Dadurch verlagert sich die Verantwortung und die Kosten der Textgenerierung vom Server auf den Client.
Das Problem, das Sampling löst
Stell dir vor, du hast einen MCP-Server mit einem Recherche-Tool, das Informationen von Wikipedia abruft. Nachdem all diese Daten gesammelt wurden, musst du sie zu einem zusammenhängenden Bericht zusammenfassen. Du hast zwei Möglichkeiten:
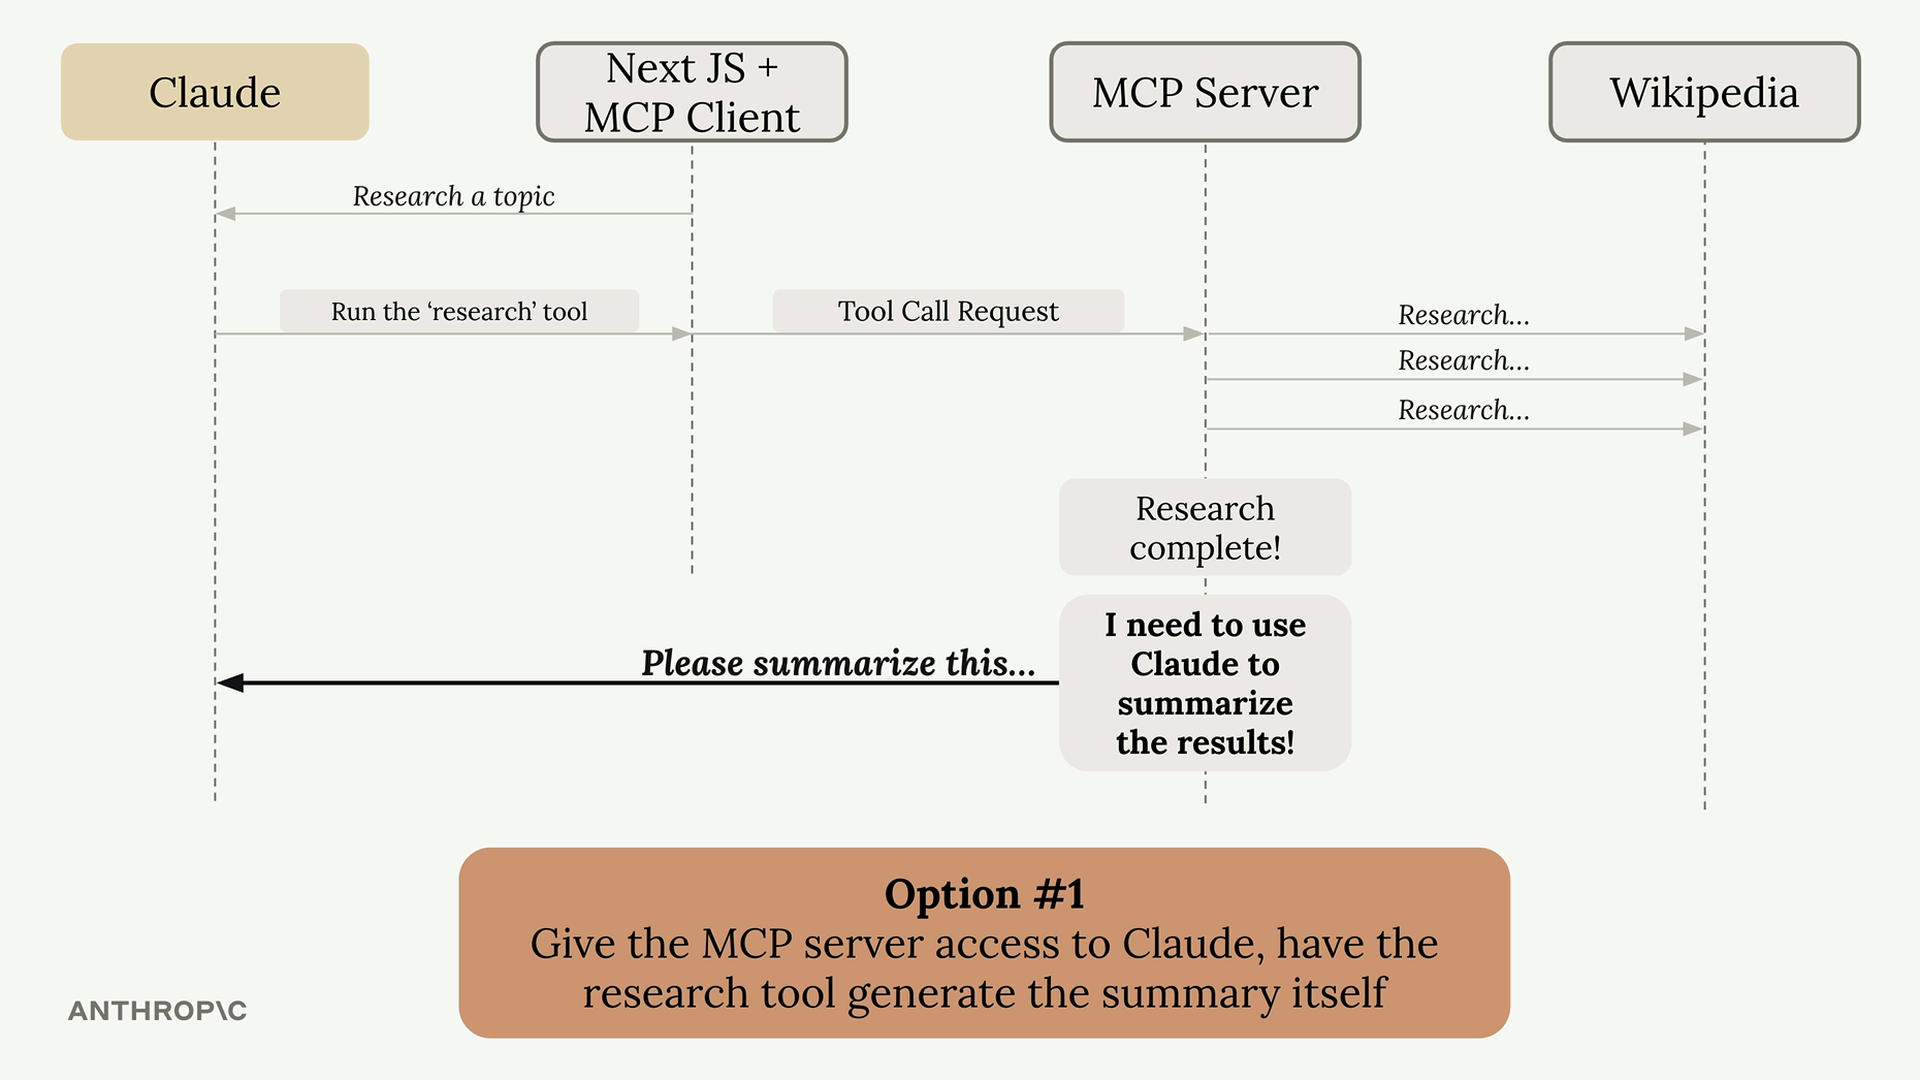
Option 1: Gib dem MCP-Server direkten Zugriff auf Claude. Der Server bräuchte einen eigenen API-Key, müsste die Authentifizierung übernehmen, die Kosten verwalten und den gesamten Claude-Integrationscode implementieren. Das funktioniert, fügt aber erhebliche Komplexität hinzu.
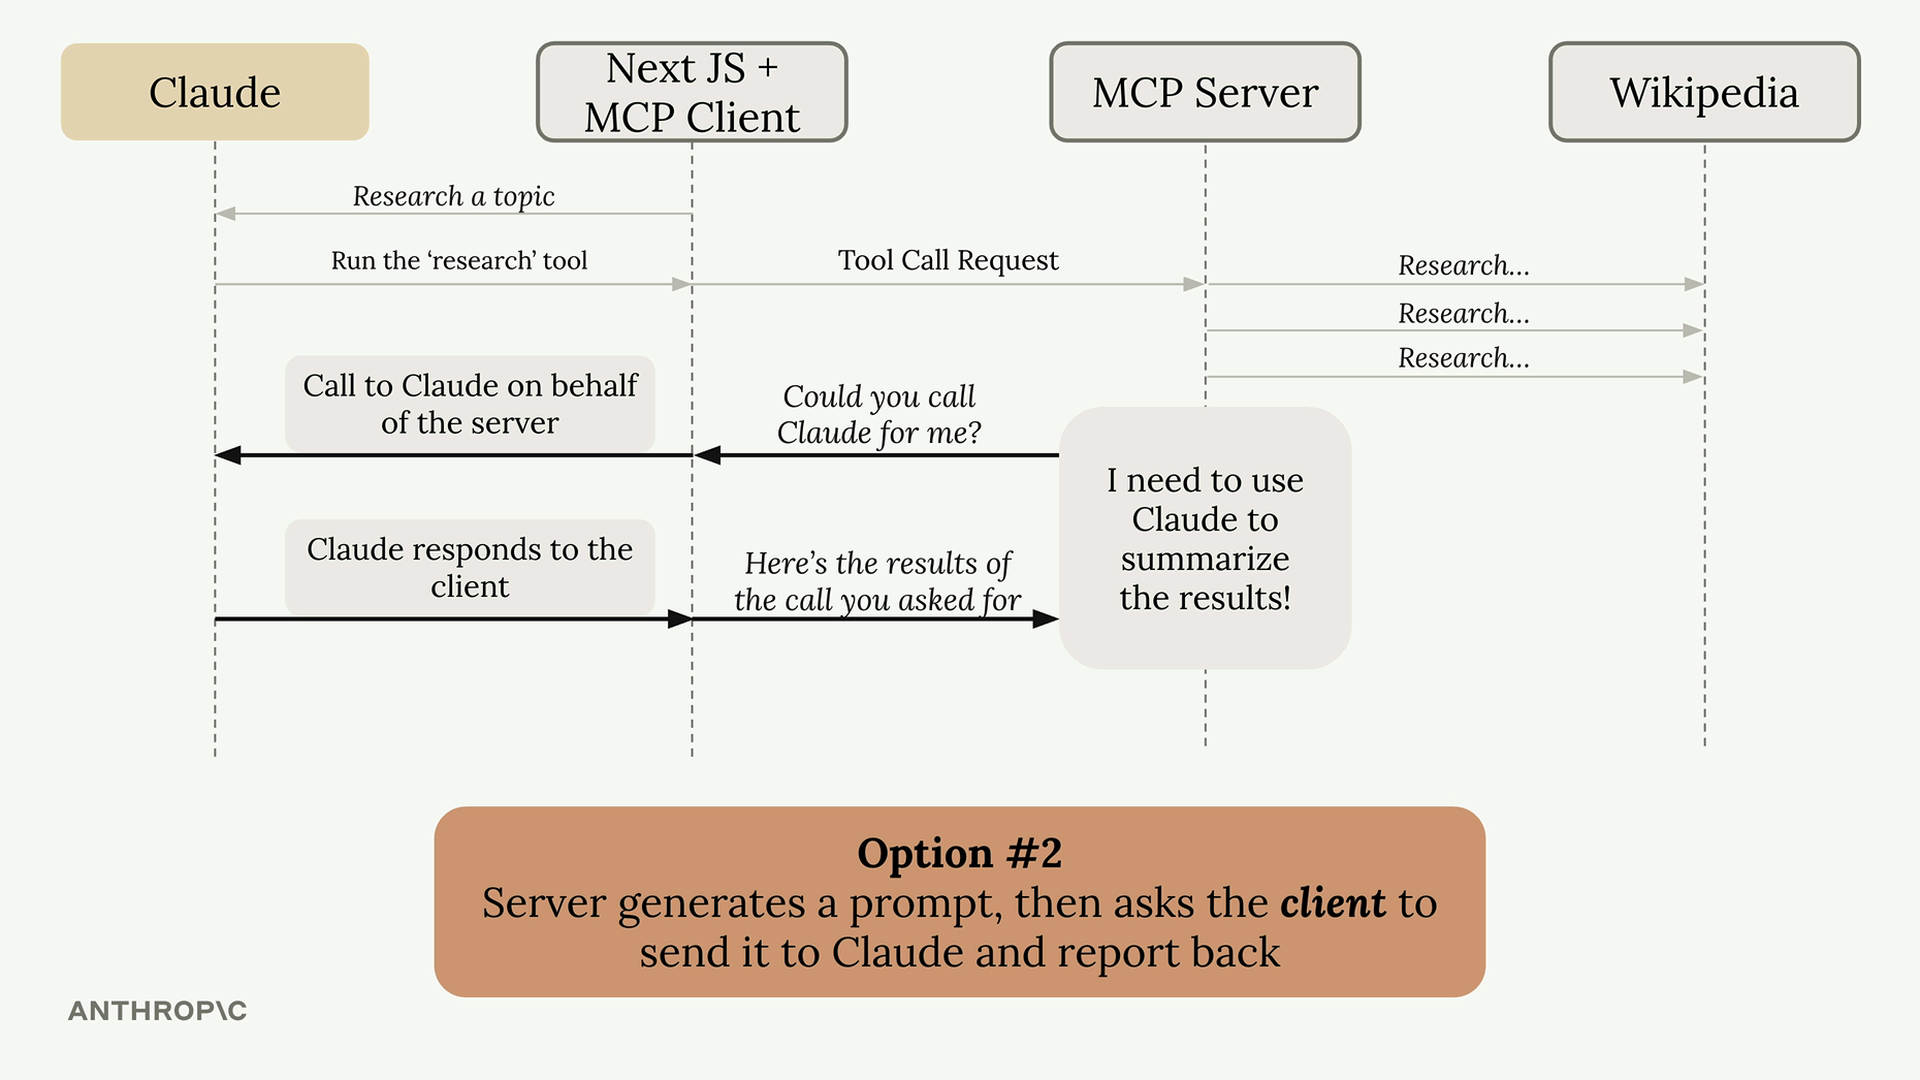
Option 2: Verwende Sampling. Der Server erstellt einen Prompt und fragt den Client „Könntest du Claude für mich aufrufen?" Der Client, der bereits eine Verbindung zu Claude hat, führt den Aufruf durch und gibt die Ergebnisse zurück.
Wie Sampling funktioniert
Der Ablauf ist unkompliziert:
- Der Server schließt seine Arbeit ab (z. B. das Abrufen von Wikipedia-Artikeln)
- Der Server erstellt einen Prompt, der eine Textgenerierung anfordert
- Der Server sendet eine Sampling-Anfrage an den Client
- Der Client ruft Claude mit dem bereitgestellten Prompt auf
- Der Client gibt den generierten Text an den Server zurück
- Der Server verwendet den generierten Text in seiner Antwort
Vorteile von Sampling
- Reduziert die Server-Komplexität: Der Server muss sich nicht direkt in Sprachmodelle integrieren
- Verlagert die Kostenlast: Der Client zahlt für die Token-Nutzung, nicht der Server
- Keine API-Keys erforderlich: Der Server benötigt keine Anmeldedaten für Claude
- Perfekt für öffentliche Server: Du möchtest nicht, dass ein öffentlicher Server für jeden Nutzer KI-Kosten anhäuft
Implementierung
Die Einrichtung von Sampling erfordert Code auf beiden Seiten:
Server-Seite
Verwende in deiner Tool-Funktion die Funktion create_message, um eine Textgenerierung anzufordern:
@mcp.tool()
async def summarize(text_to_summarize: str, ctx: Context):
    prompt = f"""
    Please summarize the following text:
    {text_to_summarize}
    """

    result = await ctx.session.create_message(
        messages=[
            SamplingMessage(
                role="user",
                content=TextContent(
                    type="text",
                    text=prompt
                )
            )
        ],
        max_tokens=4000,
        system_prompt="You are a helpful research assistant",
    )

    if result.content.type == "text":
        return result.content.text
    else:
        raise ValueError("Sampling failed")
Client-Seite
Erstelle einen Sampling-Callback, der die Anfragen des Servers verarbeitet:
async def sampling_callback(
    context: RequestContext, params: CreateMessageRequestParams
):
    # Rufe Claude mit dem Anthropic SDK auf
    text = await chat(params.messages)

    return CreateMessageResult(
        role="assistant",
        model=model,
        content=TextContent(type="text", text=text),
    )
Übergib diesen Callback dann bei der Initialisierung deiner Client-Session:
async with ClientSession(
    read,
    write,
    sampling_callback=sampling_callback
) as session:
    await session.initialize()
Wann Sampling verwendet werden sollte
Sampling ist am wertvollsten beim Erstellen öffentlich zugänglicher MCP-Server. Du möchtest nicht, dass beliebige Nutzer auf deine Kosten unbegrenzt Text generieren. Durch die Verwendung von Sampling zahlt jeder Client für seine eigene KI-Nutzung und profitiert dennoch von der Funktionalität deines Servers.
Die Technik verlagert im Wesentlichen die Komplexität der KI-Integration von deinem Server auf den Client, der oft bereits über die notwendigen Verbindungen und Anmeldedaten verfügt.