Evals in Produktion: CI, Batch und Drift
Ein Eval hat auch nach dem Launch noch Arbeit zu erledigen. Bei jedem Pull Request erkennt es eine Prompt-Änderung, die Fälle bricht, bevor ein Kunde eine falsche Antwort erhält. Außerdem bewertet es Live-Traffic, um Drift zu erkennen, einen langsamen Rückgang der Genauigkeit, der entsteht, wenn sich reale Eingaben ändern.
Die Demo in diesem Video wurde im August 2026 aufgezeichnet. Sie lief auf Claude Haiku 4.5, Claude Sonnet 5 und Claude Opus 5. Bei neueren Modellen werden die Ergebnisse abweichen. Die Demo jeder Lektion ist ein separater Eval-Lauf, daher stimmen ihre Werte und Kosten nicht mit denen anderer Lektionen überein.
Dein Eval läuft auch nach dem Launch weiter, weil sich zwei Dinge ständig ändern. Dein Team wird den Prompt bearbeiten, und eine Änderung kann Antworten zerstören, die vorher richtig waren. Auch reale Eingaben ändern sich, bis sie irgendwann nicht mehr wie die aussehen, die du getestet hast. Deshalb läuft der Eval bei jeder Änderung, bevor sie ausgeliefert wird, und danach auf Live-Traffic.
Diese Lektion begleitet Meridian, eine fiktive Ingenieur-Beratung, deren Prompt jeden monatlichen Projektbericht liest und drei Felder zurückgibt: die Projekt-ID, den Terminstatus und das größte Risiko. Meridians Eval hat 50 Fälle. Jeder Fall besteht aus einem Bericht plus der erwarteten Antwort dafür, und alle 50 zusammen bilden die vollständige Suite.
Diese vier Schritte halten Meridians Eval auch nach dem Launch am Laufen:
- Führe bei jedem Pull Request ein paar Fälle aus.
- Verhindere, dass ein Pull Request gemerged wird, bevor er besteht.
- Führe die vollständige Suite als einen Batch aus.
- Bewerte jede Nacht eine Stichprobe des Live-Traffics.
Führe bei jedem Pull Request ein paar Fälle aus
Füge der CI, kurz für Continuous Integration, einen Workflow hinzu und lass ihn bei jedem Pull Request laufen. Der Workflow führt einen Smoke-Eval aus, der so wenige Fälle der vollständigen Suite verwendet, dass er fertig wird, während du wartest. Sein Ergebnis lässt einen Check am Pull Request bestehen oder fehlschlagen. Meridian wählt 10 seiner 50 Fälle aus, um jede Art von Bericht abzudecken, und führt sie in etwa einer Minute auf Claude Haiku 4.5 aus.
Der Schwellenwert ist der niedrigste bestandene Wert, und Meridians liegt bei 88 %, sodass neun der zehn Fälle erfolgreich sein müssen. Der Workflow erledigt vier Aufgaben in dieser Reihenfolge:
- Führe das Eval-Skript aus und speichere die Rückgabe als JSON.
- Bewerte diese Ergebnisse anhand des Schwellenwerts.
- Kommentiere den Pull Request mit den Ergebnissen.
- Lass den Check fehlschlagen, wenn der Wert unter dem Schwellenwert liegt.
Meridian nutzt dafür GitHub Actions, aber jedes CI-System, das dein Eval-Skript ausführen kann, kann dieselben vier Aufgaben erledigen. Die Datei selbst findest du im Kasten unten.
Verhindere, dass ein Pull Request gemerged wird, bevor er besteht
Aktiviere eine Branch-Protection-Regel, die den Smoke-Eval zu einem erforderlichen Check(öffnet in neuem Tab) macht, der bestehen muss, bevor ein Pull Request gemerged werden kann. Die Regel gehört zum Branch, nicht zur Workflow-Datei, und ohne sie ist ein rotes X nur eine Warnung.
Bei Meridian öffnet ein Ingenieur einen Pull Request namens „Simplify extraction prompt“, der zwei Regeln entfernt. Eine wies Claude an, null zurückzugeben, wenn ein Bericht kein größtes Risiko angibt, die andere ließ Claude die Zeile zitieren, aus der das Risiko stammt, bevor es antwortet.
Der Lauf erreicht 80 %, unter dem Schwellenwert von 88 %. Beide Fehler sind Fälle mit fehlendem Risiko, Berichte ohne Risikoabschnitt, bei denen also jeweils null hätte zurückkommen sollen, aber Claude nannte trotzdem ein Risiko.
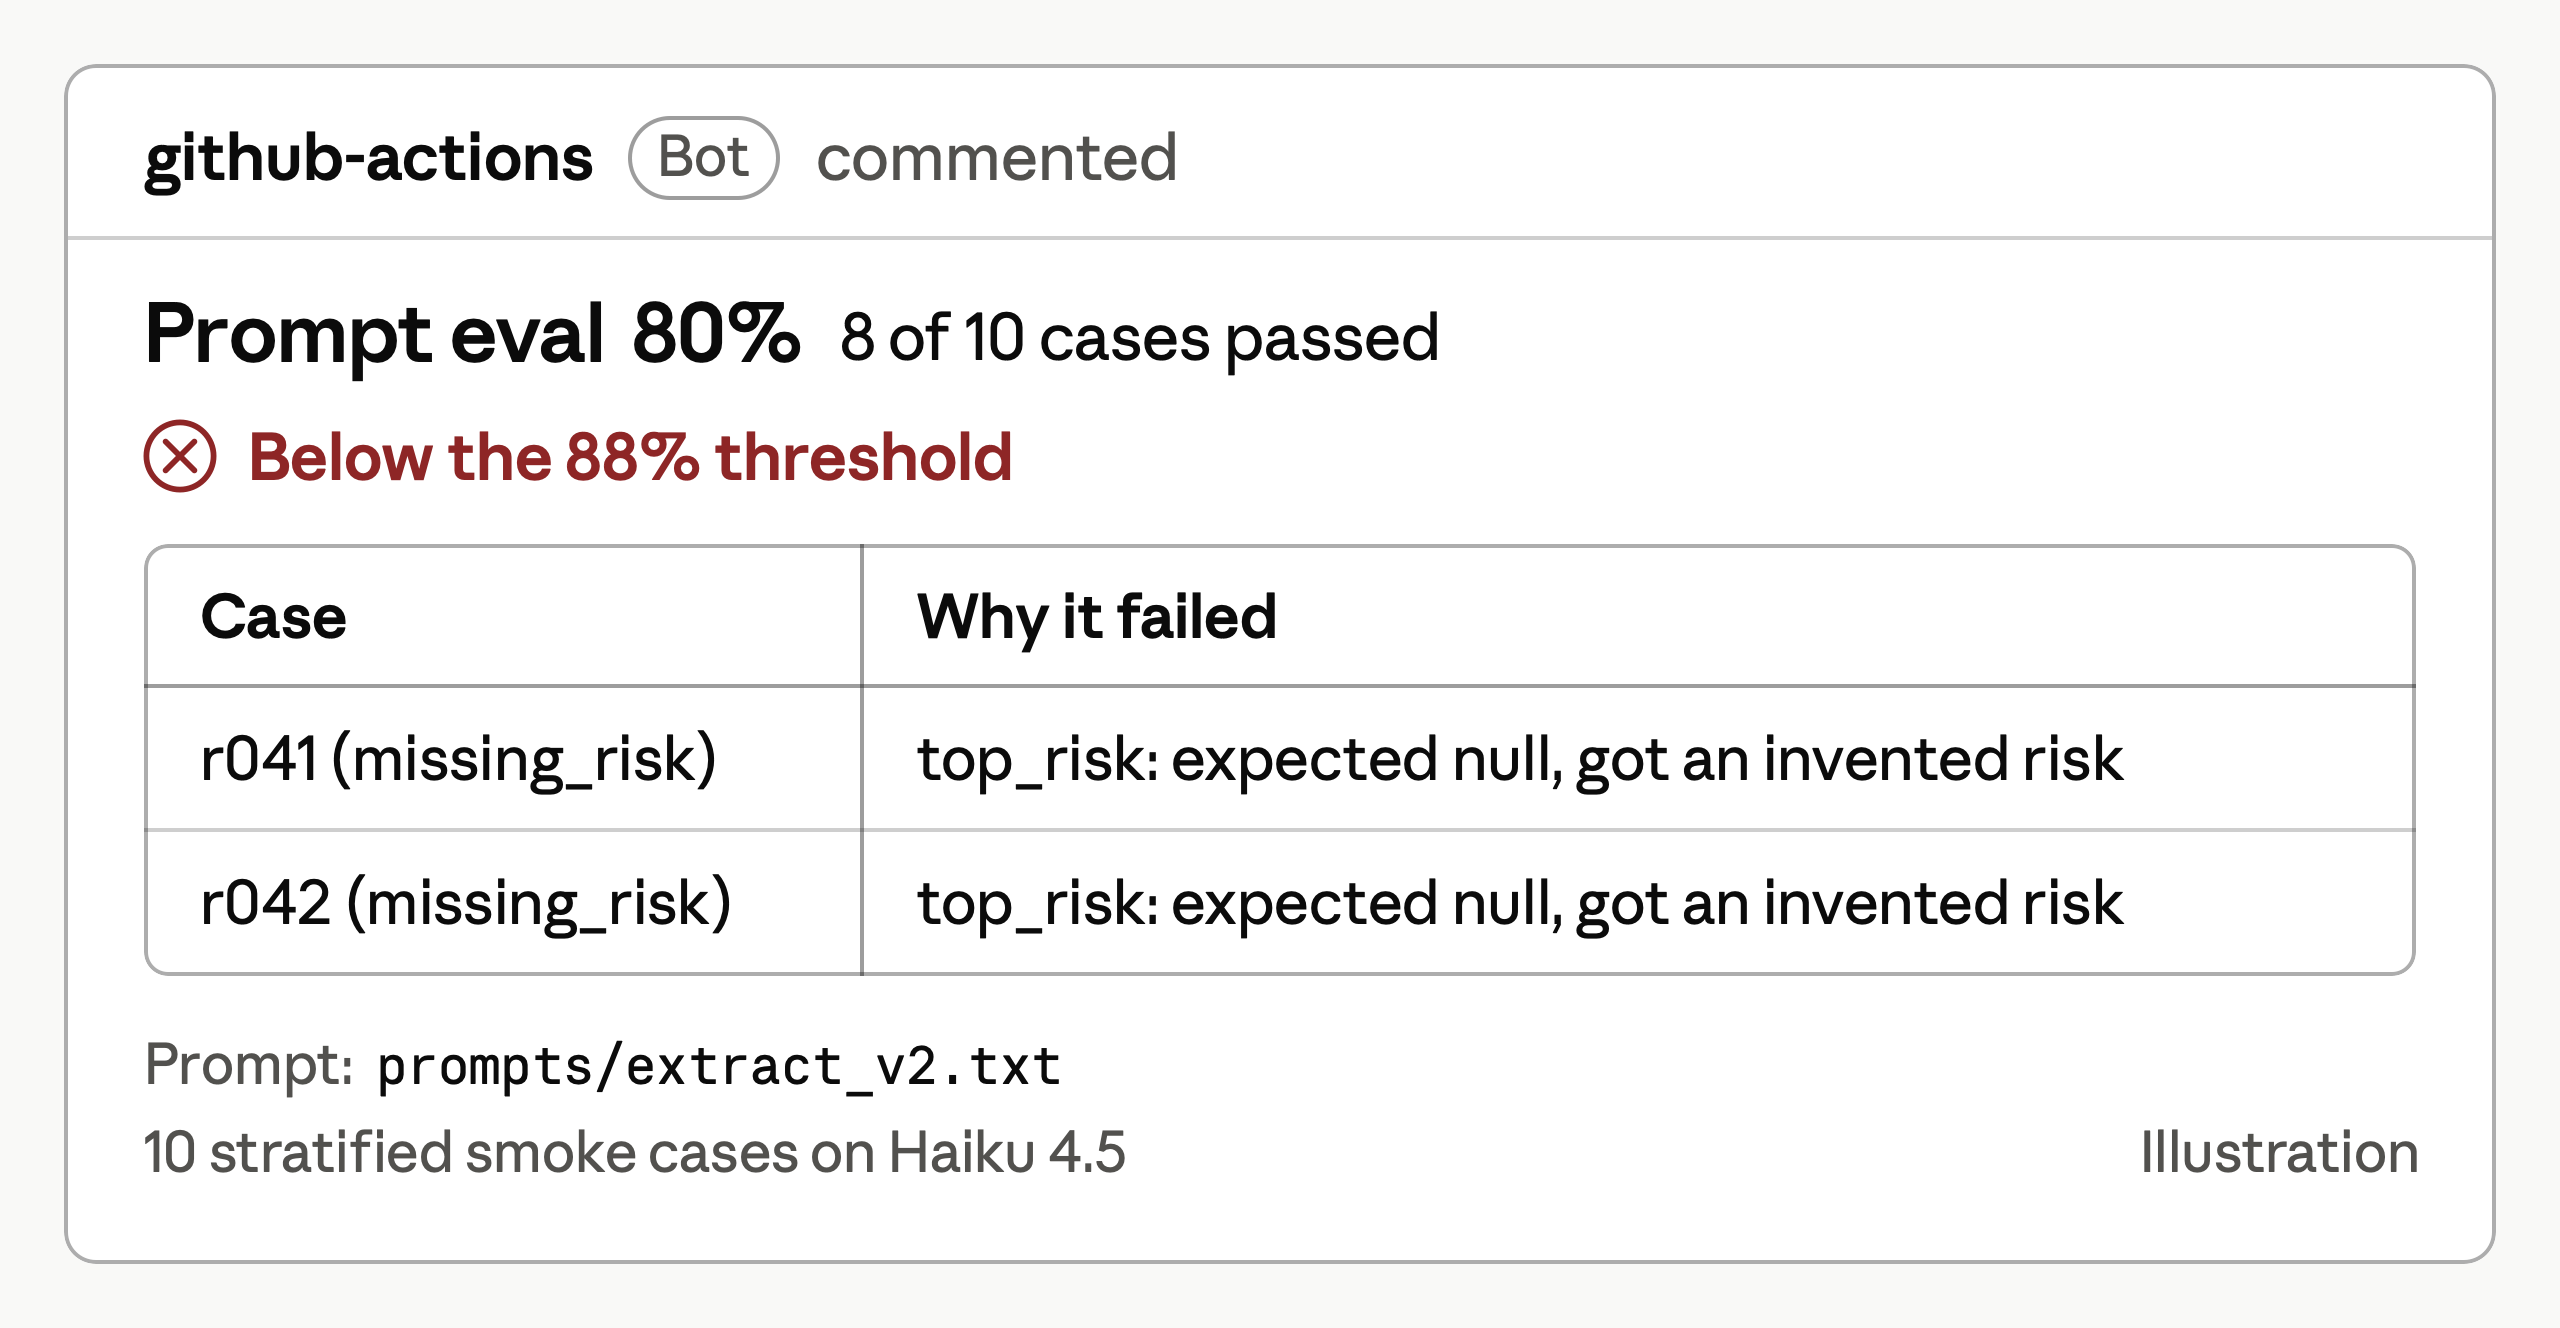
Der Smoke-Eval erreicht 80 % und verfehlt den Schwellenwert von 88 %, weil Claude in zwei Fällen mit fehlendem Risiko ein Risiko nannte, das der Bericht nie angibt.
Der rote Check hält den Merge-Button grau, und sein Kommentar zeigt dem Ingenieur, welche Fälle kaputtgegangen sind: r041 und r042. Sobald der Prompt korrigiert und gepusht ist, wird der Check grün, und der Merge kann stattfinden, sodass kein Kunde jemals den fehlerhaften Prompt gesehen hat.
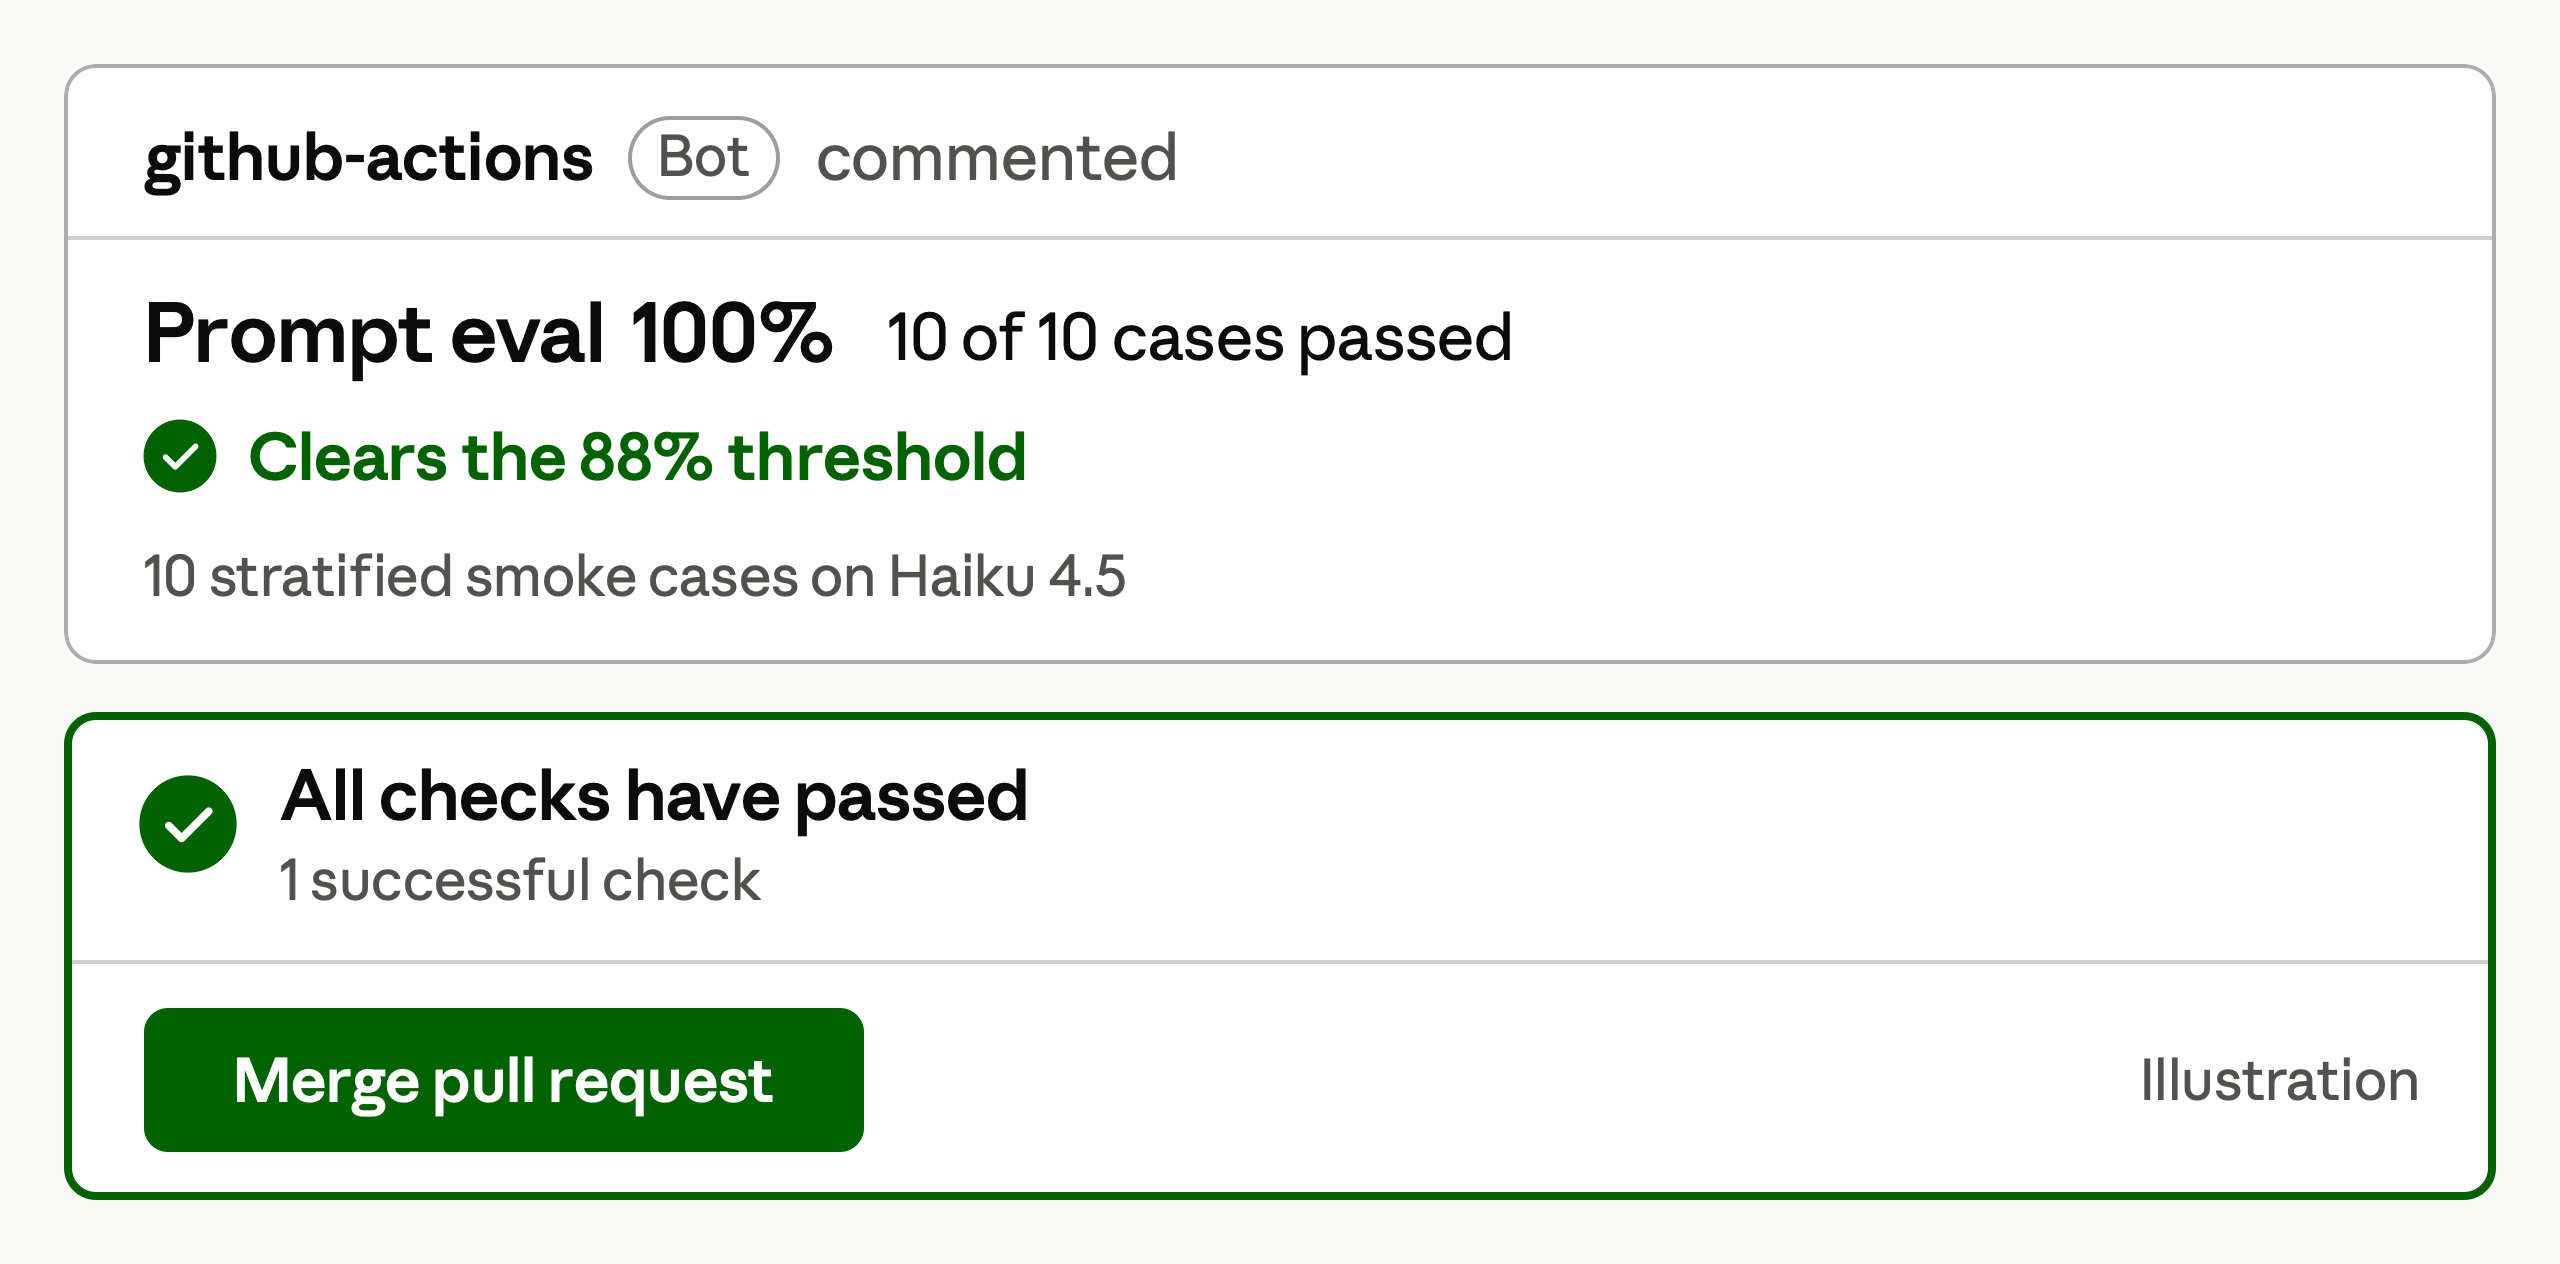
Nach der Korrektur besteht jeder Fall mit 100 %, sodass der Merge nicht mehr blockiert ist.
Führe die vollständige Suite als einen Batch aus
Führe die vollständige Suite immer dann aus, wenn du den Prompt oder das Modell änderst(öffnet in neuem Tab), und schicke sie durch die Batch API(öffnet in neuem Tab). Meridians Eval vergleicht Haiku 4.5, Claude Sonnet 5 und Claude Opus 5, daher enthält sein Batch 150 Anfragen, alle 50 Fälle für jedes Modell. Die Batch API führt sie alle für die Hälfte des üblichen Preises für Input- und Output-Tokens(öffnet in neuem Tab) aus, und du holst die Antworten später ab, normalerweise innerhalb einer Stunde(öffnet in neuem Tab).
| Modell | Standardpreis | Batch-API-Preis |
|---|---|---|
| Haiku 4.5 | 0,0468 $ | 0,0234 $ |
| Sonnet 5 | 0,1301 $ | 0,0650 $ |
| Opus 5 | 0,3432 $ | 0,1716 $ |
Standard- und Batch-API-Preise für einen Durchlauf durch Meridians 50 Fälle auf jedem Modell, Stand August 2026. Aktuelle Preise(öffnet in neuem Tab).
Fasse die Anfragen, auf die niemand wartet, zu Batches zusammen, und nutze Standardanfragen dort, wo jemand wartet(öffnet in neuem Tab). Nur der Smoke-Eval, auf den ein Merge wartet, bleibt bei client.messages.create(...).
Das Eval-Skript braucht zwei Änderungen.
Versieh jede Anfrage mit einer custom_id. Ergebnisse können in beliebiger Reihenfolge eintreffen(öffnet in neuem Tab), daher ordnest du sie anhand dieser Kennung zu, und sie muss innerhalb des Batches eindeutig sein. Jeder Fall geht an drei Modelle, also verbinde die Fall-ID mit dem Modell, etwa r041_claude-haiku-4-5.
batch = client.messages.batches.create(
    requests=[
        {
            "custom_id": f"{case['id']}_{model}",
            "params": {
                "model": model,
                "max_tokens": 1024,
                "messages": [{"role": "user", "content": case["prompt"]}],
            },
        }
        for model in MODELS
        for case in CASES
    ]
)
Lies request_counts, bevor du bewertest. Es zählt, wie viele Anfragen auf welche Weise abgeschlossen wurden, was zeigt, wenn ein Lauf unvollständig zurückkam. Ein Batch, der nicht innerhalb von 24 Stunden abgeschlossen ist, läuft ab(öffnet in neuem Tab), und eine abgelaufene Anfrage kostet nichts, hat aber keine Antwort(öffnet in neuem Tab).
batch = client.messages.batches.retrieve(batch.id)
print(batch.request_counts)

answers = {}
for result in client.messages.batches.results(batch.id):
    if result.result.type == "succeeded":
        answers[result.custom_id] = result.result.message
Bewerte jede Nacht eine Stichprobe des Live-Traffics
Bewerte jede Nacht eine kleine Stichprobe des Live-Traffics, also der echten Anfragen, die deine App verarbeitet. Die vollständige Suite kennt nur die Berichte, die du beim Aufbau hattest, also bleibt deine CI grün, während die Antworten schlechter werden, wenn ein neuer Kunde anfängt, Berichte in einem Format zu senden, das keiner deiner Fälle abdeckt. Dieser langsame Genauigkeitsverlust ist Drift.
So geht's:
- Stichprobe ziehen. Wähle zwischen 1 und 5 % des Live-Traffics aus.
- Bewerte die Stichprobe mit einem LLM-Judge(öffnet in neuem Tab). Das ist ein zweites Modell, das jede Antwort anhand einer Rubrik aus schriftlichen Regeln bewertet, nur unter Verwendung des Berichts, Claudes Antwort und der Rubrik, sodass es keine erwarteten Antworten braucht, die dem Live-Traffic fehlen. Trotzdem solltest du ab und zu selbst ein paar Antworten lesen(öffnet in neuem Tab), denn auch ein Judge muss von einem Menschen überprüft werden.
- Schlage nur bei einem echten Einbruch Alarm. Das ist ein nächtlicher Wert, der mehr als zwei Standardabweichungen unter der nachlaufenden Baseline liegt, dem Durchschnitt der letzten Nächte. Zwei Standardabweichungen sind eine größere Veränderung, als eine normale Nacht mit sich bringt.
- Mache aus jeder Antwort, die der Judge als falsch markiert, einen Fall. Schreibe die erwartete Antwort dazu und füge den Fall dann zur vollständigen Suite hinzu, denn Fälle aus echten Fehlern(öffnet in neuem Tab) halten die Suite nah an der realen Nutzung.
Live-Traffic zeigt dir, was der vollständigen Suite entgeht, und jeder Fehler, den du hinzufügst, verkleinert diese Lücke. Betrachte die 1 bis 5 % und die zwei Standardabweichungen als Ausgangspunkte, die du für deinen eigenen Traffic anpassen solltest.
Fazit
- Lass bei jedem Pull Request einen Smoke-Eval laufen, und lass seinen Wert den Check bestehen oder fehlschlagen lassen.
- Mache diesen Check erforderlich, damit ein niedriger Wert den Merge wirklich stoppt.
- Führe die vollständige Suite als Batch aus, was nur halb so viel kostet, weil niemand darauf wartet.
- Bewerte jede Nacht eine Stichprobe des Live-Traffics, schlage Alarm, wenn der Wert stärker als üblich fällt, und mach aus jedem Fehler einen neuen Fall in der vollständigen Suite.