对许多人来说,学习使用AI是从学习工具本身开始的。人们通常会从这样的问题开始:我该如何向Claude描述我的需求?我该如何安全地把Claude完成工作所需的文件和数据提供给它? 但随着Claude被用于更大、更复杂的任务,一个更难的问题浮现出来:我怎么知道Claude是对的?
辨别力,即AI输出结果的准确性和相关性,是AI流畅度中最关键的方面之一。然而,由于它可能发生在AI工具的范围之外,因此更难以直接研究。
因此,借助Anthropic Interviewer(在新标签页中打开)的帮助,我们询问了129名Claude Academy参与者:当您与Claude合作时,辨别力是什么样的? 人们分享了他们最近与Claude合作完成的工作的故事,包括他们如何核实Claude的质量和准确性。1
我们学到了很多,但出现了三大主题。首先,"检查Claude的工作成果"最常意味着与对话之外的某些事物进行核实——来源、文档、测试、其他人,或另一个AI。其次,辨别力的最大障碍不是时间压力,而是缺乏领域专业知识。第三,当Claude的错误被发现得太晚时,往往会促使人们采用新的、富有创意的辨别行为。
这些故事帮助我们了解高级用户所养成的习惯,从而让我们能够构建自己的辨别力工具包。本研究中的大多数受访者每天使用Claude,且使用时间达六个月或更长。2 这远高于普通人群的水平,这对于整理良好实践很有用,但对其他方面则是一种局限。除此样本之外,我们不做任何普遍性声明。
关键洞察
在所有访谈中,我们发现了三个显著的模式:
- 检查Claude的输出结果通常涉及与外部来源进行验证
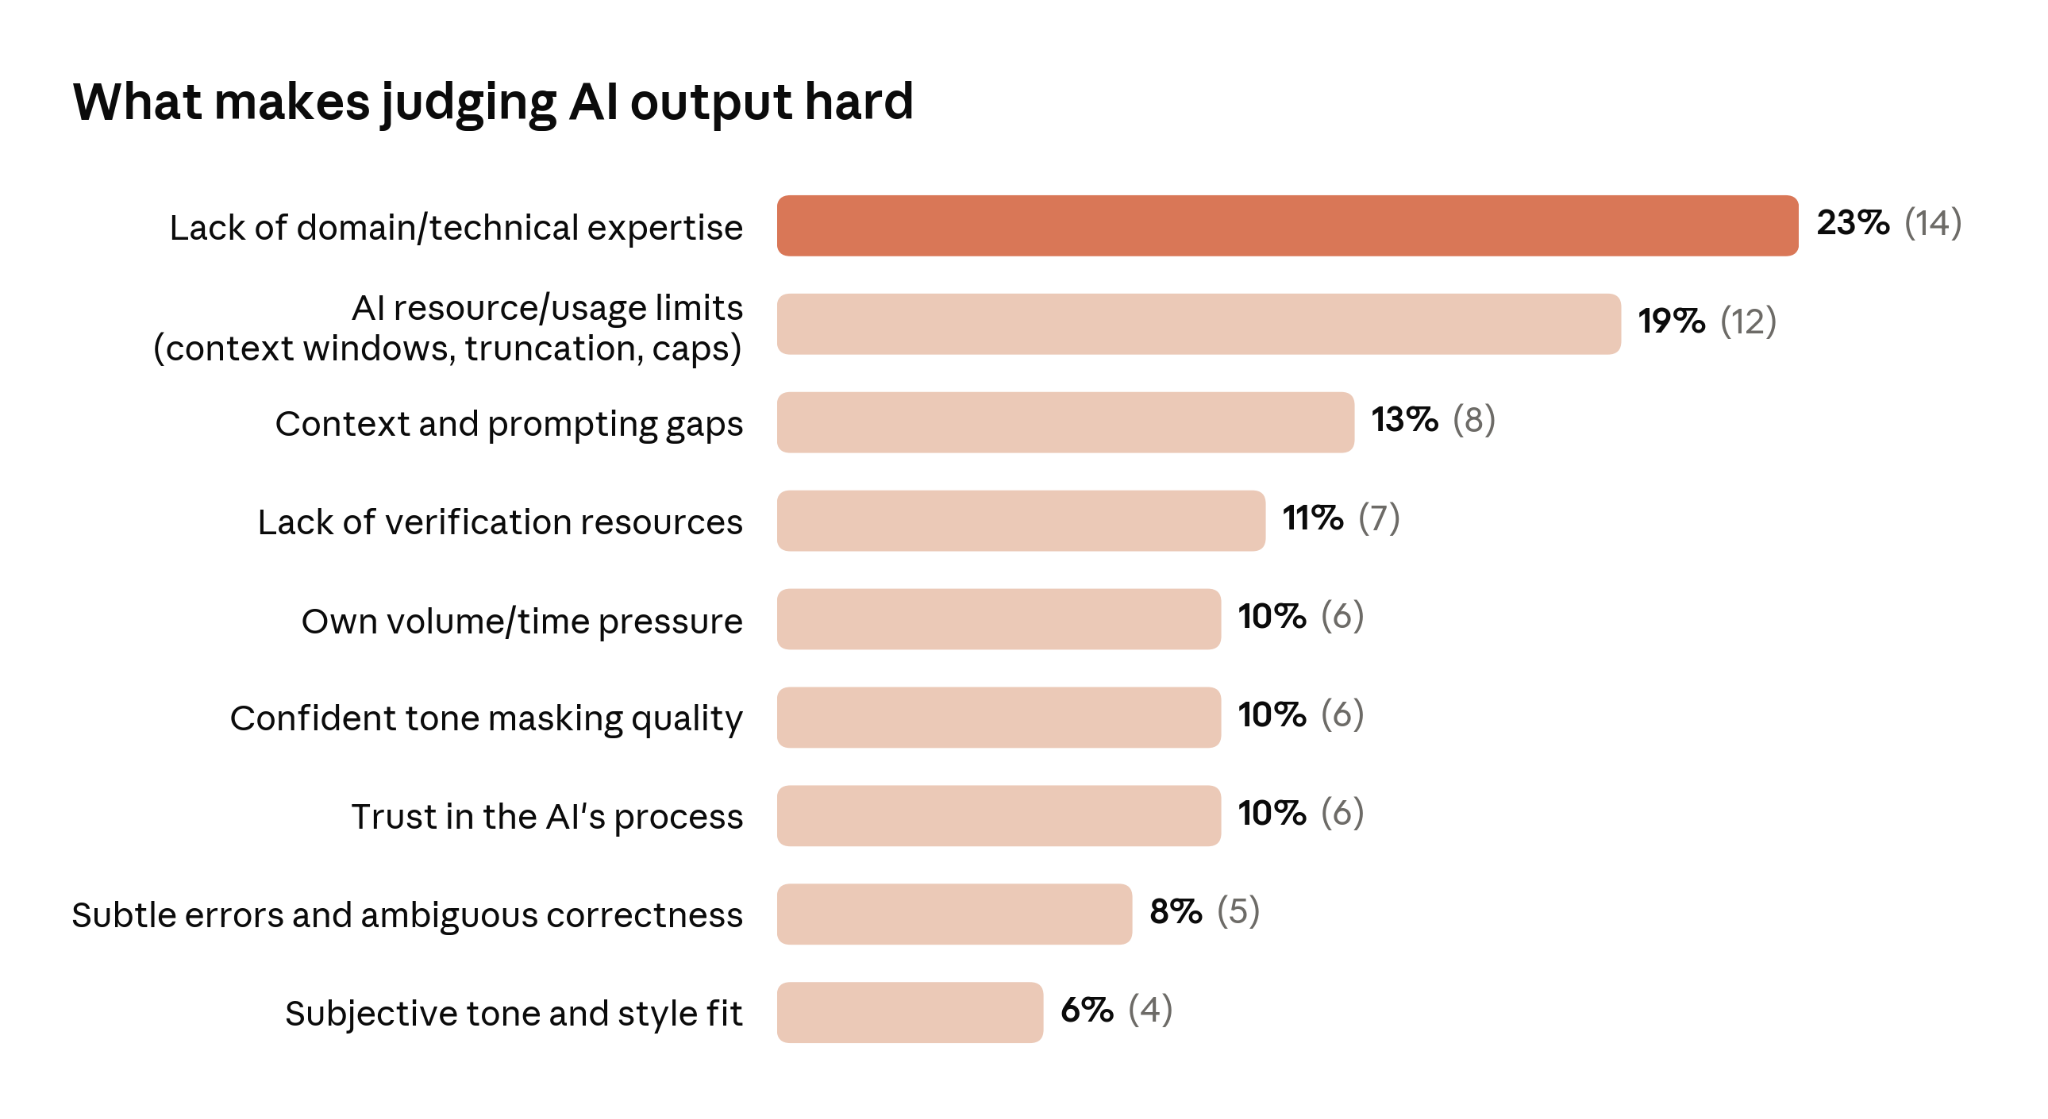
- 专业知识是辨别力的最大障碍
- 未被发现的错误可能促使人们采用富有创意的新辨别行为
将Claude的工作成果与外部真实来源进行核对,是最常被提及的辨别实践
我们原本预期"检查Claude的工作成果"大多会被描述为通读一遍以发现明显的错误。然而,我们访谈的参与者中有51%描述了将Claude的输出与外部事物进行核实:源文档、官方文档、他们自己的数据、另一个人,甚至另一个AI。10%的核查者更进一步,将多个独立的核查方法结合起来使用。没有任何外部验证的通读是少数做法,尤其是在任务具有技术性的情况下。
"外部真实来源"的含义取决于具体工作。当任务涉及代码时,通常会用到测试。研究和分析类任务则依赖于与来源的交叉核对以及第二方意见。有10份记录描述了在细致的知识型工作任务中使用第二个AI来检查第一个AI的工作成果。写作类任务则依赖领域知识,以及同行仔细阅读以判断是否合适。不同的工作需要不同的方法。
专业知识是辨别力的最大障碍
AI使人们能够拓展自己的能力范围,这意味着他们经常在从事超出自身直接专业领域的工作。正是在这种情况下,这些参与者发现辨别变得具有挑战性:当您不确定好的答案应该是什么样子时,很难判断一个答案的好坏。
有62名参与者指出了辨别力方面的障碍。缺乏专业领域知识位居榜首。一些非技术类参与者描述了Claude引导他们完成涉及软件开发的解决方案,而他们无法区分好的代码或架构决策与糟糕的决策。一位学习者甚至转向在线园艺视频,以积累足够的领域知识来评估Claude的建议。
我们原本预期时间压力会位居榜首。但对这一群体而言,瓶颈在于是否具备足够的专业领域知识来评估输出结果的质量。
让错误溜过去改变了人们的工作方式
在所有访谈中,共有18份有意义的记录描述了未能发现Claude所犯的错误。分享此类故事的人中,有一半也告诉我们,这改变了他们如今的工作方式。看到这个错误教会了他们如何留意未来可能出现的错误。
这些参与者所采用的一些新做法包括:
- 要求Claude在提供建议或分析之前,先引用其来源文本
- 在多步骤任务的每一步都设置审批关卡,而不是只在最后进行审查
- 同时使用多个AI代理:一个负责生成工作成果,其他的负责检查其中不同的部分
对这些参与者而言,他们并没有"更努力地检查工作成果",也没有在一夜之间成为新领域的专家。相反,他们重新调整了自己的工作流程,并完善了自己的辨别力工具包。
构建您的辨别力工具包
本研究中最自信的辨别者有一个共同点:拥有一套良好的工具包。当您开始将AI用于更困难、更复杂的任务时,我们强烈建议您确定一套可用于验证Claude工作成果的实践和工作流程。以下是五种可供您入门的工具。
- 构建测试,以验证您最常创建的工作成果。 如果您不是软件开发人员,您可能没有为自己所做的每项工作设置"测试"。但这个理念可以迁移到任何领域。如果您是内容撰稿人,可以为语气、风格和格式创建评分标准。如果您是律师,可以定义用于检查生成的合同语言的政策和规则。尝试使用以下提示与Claude进行迭代,创建您自己的验证"测试",将其作为可与同事共享的可复用技能:
我想为我所生产的一类工作成果制作一个可复用的检查工具,以便在成果发出之前发现问题。可以把它看作是我自己的QA检查清单。
在您开始撰写任何内容之前,请一次性向我提出四到五个简短的问题:这项工作成果是什么,谁会阅读它;一个优秀版本会做到哪些一个尚可版本做不到的事;这些工作通常会在哪些方面出错,包括我收到的反馈或我后来才发现的错误;以及我最不希望出错的地方是什么。如果我给您一个好的范例,请在起草之前先阅读它。
然后将我的回答转化为一份包含五到八个问题的检查清单,我可以用它来检查未来的任何草稿,无论是我写的、您写的,还是我们共同写的。把最重要的问题放在最前面。让每个问题都针对我的具体工作,而不是泛泛的写作建议,并确保这份检查清单能帮助我发现错误的事实或数字、经不起质疑的推理或论断、读者需要但页面上没有的背景信息,以及不适合这个受众的语气。不要添加我没有给您的数字、阈值或规则。
请以技能的形式交付这份检查清单,而不是作为聊天中的文本。该技能应能接受以粘贴文本、文件或文档链接形式提供的草稿,按顺序运行每个问题,并引用草稿中决定每个问题答案的确切行。
该技能的输出应是一份以artifact形式发布的可视化评分卡,而不是文本报告:顶部是一个结论,指出最重要的单一修复项;一行概览条,一目了然地显示每个问题的状态(通过、未通过、已标记);然后每个问题占一行,显示状态、引用的行,以及一个具体的修复建议。运行后的聊天回复应为两行:结论和统计数字。先向我展示该技能以供审查,然后在我的范例上运行一次,以便我查看评分卡。
- 在您离开聊天之前,让Claude帮助您识别辨别的机会。 Anthropic发布了一项辨别力技能,该技能能够检测复杂任务,并提示Claude提供进一步验证的提醒。在与几家企业测试该技能后,方向性证据表明,在工作流程中插入停顿能够提升辨别力。以下是一个示例,展示了用户要求生成一份关于费城市工人的报告后,该技能在聊天中添加的内容:
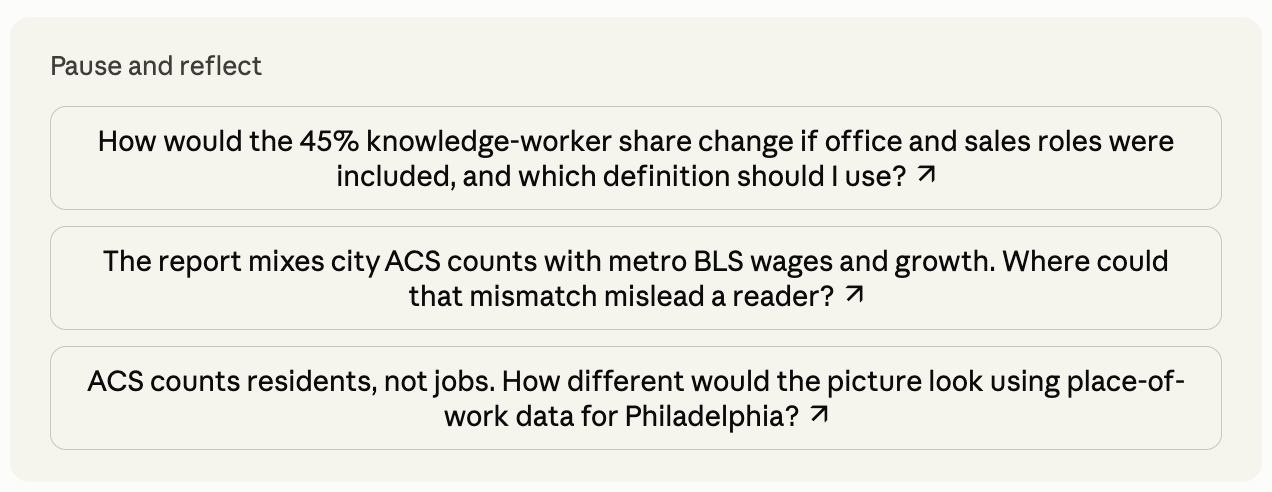
(辨别力提醒技能在完成一份关于费城市工人的报告后触发的示例)
您可以通过在此处询问Claude来安装辨别力提醒技能:
- 在Claude Code中使用对抗性审查。 Claude Code提供了内置的对抗性审查(在新标签页中打开)步骤。这意味着Claude能够启动一个全新的子代理,从新的角度审查您的代码或工作成果。使用一个未参与构建输出结果的代理,意味着更有可能发现错误或危险的假设。
使用一个子代理,将速率限制器的diff与PLAN.md进行对照审查。检查每项需求是否都已实现、列出的边缘情况是否都有测试,以及是否有超出任务范围的改动。报告差距,而不是风格偏好。
- 建立一个专家小组。 辨别力方面被提及最多的障碍,是缺乏对当前主题的专业知识。确定可以请求进行二次核查的人员,能够拓展您的选择。了解在您专业领域之外,您会找谁来进行二次审阅,并在成果发出之前主动联系他们。当然,也要记得回报这份帮助。当同事带着您专业领域内的内容来找您时,您花的那五分钟正是让他们的辨别成为可能的关键。
尝试使用以下提示与Claude进行迭代,根据您最近的邮件往来,找出谁可能帮助您辨别您的输出结果:
我想设置一个"求助朋友"式的检查。在我依赖某项工作成果之前,您将帮助我在自己的人际网络中找到合适的人来判断它。请一步一步地引导我完成这个过程,并在我回答之后再继续下一步。
第一步:检查我的邮箱是否已连接。如果没有连接,请给我逐步的连接说明,然后等我告诉您已完成后再继续。不要猜测姓名。
第二步:向我询问这项工作成果。我可以上传它、粘贴文本,或粘贴指向它的链接。如果我说它来自我们之前的某次聊天,请在我过去的聊天记录中搜索它;如果找不到,请告诉我如何在设置中开启"搜索并引用聊天记录",或者让我直接粘贴给您。
第三步:用一句话告诉我这项工作成果是关于什么的,以及判断它好坏需要哪种专业知识。
第四步:在我的邮箱中搜索具备该专业知识的人:与我就此话题有过往来的人、被抄送相关邮件的人、曾回答过我关于此话题问题的人,或是该成果所服务决策的负责人。
第五步:建议2到4个人。对每个人,根据您在我邮箱中找到的信息给出一句话的理由,并提供一条我可以发送给他们、请他们查看该成果的简短消息。
优先选择那些了解该主题、并会提出质疑的人,而不是我只是经常发邮件联系的人。不要代我联系任何人,也不要在建议的消息中引用我的邮件内容;我会自己联系他们。
- 请Claude提供来源依据。 将Claude的工作成果与外部来源进行核对,是一种常用的做法。您可以让Claude为回答中的每个论断引用来源,从而让这项工作对您来说更轻松。有了这些来源,您就可以快速检查哪些内容经得起核实,哪些可能需要您进一步研究。
在您与Claude生成输出结果后,在对话中尝试使用以下提示:
对于您回答中的每一个事实性论断,请告诉我它的来源。引用来源中的确切段落,并附上链接或页码。如果某个论断来自您的通用知识,请将其标注为"无来源",以便我知道应优先检查哪些内容。
局限性
这些洞察存在一些重要的注意事项:
- 样本局限性: Academy的注册者是自我选择、有动力的参与者,他们主动选择提升与AI协作的能力;他们的实践水平可能高于普通人群的基准水平。该样本(129份访谈,94份完整完成)偏向经验丰富且技术性较强的群体,因此新用户的辨别力挑战在样本中代表性不足。这些记录应被理解为该人群中实践做法的一份目录,而非普遍性的基准,我们不对AI用户整体做出任何普遍性声明。
- 自我报告: 所有数据均为自我报告。我们优先采用"请带我走一遍"式的真实工作记录,并将结构化评分作为描述性背景信息处理。对"某次出现疏漏"的回忆容易受到可得性偏差的影响:戏剧性的失误很可能比那些容易被遗忘的失误更容易被过度呈现。
- 编码局限性: 主题编码由LLM辅助完成。我们通过以下方式缓解这一局限:保留每个主题对应的确切转录记录清单以供审计、对结构化模块进行确定性(基于规则)的交叉验证、对每个主题至少10%的内容进行人工审查,以及在评分标准修订后对每个受影响的维度进行全面重新编码。
展望未来
本研究捕捉了有动力的高级用户关于如何检查Claude工作成果的故事和主题。我们的目的是拓展我们对辨别力如何发展、以及哪些策略在实践中行之有效的理解。
在未来的工作中,我们计划通过干预性研究来拓展这项研究,衡量辨别力技能对组织的影响,并将"为您的领域构建测试"这一理念发展成一个共享的、按角色划分的检查库,供所有人采用并贡献内容。
我们预计,随着模型产出的结果日益精致,辨别力也将随之演变。通过本研究及未来的研究,我们希望让这种演变变得可见,并为每个人提供可用的教育工具。
Bibtex
如果您想引用这篇文章,可以使用以下Bibtex键:
@online{swanson2026aidiscernment,
author = {Kristen Swanson and Maggie Vo and Zoe Ludwig and Jeff Olson and Matt Gallivan and Erik Olesund and Rick Dakan and Joe Feller},
title = {Anthropic Education Report: How people check Claude's work},
date = {2026-09-10},
year = {2026},
url = {https://academy.claude.com/tutorials/discernment-toolkit},
}
致谢
Kristen Swanson设计了本研究,主导了分析工作,并在Matt Gallivan、Jeff Olson和Erik Olesund的反馈下撰写了本报告。Maggie Vo和Zoe Ludwig为框架对齐、信息传达和审阅做出了贡献。AI流畅度的4D框架由Rick Dakan和Joe Feller与Anthropic合作开发。Mo Julapalli和Ankit Siva提供了技术支持。Ryan Donegan和Molly Vorwerck提供了传播方面的审阅和指导。
脚注
- 在研究人们如何描述其AI使用情况时,保护参与者隐私至关重要。访谈由Anthropic Interviewer(在新标签页中打开)进行,这是一款由Claude驱动的定性访谈工具,遵循其标准的同意流程;回答内容未与用户的Claude Academy账户、课程进度或Claude.ai对话数据相关联。本分析中不包含任何个人身份信息。在调研期间,所有在Claude Academy注册AI流畅度课程的人,都在其注册邮件中收到了一份说明,提供了一次可选的研究对话机会。参与是无偿的,且与课程注册无关。在129名开始访谈的参与者中,94人完整完成了访谈,包括调查问卷模块。由于部分完成的访谈中也经常包含有意义的工作故事,因此开放式记录的分析基于全部129份转录记录,而调查数据则基于完成调查问卷的子集(根据具体题目,n=95至98)。主题编码的流程如下:一个LLM根据研究问题对全部语料进行编码,并保留每个主题背后确切的转录记录清单以供审计。调查问卷模块则以确定性方式进行解析。随后,一名人工评估员对每个主题至少10%的内容进行了审查,以识别编码中的不一致之处。编码标准根据该审查结果进行了修订,并对每个受影响的维度依据修订后的标准进行了全面重新编码。所有新编码的数据集再次由人工进行审查和分析。本文完全由人工撰写,并在AI的协助下进行了修订。
- 根据调查问卷模块(n=95):95名受访者中有63人报告每天使用,62人报告使用AI工具的经验达六个月或以上。受访者自评信心最高的方面是知道何时需要核实(5分制下平均分为3.9),最低的方面是判断完整性(3.5),判断正确性则居中(3.7)。这与关于辨别力障碍的研究结果一致:参与者普遍知道需要进行核实,而困难之处在于在自身专业领域之外进行核实。