使用 Claude Code 的开发者最终都会遇到成本或用量限制。尽管如此,开发者仍希望在模型智能的前沿开展工作,因此往往默认选择可用的最强大模型。
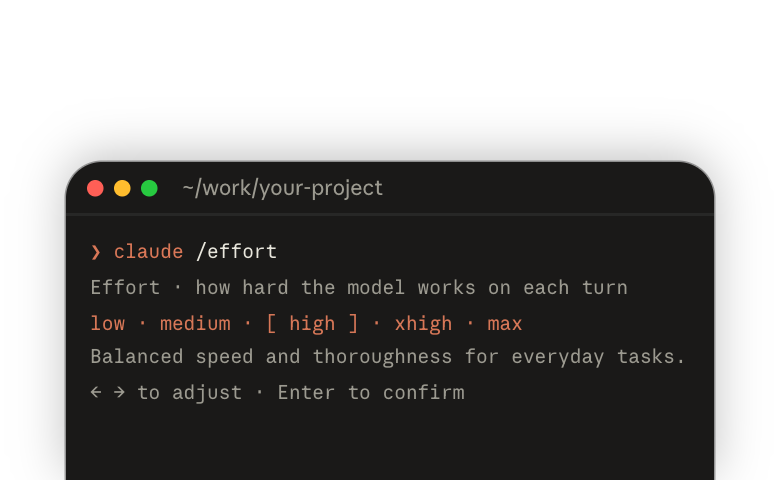
无论您使用哪种模型,努力程度级别都是控制成本和令牌用量的另一个重要旋钮。请将努力程度与任务的复杂度相匹配;无论偏向哪个方向,不匹配都会带来成本。
努力程度不会改变模型所知道的内容
努力程度告诉您的模型应在提示中的任务上花费多少资源。如果您将努力程度设置为最低级别,模型会尝试以尽可能少的资源实现提示的目标:更少的工具调用、更少的令牌,以及更少的整体工作量。如果您将努力程度设置为最高级别,则是在向模型发出信号,表明它可以也应该使用完成提示目标所需的尽可能多的资源。
努力程度设定的是模型工作的努力程度,而不是它所知道的内容。您选择的模型决定了您所使用的能力水平。努力程度则是您希望该模型付出多大努力的信号。
何时调整努力程度
当任务的努力程度设置过低时,模型很可能会提前停止,带着未完成的工作返回给您。这表明您所要求的内容比您所允许的努力程度更复杂。随后您必须弄清楚它停在了哪里,并再次提示让它继续。最终,这可能比一开始就正确设置努力程度级别花费更多成本。
当努力程度设置过高时,您可能不会在每个提示或每个任务上都注意到:模型会使用超出必要的令牌,响应时间会更长,并且您会注意到一种过度思考的模式,或者模型识别出的任务比您实际分配的更多。您发出的信号是"我向你描述的内容确实非常复杂和困难",而模型会匹配这一信号,将工作视为同样复杂。
默认设置位于中间位置,这并非随意而定:它针对每个模型进行了调优,使大多数任务能够在不过度消耗资源的情况下完成。这就是为什么它是正确的起点。
对于您知道很简单、不应需要大量资源(时间、轮次、工具调用或文档读取)的任务,您可以调低努力程度。如果您已经在默认级别运行过这类任务,可以尝试降低一个级别运行,看看质量上是否有任何差异。如果没有差异,就继续每次降低一个级别,直到出现差异为止。
当您知道自己描述的内容应该需要很长时间,并且需要大量轮次和反复核查时,就应该从默认级别向上调整。另一种需要调高努力程度的情况是:任务是您自己无法快速核查的内容,而您希望模型在工作过程中进行更多自我核查。同样的规则适用于这个方向:每次调高一个级别,重新运行,当它开始完成您认为应该完成的事情时就停止。
该调整哪个旋钮:努力程度还是模型?
只有在提高努力程度仍无法解决问题时,才更换模型。是模型知道的不够多,还是它没有足够努力?如果它知道的足够多但没有足够努力,那就调整努力程度。如果它知道的足够多但工作过于努力,这同样是努力程度的问题。如果调整努力程度无法解决问题,并且您使用的不是最强大的模型,那就表明您所选择的模型对该任务而言知识不足,或能力不够。
更换模型时,请重新从默认级别开始
每个模型上的级别名称都是相同的,但相同的级别在不同模型上并不意味着相同的工作量。
每当您选择一个模型时,请从默认级别开始设置努力程度,并根据需要向上或向下调整。假设您用可用的能力最弱的模型尝试一项困难任务,看看它能否以更低成本完成工作。在您将努力程度调到尽可能高之后,模型仍未能达到您所需的质量水平,于是您换用更强大的模型。此时不要将努力程度保留在最高级别;请重新从默认级别开始尝试。更强大的模型可能仍然能够以更低的努力程度完成任务。
每当有新模型发布时,包括您已在使用的模型的更新版本,都请重新审视您一直在执行的任务。看看您是否能用更强大的模型以更低的努力程度获得相同的结果,这可能会让这些任务的成本更低。
设置努力程度级别
您可以通过以下任意方式更改努力程度:
仅限本次会话:
--effort标志: 在启动 Claude Code 时传入级别名称
适用于本次及未来会话:
/effort: 不带参数运行/effort可打开交互式滑块,在/effort后跟级别名称可直接设置,或使用/effort auto重置为模型默认值- 在
/model中: 在选择模型时,使用左右方向键调整努力程度滑块 - 设置: 在设置文件中将
effortLevel设为low、medium、high或xhigh - 环境变量: 将
CLAUDE_CODE_EFFORT_LEVEL设为某个级别名称或auto
适用于单个技能或子代理:
- 技能和子代理的前置元数据: 在技能或子代理的 markdown 文件中设置
effort,以在其运行期间覆盖努力程度级别
通过 /effort 设置的级别会延续到您的下一次会话,因此如果您只想在一次运行中使用某个级别,请使用 --effort 标志。最高级别会消耗足够多的资源,以至于 Claude Code 会将其设为仅限本次会话,除非您通过环境变量进行设置,这样您就不会意外地一直保持该级别。
Ultracode 并不是一个努力程度级别。它是一项仅限本次会话的 Claude Code 设置,会以 xhigh 运行模型,并且对于实质性任务,还会让 Claude 编排动态工作流(在新标签页中打开),将工作分派给多个代理。
当有多种方式同时设置努力程度时,以下顺序中最靠前的方式优先生效。
无论上述哪种方式生效,您所在的组织都可能对其设置上限。在企业版方案中,管理员可以为每个模型设置最高努力程度级别(在新标签页中打开)。超过上限的级别不会出现在 /effort 选择器中,如果您通过 /effort 或 --effort 请求某个超限级别,Claude Code 会以上限级别运行,并告知您这一情况。
实例演示
同一个提示在同一个模型上运行三次,分别使用低、默认和最高努力程度:播放每个级别,观察为达到相同结果投入了多少工作量。该提示要求编写一个小型的 CSV 转 JSON 脚本,并在示例文件上进行测试,内容刻意设计得很简单,以便各努力程度级别之间能够体现出差异。
在您自己的环境中尝试
三个独立的会话。在每个会话中执行相同的四个步骤。您需要自行整理对比结果,因为 /usage 只会报告您当前所在的会话。请在每次运行结束时查看该命令,记下它为该会话报告的令牌数,然后退出并重新开始下一次运行。
1. 在一个全新的空文件夹中,以该次运行的级别启动一个新会话
# 从任意仓库之外的空文件夹
# 运行 1 · 低
mkdir effort-low && cd effort-low && claude --effort low

# 运行 2 · 默认
cd .. && mkdir effort-default && cd effort-default && claude
# 然后运行 /effort auto

# 运行 3 · 最高
cd .. && mkdir effort-max && cd effort-max && claude --effort max
该标志(或 /effort auto)可确保每次运行都以各自的级别启动,因为一旦通过 /effort 设置了 low 到 xhigh 中的某个级别,它就会延续到您的下一次会话。
2. 粘贴相同的提示
编写一个将 CSV 文件转换为 JSON 的脚本。将其保存为此文件夹中的 csv_to_json.py。在以下 CSV 上进行测试,并将其保存为 sample.csv:
name,team,start_date
Priya,Payments,2024-03-18
Marcus,Platform,2023-11-02
Lena,Support,2025-01-273. 当 Claude 将工作交还给您时,检查本次会话使用了多少资源
/usage查找该会话的令牌总数;屏幕上的其余内容会因方案而异。
4. 退出,然后返回第 1 步进行下一个级别
/exit这三个令牌数应从低到最高逐步攀升,并且三个文件夹中都应包含一个可正常工作的转换器。将这三个脚本并排打开:构建内容的多少差异,就是您所付出成本的差异。
需要保持的习惯
管理努力程度归结为一个习惯:从默认级别开始,观察返回的结果,每次调整一个级别。保持这个循环运转,您就会知道某项任务需要什么级别,并能够向同事或管理员解释原因。
了解更多
- 在 Claude Code 中选择 Claude 模型和努力程度级别(在新标签页中打开):来自 Claude Code 团队,介绍模型选择和努力程度背后的概念。
- 模型配置(在新标签页中打开):关于
/effort、设置、优先级和组织限制的完整参考。 - 最大化 Claude Code 的价值(在新标签页中打开):来自 Claude Code 团队的录播网络研讨会,内容涉及会话的令牌都花在了哪里、如何选择合适的模型和努力程度级别,以及 CLAUDE.md 和 MCP 服务器为每一轮对话带来了什么。
- 针对成本和智能进行优化(在新标签页中打开):来自 Claude Platform 文档,针对努力程度、提示缓存和模型选择的实测结果,并按每项任务的成本进行比较。
- Claude API 上的成本优化(在新标签页中打开):来自 Claude Cookbook,面向 Platform 构建者,逐一将成本优化手段应用于一个可运行的代理。