Databricksコネクタは、Unity Catalogを通じて組織の内部データへのアクセスをClaudeに提供し、データベースの分析、カスタムビジネスロジックの実行、非構造化ドキュメントへのアクセスを可能にします。Databricksは3つの別々のコネクタを提供しています。1つは関数用、1つはベクトル検索用、1つはGenie用で、それぞれがDatabricksワークスペース内の異なる機能にアクセスします。
Databricksコンポーネントに関するリマインダー
ClaudeがDatabricksで何ができるかを確認する前に、Databricksワークスペース内に存在する3つのコアコンポーネントを理解することが重要です。
-
Unity Catalog関数: 特定の計算、データ変換、またはAPI統合のために組織が作成したカスタムPythonまたはSQL関数です。これには、独自のスコアリングアルゴリズム、正規化された財務計算、またはビジネス固有のデータ処理ロジックが含まれる場合があります。
-
ベクトル検索: 組織のドキュメントとデータセットに基づいて構築されたセマンティック検索インデックスです。これにより、正確なキーワードが一致しない場合でも、概念的に類似したコンテンツを検索できます。
-
Genie: 平易な英語の質問をデータに対するSQLクエリに変換する自然言語インターフェースです。Genieはテーブルと列に関するメタデータを使用して、ビジネス用語を理解し、適切なクエリを生成します。
このコネクタが提供するもの
統合機能
Databricks統合を通じて、Claudeはワークスペース内のリソースにアクセスできます。
-
カスタム関数の実行: Claudeは組織が定義したUnity Catalog関数を実行できます。これには、複雑なビジネスロジックの実行、計算の適用、またはチームが作成した関数を通じた外部APIの呼び出しが含まれます。例えば、組織が独自の顧客健全性スコア関数を構築している場合、Claudeは分析全体でそれを一貫して適用できます。
-
セマンティック検索: ベクトル検索インデックスを使用して、Claudeはキーワードだけでなく意味に基づいて関連するドキュメントやコンテンツを見つけることができます。これは、類似の概念が異なる方法で表現される可能性がある契約書、研究レポート、顧客フィードバック、または技術文書を検索する際に特に有用です。
-
自然言語クエリ: Genieを通じて、Claudeは平易な英語の質問をSQLクエリに変換できます。複雑なSQLを書く代わりに、「前四半期の収益成長はどうでしたか?」のような質問をすることができ、Claudeはそれを使用して適切なクエリを生成し実行します。
-
ガバナンスされたアクセス: コネクタを通じたすべてのデータアクセスは、組織のUnity Catalogの権限とポリシーを尊重します。Claudeは、ユーザーアカウントが使用する権限を持つデータと関数にのみアクセスできます。
ClaudeがDatabricksデータを使用する方法
Claudeは、包括的なデータ分析をサポートするために、いくつかの方法でDatabricksの機能を適用します。
-
マルチソース分析: Claudeはデータベースクエリ、ベクトル検索、カスタム関数からの結果を組み合わせて、包括的な洞察を提供します。例えば、投資仮説を検証する際、Claudeはポートフォリオデータベースから過去の財務パフォーマンスを照会し、類似セクターの投資に関する過去のデューデリジェンスレポートを検索し、独自のIRR計算関数を適用して期待リターンをモデル化することがあります。
-
反復的な探索: Claudeはデータを照会し、初期結果を分析し、発見に基づいて検索を改善できます。これにより、1つのクエリからの洞察が次のクエリに反映される分析が可能になります。
-
カスタムロジックの適用: Unity Catalog関数を実行することで、Claudeは組織固有のルールと計算を適用します。これにより、独自の指標、調整された計算、および会社固有のロジックがすべての分析で一貫して適用されることが保証されます。
-
コンテキストに応じたクエリ構築: 平易な英語で質問をすると、Claudeはそれを適切なSQLクエリに変換するためにGenieを使用します。この変換では、テーブル構造、列名、関係性を考慮して、データベース構造に一致する正確なクエリを生成します。
-
パターン認識: ベクトル検索を通じて、Claudeはドキュメントとデータ全体のパターンと類似性を見つけることができます。これは、従来のキーワード検索では明らかにならない可能性のある関連する問題、類似のトランザクション、または比較可能な状況を見つけるのに役立ちます。
Databricksコネクタの設定
Databricks統合は3つの別々のコネクタで構成されており、それぞれ個別の設定が必要です。
-
Functionsサーバー: 計算、ビジネスロジック、データ変換のためのUnity Catalog関数にアクセスします。
-
Vector Searchサーバー: インデックス化されたドキュメントとデータセット全体でのセマンティック検索を可能にします。
-
Genieサーバー: 自然言語からSQLクエリへの変換機能を提供します。
Databricksコネクタの技術的な詳細は、DatabricksのMCP Serverドキュメント(新しいタブで開きます)で確認できます。Databricksのコネクタとの認証は、OAuth(新しいタブで開きます)(Claude.ai(新しいタブで開きます)とClaude Desktop用)またはDatabricks Personal Access Token(新しいタブで開きます)(Claude Desktop専用)を介して処理されます。
組織の所有者としてコネクタを追加する
-
下にスクロールし、リストの下部にある「Add custom connector」をクリックします。
-
Databricksワークスペース(新しいタブで開きます)の統合URLを入力します
-
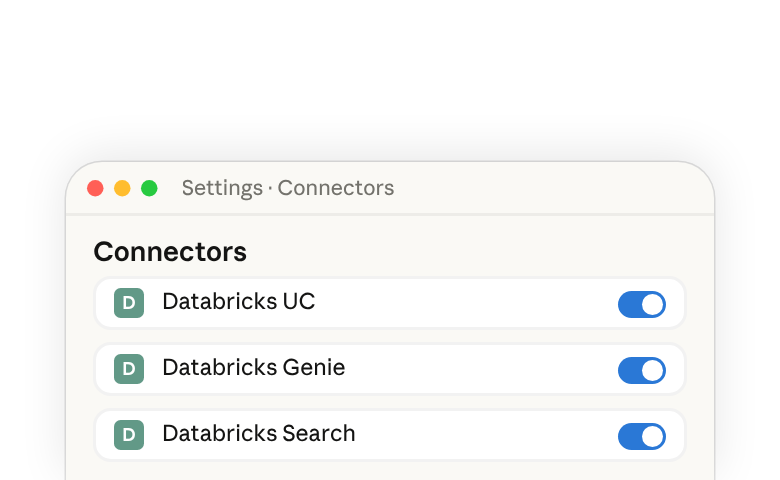
統合に名前を付けます。3つの別々のDatabricksサーバーがあることを忘れずに、それぞれに一意の名前を付けることを検討してください(例:「Databricks UC」、「Databricks Genie」、「Databricks Search」)
-
「Add」をクリックします
個々のユーザーの場合
ツールの検索と接続(新しいタブで開きます)について学びます。
一般的な使用例
利用可能なリソースの例
これらの機能がどのように連携するかを説明するために、以下のDatabricksリソースが設定されたプライベートエクイティ会社を考えてみましょう。
このシナリオにおけるテーブル
-
portfolio_companies: 会社の詳細、買収情報、現在の評価額、負債水準
-
financial_statements: 収益、調整後EBITDA、顧客数や解約率などの運用指標を含む期間財務データ
-
market_comparables: 評価倍率と成長率を含むセクター比較企業
-
due_diligence_docs: デューデリジェンスレポート、分析文書、取引メモのリポジトリ
このシナリオにおけるUnity Catalog関数
-
calculate_normalized_ebitda(): 報告されたEBITDAに標準的なプライベートエクイティ調整を適用し、一時的なコストを除去し、所有者報酬を正規化します
-
compute_portfolio_irr(): キャッシュフローと保有期間に基づいて内部収益率と投資資本倍率を計算します
-
estimate_debt_capacity(): さまざまなシナリオ下でのコベナンツ遵守ストレステストを含む最大レバレッジ能力をモデル化します
このシナリオにおけるベクトル検索インデックス
- due_diligence_index: すべてのデューデリジェンス文書、取引メモ、分析レポートにわたるセマンティック検索
ポートフォリオ出口準備分析
入力プロンプトの例:
どのポートフォリオ企業が出口の準備ができていますか?現在の市場倍率に基づいて評価範囲と期待リターンを示してください。
この分析のために、Claudeは以下のステップで異なるUC関数とGenieを使用することがあります。
-
Genie: 3年以上保有されているポートフォリオ企業を特定し、最新の財務データを取得します。
-
UC関数: 各企業に対して
calculate_normalized_ebitda()を呼び出し、PE調整を適用します。 -
UC関数:
compute_portfolio_irr()を実行して、各企業のIRRとMOICを計算します。 -
Genie: 市場比較企業を照会し、正規化されたEBITDAにセクター倍率を適用して評価範囲を算出します。
その後、Claudeは現在の市場倍率に基づいて、IRR、MOIC、評価範囲を示す出口準備が整った企業の要約で結果を報告することがあります。
新規取引の評価
入力プロンプトの例:
TechCorpの買収(SaaS、収益4,500万ドル、EBITDA1,200万ドル)を評価しています。適正な評価額はどれくらいで、どの程度の負債を支えられますか?分析には過去のデューデリジェンス記録を含めてください。
このリクエストを完了するために、Claudeは以下のワークフローに従うことがあります。
-
Genie: 対象のセクターにおける同規模の企業の市場比較データを照会し、評価ベンチマークを確立します。
-
UC関数: 対象の指標を使用して
estimate_debt_capacity()を呼び出し、レバレッジシナリオをモデル化し、コベナンツ遵守をストレステストします。 -
ベクトル検索: デューデリジェンスインデックスを検索し、関連する価値創造プレイブックと先行取引を見つけます。
-
統合: 結果を組み合わせて、評価範囲、推奨資本構成、関連する先行事例を生成します。
理想的には、Claudeはその後、評価範囲と推奨オファー価格に関するレポートで応答し、その推奨に至った出典を引用します。
コベナンツ違反リスク評価
入力プロンプトの例:
ポートフォリオ全体でEBITDAが15〜25%減少した場合、どの企業がコベナンツ違反のリスクがありますか?どのような対策を取るべきですか?
このタスクのために、Claudeは以下のリソースを使用することがあります。
-
Genie: 負債を持つポートフォリオ企業を特定し、レバレッジが4倍を超える企業に焦点を当てます。
-
UC関数: 各高レバレッジ企業に対してcalculate_normalized_ebitda()を呼び出し、ベースラインを確立します。
-
UC関数: 各企業について15%、20%、25%の減少シナリオでestimate_debt_capacity()を実行します。
-
Genie: 過去の財務データを照会し、運転資本の悪化傾向がある企業を特定します。
その後、Claudeは企業とシナリオ別に整理された違反リスク分析で応答することがあります。
Databricksを使用するためのヒント
-
探しているデータについて具体的に指定してください。
- 例:「顧客を分析してください」の代わりに、「上位20社の顧客を…で示してください」と試してみてください
-
パターンマッチングには「類似を見つける」という表現を使用してください
- 例:「この苦情のような問題に言及しているフィードバックを見つけてください。」
-
すべてのデータアクセス権限はUnity Catalogの権限に従うことを覚えておいてください。Claudeはあなたがアクセスできるデータにのみアクセスできます。
-
カスタム関数は一貫した計算を提供します。標準化された指標を計算するためのUC関数の追加を検討してください。
-
複雑な分析には複数のステップが必要な場合があります。まず計画を求め、Claudeの提案するアプローチを確認してください。