多くの人にとって、AIの使い方を学ぶことは、そのツール自体を学ぶことから始まります。人々はよく次のような質問から始めます。Claudeに必要なことをどう説明すればよいか?良い仕事をするために必要なファイルやデータを、どうすれば安全にClaudeに渡せるか? しかし、Claudeがより大きく複雑なタスクに使われるようになると、より難しい疑問が浮かび上がります。Claudeが正しいかどうかをどうやって知るのか?
評価力、すなわちAIの出力の正確性と関連性は、AI活用力の中でも最も重要な側面の一つです。しかし、それはAIツールの枠を超えて起こり得るため、直接研究するのがより難しいものです。
そこで、Anthropic Interviewer(新しいタブで開きます)の協力を得て、Claude Academyの参加者129名に尋ねました。Claudeと作業する際、評価力とはどのようなものか? 人々は、Claudeと行った最近の作業について、Claudeの品質と正確性をどのように検証したかを含め、自身の体験を語ってくれました。1
多くのことを学びましたが、3つの大きなテーマが浮かび上がりました。第一に、「Claudeの成果物を確認する」ことは、多くの場合、会話の外部にある何か――情報源、文書、テスト、他の人、あるいは別のAI――と照合して検証することを意味していました。第二に、評価力における最大の障壁は時間的なプレッシャーではなく、専門知識の不足でした。そして第三に、Claudeのエラーの発見が遅れた場合、それがしばしば人々に新しく創造的な評価力の行動を取り入れるきっかけとなりました。
これらの体験談は、パワーユーザーが培ってきた習慣を理解する助けとなり、私たち自身の評価力ツールキットを構築するのに役立ちます。本調査の回答者の大半は、6か月以上にわたって毎日Claudeを使用しています。2 これは一般的な利用者層を大きく上回るものであり、優れた実践を記録する上では有用ですが、それ以外の点では限界となります。本サンプルを超えた普及率に関する主張は一切行いません。
主な知見
すべてのインタビューを通じて、3つの注目すべきパターンが見つかりました。
- Claudeの出力を確認することは、通常、外部の情報源との照合を伴う
- 専門知識が評価力における最大の障壁である
- 見逃されたエラーが、創造的で新しい評価力の行動の採用を促すことがある
外部の信頼できる情報源と照合してClaudeの成果物を確認することが、最も多く報告された評価力の実践だった
私たちは、「Claudeの成果物を確認する」ことの多くが、明らかな誤りを見つけるための通し読みとして語られると予想していました。しかし、インタビューした参加者の51%は、Claudeの出力をソース文書、公式ドキュメント、自分自身のデータ、他の人、あるいは別のAIといった外部の何かと照合して検証したと述べました。確認を行った人のうち10%は、さらに踏み込んで、複数の独立した確認を組み合わせていました。外部検証を一切行わない通し読みは少数派の実践であり、特にタスクが技術的な場合はその傾向が顕著でした。
「外部の信頼できる情報源」が何を意味するかは、作業内容によって異なりました。タスクにコードが関わる場合、通常はテストが用いられました。リサーチや分析のタスクでは、情報源との照合やセカンドオピニオンに頼る傾向がありました。微妙なニュアンスを要する知識労働のタスクについては、10件の体験談が、別のAIを使って最初のAIの成果物を確認したと述べていました。ライティングのタスクでは、専門知識と、適合性を見るための同僚による注意深い読み込みに頼る傾向がありました。作業内容が異なれば、必要な手法も異なっていました。
専門知識が評価力における最大の障壁だった
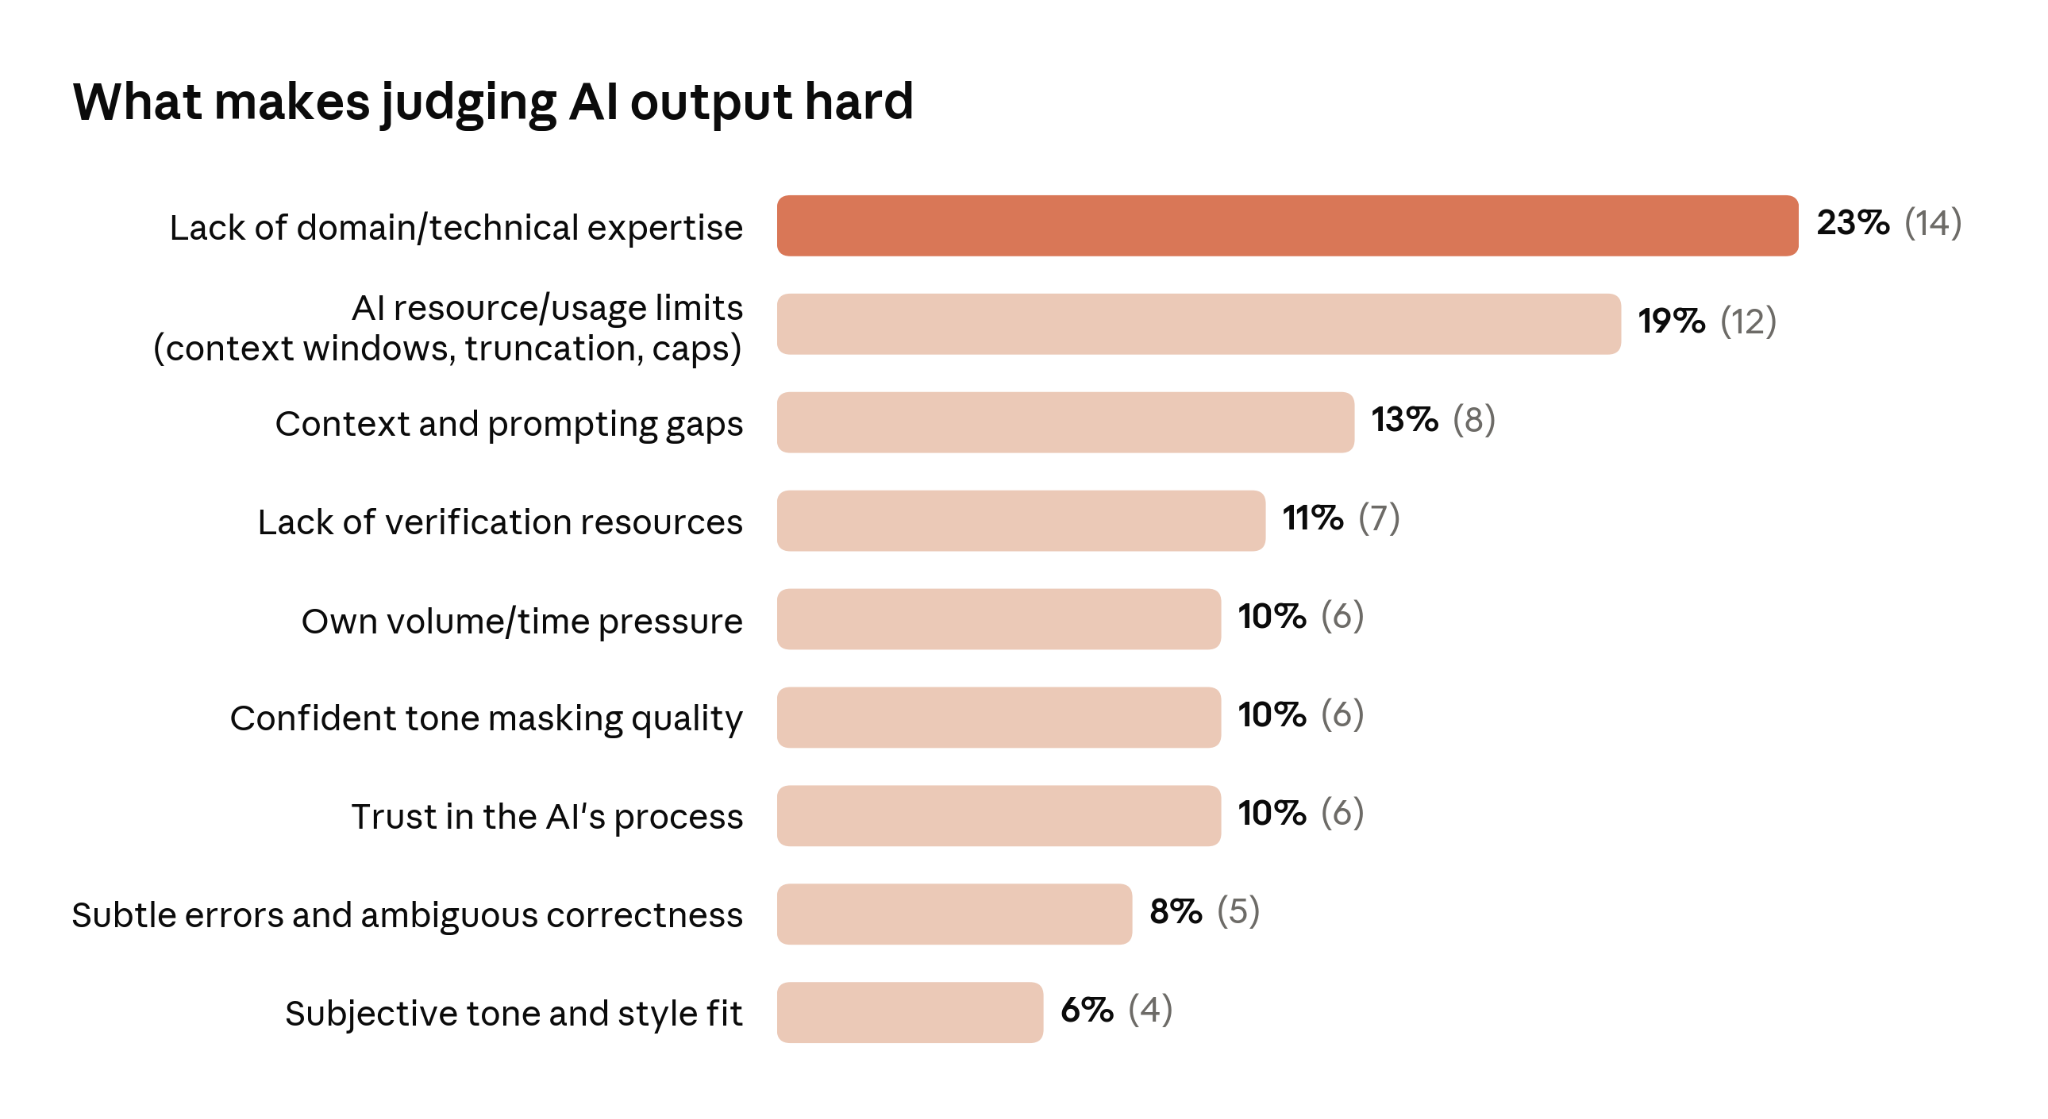
AIは人々が自らの能力を拡張することを可能にしますが、それはつまり、自分の専門分野の外にある作業を行うことが多くなるということです。参加者たちが評価力を難しいと感じたのはまさにそこでした。良い答えがどのようなものかが分からない場合、答えを判断するのは難しいのです。
62名の参加者が評価力の障壁を挙げました。専門分野の知識不足がリストの最上位でした。技術系ではない一部の参加者は、Claudeがソフトウェア開発を伴う解決策へと導いてくれたものの、良いコードや良いアーキテクチャの判断を悪いものと見分けられなかったと述べました。ある学習者は、Claudeの提案を評価するのに十分な専門知識を身につけるために、オンラインのガーデニング動画にまで頼ったほどでした。
私たちは、時間的なプレッシャーがこのリストの最上位に来ると予想していました。しかし、このグループにとってのボトルネックは、出力の品質を評価するのに十分な専門分野の知識を持っているかどうかでした。
エラーを見逃したことが、人々の働き方を変えた
すべてのインタビューを通じて、Claudeが犯したエラーを見逃したという意味のある体験談が18件ありました。そうした体験談を語った人のうち半数は、それが現在の働き方を変えたとも述べています。その誤りを目にしたことが、今後の誤りをどう探せばよいかを教えてくれたのです。
これらの参加者が取り入れた新しい実践には、次のようなものがありました。
- 推奨や分析を提示する前に、まずClaudeに情報源のテキストを引用させること
- 最後にまとめて確認するのではなく、複数ステップのタスクの各段階に承認ゲートを設けること
- 複数のAIエージェントを同時に使うこと:一つが成果物を作成し、他のエージェントがそれぞれ異なる部分を確認する
これらの参加者は、「より一生懸命に成果物を確認する」ようになったわけでも、一夜にして新しい分野の専門家になったわけでもありませんでした。その代わりに、彼らはワークフローを再構築し、評価力のツールキットを磨き上げたのです。
評価力のツールキットを構築する
本調査で最も自信を持って評価を行っていた人々には、一つの共通点がありました。それは優れたツールキットです。より難しく複雑なタスクにAIを使い始めるにあたっては、Claudeの成果物を検証するために使える一連の実践とワークフローを特定することを強くお勧めします。ここでは、始めるための5つのツールを紹介します。
- 最もよく作成する成果物を検証するためのテストを構築する。 ソフトウェア開発者でない場合、自分が行う各作業に対する「テスト」を持っていないことが多いでしょう。しかし、この考え方はどの分野にも応用できます。コンテンツライターであれば、声のトーン、調子、フォーマットに関するルーブリックを作成してください。弁護士であれば、生成された契約文言を確認するために使えるポリシーやルールを定義してください。次のプロンプトを使ってClaudeと一緒に反復し、同僚と共有できる再利用可能なスキルとして、自分自身の検証「テスト」を作成してみましょう。
私が作成する特定の種類の作業について、問題が外に出る前に発見できるよう、再利用可能なチェックを作りたいです。自分専用のQAチェックリストだと考えてください。
何かを書き始める前に、一度に4つか5つの短い質問をしてください。成果物が何で誰が読むのか、優れたバージョンが平凡なバージョンと違ってできていることは何か、これらが通常どのように失敗するか(受け取ったフィードバックや発見が遅れた誤りを含む)、そして間違えたら最も恥ずかしいと思うことは何か、です。良い例を渡した場合は、下書きを作る前にそれを読んでください。
次に、私の回答を、今後のどんな下書きにも使える5つから8つの質問からなるチェックに変換してください。私が書いたものでも、あなたが書いたものでも、一緒に書いたものでも構いません。最も重要な質問を最初に置いてください。すべての質問を一般的な文章作成のアドバイスではなく、私の作業に特化したものにし、そのチェックが、誤った事実や数字、異議を唱えられたら擁護できない推論や主張、ページに書かれていないが読者に必要な文脈、そしてこの読者層に響かない口調を見つける助けになるようにしてください。私が与えていない数値、閾値、ルールを追加しないでください。
このチェックは、チャット内のテキストとしてではなく、スキルとして提供してください。このスキルは、貼り付けられたテキスト、ファイル、またはドキュメントへのリンクとして下書きを受け取り、すべての質問を順番に実行し、それぞれの判断の根拠となる下書き内の正確な行を引用するものとします。
スキルの出力は、テキストレポートではなく、アーティファクトとして公開される視覚的なスコアカードにしてください。最上部には最も重要な修正点を示す判定、一目ですべての質問のステータス(合格、不合格、要確認)がわかる1行のストリップ、そしてその後に質問ごとに1行ずつ、ステータス、引用された行、具体的な修正案を示してください。実行後のチャットの返信は、判定と件数の2行にしてください。まずレビューのためにスキルを見せてから、私の例に対して一度実行し、スコアカードを見せてください。
- チャットを離れる前に、評価力を発揮する機会をClaudeに見つけてもらう。 Anthropicは、複雑なタスクを検知し、さらなる検証を促すナッジをClaudeが提示するようにする評価力スキルを公開しています。このスキルをいくつかの企業でテストした結果、ワークフローに一時停止を挿入することが評価力を高めるという方向性を示す証拠が得られています。以下は、ユーザーがフィラデルフィア市の労働者に関するレポートを依頼した後に、このスキルがチャットに挿入した内容の例です。
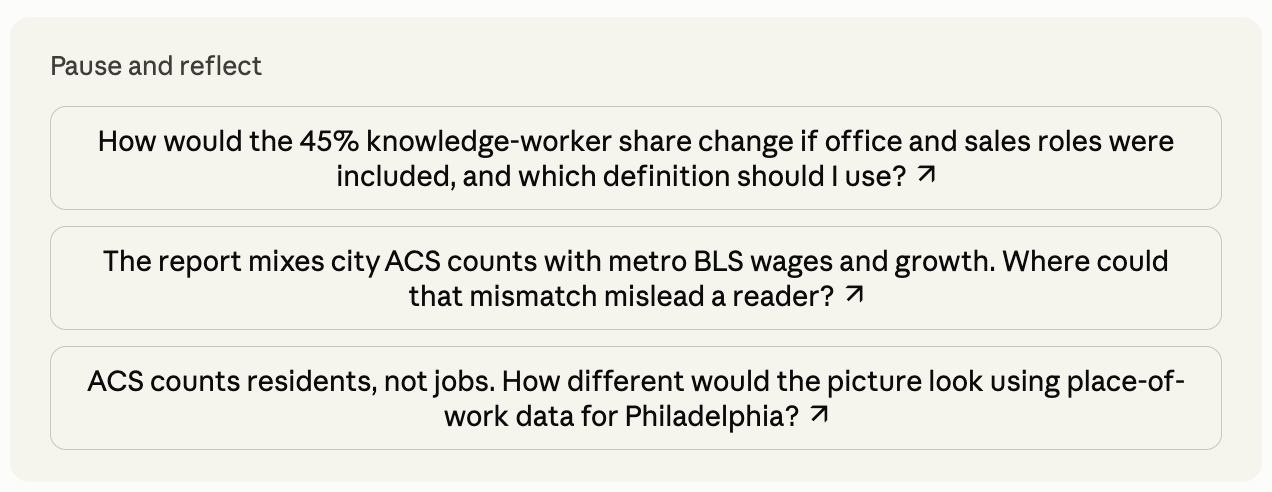
(フィラデルフィア市の労働者に関するレポートを完成させた後に、discernment-nudgeスキルが発動した例)
discernment-nudgeスキルは、ここでClaudeに依頼することでインストールできます。
- Claude Codeでの敵対的レビューを活用する。 Claude Codeには組み込みの敵対的レビュー(新しいタブで開きます)ステップが用意されています。これは、Claudeが新しいサブエージェントを立ち上げて、新たな視点からあなたのコードや成果物をレビューできることを意味します。出力の作成に関与していないエージェントを使うことで、エラーや危険な前提を見つけられる可能性が高まります。
サブエージェントを使って、レート制限機能のdiffをPLAN.mdと照らし合わせてレビューしてください。すべての要件が実装されていること、記載されているエッジケースにテストがあること、タスクの範囲外の変更がないことを確認してください。スタイルの好みではなく、不足点を報告してください。
- 専門家のパネルを構築する。 評価力における最大の障壁として挙げられたのは、対象分野の専門知識の不足でした。セカンドチェックを依頼できる人を特定しておくことで、選択肢が広がります。自分の専門外の分野でセカンドリードを依頼する相手を把握しておき、成果物を世に出す前に連絡を取りましょう。そして、もちろん、その恩返しもしましょう。同僚があなたの専門分野に関する何かを持ってきたとき、あなたが割く5分間が、彼らの評価力を可能にするのです。
次のプロンプトを使って、最近のメールのやり取りをもとに、誰があなたの成果物の評価を手伝ってくれそうかをClaudeと一緒に検討してみましょう。
「友達に電話する」チェックを設定したいです。ある成果物に頼る前に、それを判断してもらうのにふさわしい人を自分のネットワークの中から見つける手伝いをしてください。一度に1ステップずつ進め、次に進む前に私の回答を待ってください。
ステップ1:私のメールが接続されているか確認してください。接続されていない場合は、接続するための手順を一つずつ教えてください。そして、完了したと私が伝えるまで待ってください。名前を推測しないでください。
ステップ2:対象の成果物を私に尋ねてください。アップロードするか、テキストを貼り付けるか、リンクを貼り付けることができます。もしそれが以前のあなたとのチャットから来たものだと私が言ったら、過去のチャットを検索してください。見つけられない場合は、設定で「チャットの検索と参照」を有効にする方法を教えるか、代わりに貼り付けるよう私に頼んでください。
ステップ3:それが何についてのもので、それが良いかどうかを判断するのにどのような専門知識が必要かを、一行で教えてください。
ステップ4:その専門知識を持つ人を私のメールから検索してください。このトピックについてやり取りをしたことがある人、それについてCCに入っている人、それに関する私の質問に答えたことがある人、あるいはそれが関わる意思決定を担っている人です。
ステップ5:2〜4人を提案してください。それぞれについて、私のメールから見つけた内容に基づく一行の理由と、見てもらうよう頼むための短いメッセージを添えてください。
単によくメールをやり取りする人よりも、その主題を知っていて率直に意見してくれる人を優先してください。私の代わりに誰かに連絡を取らないでください。また、提案するメモの中に私のメールを引用しないでください。連絡は自分で行います。
- Claudeにソースの裏付けを求める。 外部の情報源と照合してClaudeの成果物を確認することは、定番の実践でした。回答内の各主張についてClaudeに情報源を引用させることで、この作業をより簡単にしてもらうことができます。情報源が手元にあれば、何が裏付けられていて、何にさらなる調査が必要かを素早く確認できます。
Claudeで出力を生成した後、会話の中で次のプロンプトを試してみてください。
あなたの回答に含まれる各事実に基づく主張について、それがどこから来たのかを教えてください。情報源から正確な一節を引用し、リンクまたはページ番号を含めてください。もし主張があなたの一般的な知識に基づくものであれば、「出典なし」とラベル付けして、私が最初に何を確認すべきかが分かるようにしてください。
制限事項
これらの知見には、重要な留意点があります。
- サンプルの限界: Academyの登録者は、AIとの作業をより上達させたいという意欲を持って自ら選んで参加した参加者であり、その実践は一般的な利用者層の基準を上回っている可能性が高いです。サンプル(129件のインタビュー、94件の完了)は経験豊富で技術的な層に偏っており、そのため新規ユーザーの評価力における課題は過小に表れています。これらの体験談は、普遍的なベンチマークとしてではなく、この母集団における実践のカタログとして理解されるべきであり、AIユーザー全般の普及率に関する主張は一切行いません。
- 自己申告: すべてのデータは自己申告によるものです。私たちは実際の作業についての「順を追って説明してください」という体験談を優先し、構造化された評価は記述的な文脈として扱いました。「何かが見逃された時」の想起は可用性バイアスの影響を受けやすく、劇的な失敗は、より忘れられやすい失敗に比べて過剰に表れている可能性があります。
- コーディングの限界: テーマ別コーディングはLLMの支援を受けて行われました。これを緩和するため、監査用にテーマごとの正確なトランスクリプトリストを保持し、構造化モジュールの決定論的(ルールベースの)相互検証を行い、各テーマの少なくとも10%について人間によるレビューを実施し、ルーブリック改訂後には影響を受けたすべての次元について完全な再コーディングを行いました。
今後の展望
本調査は、意欲的なパワーユーザーから、Claudeの成果物をどのように確認しているかについての体験談とテーマを収集しました。私たちの意図は、評価力がどのように発達するか、そして実際にどのような戦術がうまく機能するかについての理解を広げることでした。
今後の取り組みでは、組織に対する評価力スキルの影響を測定する介入研究を通じてこれを拡張し、「自分の分野向けのテスト」というアイデアを、誰もが採用し貢献できる、役割別の共有チェックライブラリへと発展させていく予定です。
モデルがますます洗練された出力を生み出すようになるにつれて、評価力も進化していくと私たちは考えています。本研究および今後の研究を通じて、その進化を可視化し、誰もが使える教育ツールを提供することを目指しています。
Bibtex
この記事を引用したい場合は、以下のBibtexキーを使用できます。
@online{swanson2026aidiscernment,
author = {Kristen Swanson and Maggie Vo and Zoe Ludwig and Jeff Olson and Matt Gallivan and Erik Olesund and Rick Dakan and Joe Feller},
title = {Anthropic Education Report: How people check Claude's work},
date = {2026-09-10},
year = {2026},
url = {https://academy.claude.com/tutorials/discernment-toolkit},
}
謝辞
Kristen Swansonが本調査を設計し、分析を主導し、Matt Gallivan、Jeff Olson、Erik Olesundからのフィードバックを受けて本レポートを執筆しました。Maggie VoとZoe Ludwigは、フレームワークの整合性、メッセージング、レビューに貢献しました。AI活用力のための4Dフレームワークは、Rick DakanとJoe Fellerによって、Anthropicとの協力のもとで開発されました。Mo JulapalliとAnkit Sivaは技術的サポートを提供しました。Ryan DoneganとMolly Vorwerckは、コミュニケーション面のレビューと助言を提供しました。
脚注
- 人々が自身のAI利用についてどのように語るかを調査する際、参加者のプライバシー保護は最優先事項です。インタビューは、Claudeを活用した定性的インタビュアーであるAnthropic Interviewer(新しいタブで開きます)によって、その標準的な同意フローのもとで実施されました。回答は、ユーザーのClaude Academyアカウント、コースの進捗状況、Claude.aiの会話データとは紐付けられていません。本分析には個人を特定できる情報は一切含まれていません。調査期間中にClaude AcademyでAI活用力コースに登録したすべての人は、登録メールの中で、任意の研究対話への参加を呼びかける案内を受け取りました。参加は無報酬であり、コースへの登録とは別のものでした。インタビューを開始した129名の参加者のうち、94名がアンケートモジュールを含めて完全に完了しました。自由記述の体験談は、部分的なインタビューであっても意味のある作業の体験談が含まれていることが多かったため、129件すべてのトランスクリプトから分析されました。一方、アンケートの数値は、アンケートに到達したサブセット(項目によりn=95〜98)に基づいています。テーマ別コーディングは次のように行われました。LLMが研究課題に対してコーパス全体をコーディングし、各テーマの根拠となるトランスクリプトの正確なリストを監査用に保持しました。アンケートモジュールは決定論的に解析されました。その後、人間の評価者がコーディングの不整合を特定するために、各テーマの少なくとも10%をレビューしました。そのレビューに基づいてコーディングルーブリックが修正され、影響を受けたすべての次元が改訂後のルーブリックに対して完全に再コーディングされました。新たにコーディングされたすべてのデータセットは、再び人間によってレビューおよび分析されました。本論文は人間によって完全に執筆され、AIの助けを借りて改訂されました。
- アンケートモジュール(n=95)より:95名の回答者のうち63名が毎日の利用を報告し、62名が6か月以上のAIツール利用経験を報告しました。回答者の自己評価による自信は、いつ検証すべきかを知っていることについて最も高く(5段階評価で平均3.9)、完全性を判断することについて最も低く(3.5)、正確性を判断することはその中間でした(3.7)。これは評価力の障壁に関する知見と一致しています。参加者は概して検証が必要であることを理解していますが、難しいのは自分の専門外でそれを行うことです。