Pour beaucoup, apprendre à utiliser l'IA commence par apprendre l'outil lui-même. Les gens commencent souvent par des questions comme : Comment décrire à Claude ce dont j'ai besoin ? Comment donner à Claude, en toute sécurité, les fichiers et les données dont il a besoin pour bien faire son travail ? Mais à mesure que Claude est utilisé pour des tâches plus importantes et plus complexes, une question plus difficile se pose : comment savoir si Claude a raison ?
Le discernement, c'est-à-dire l'exactitude et la pertinence des résultats produits par l'IA, est l'un des aspects les plus essentiels de la maîtrise de l'IA. Pourtant, il est plus difficile à étudier directement, car il peut se produire en dehors des limites d'un outil d'IA.
C'est ainsi qu'avec l'aide d'Anthropic Interviewer(s’ouvre dans un nouvel onglet), nous avons demandé à 129 participants de Claude Academy : à quoi ressemble le discernement lorsque vous travaillez avec Claude ? Les participants ont partagé leurs expériences récentes de travail avec Claude, notamment la manière dont ils ont vérifié la qualité et l'exactitude des réponses de Claude.1
Nous avons beaucoup appris, mais trois grands thèmes se sont dégagés. Premièrement, « vérifier le travail de Claude » signifiait le plus souvent une vérification par rapport à quelque chose d'externe à la conversation : sources, documents, tests, autres personnes ou une autre IA. Deuxièmement, le principal obstacle au discernement n'était pas la pression du temps, mais le manque d'expertise du domaine. Et troisièmement, lorsque les erreurs de Claude étaient détectées trop tard, cela incitait souvent les gens à adopter de nouveaux comportements de discernement, plus créatifs.
Ces témoignages nous aident à comprendre les habitudes développées par les utilisateurs expérimentés, afin que nous puissions construire nos propres boîtes à outils de discernement. La plupart des répondants de cette étude utilisent Claude quotidiennement depuis six mois ou plus.2 Ce chiffre est bien supérieur à celui de la population générale, ce qui est utile pour répertorier les bonnes pratiques, mais constitue une limite pour toute autre interprétation. Nous ne formulons aucune affirmation de prévalence au-delà de cet échantillon.
Principaux enseignements
Dans l'ensemble des entretiens, nous avons identifié trois tendances notables :
- Vérifier les résultats de Claude implique généralement une validation par rapport à des sources externes
- L'expertise est le principal obstacle au discernement
- Les erreurs qui passent inaperçues peuvent favoriser l'adoption de nouveaux comportements de discernement, plus créatifs
Vérifier le travail de Claude par rapport à une source de vérité externe était la pratique de discernement la plus fréquemment rapportée
Nous nous attendions à ce que « vérifier le travail de Claude » soit principalement décrit comme une relecture à la recherche d'erreurs évidentes. Cependant, 51 % des participants interrogés ont décrit une vérification des résultats de Claude par rapport à quelque chose d'externe : documents sources, documentation officielle, leurs propres données, une autre personne, voire une autre IA. 10 % des vérificateurs sont allés encore plus loin, en combinant plusieurs vérifications indépendantes. Une simple relecture sans validation externe était la pratique minoritaire, en particulier lorsque la tâche était technique.
Ce que signifiait une « source de vérité externe » dépendait du travail effectué. Lorsque la tâche impliquait du code, des tests étaient généralement utilisés. Les tâches de recherche et d'analyse s'appuyaient sur des vérifications croisées par rapport à des sources et sur des avis complémentaires. Dix témoignages décrivaient l'utilisation d'une seconde IA pour vérifier le travail de la première, pour des tâches de travail intellectuel nuancées. Les tâches de rédaction s'appuyaient sur la connaissance du domaine et sur une relecture attentive par un pair pour en vérifier l'adéquation. Des travaux différents nécessitaient des méthodes différentes.
L'expertise était le principal obstacle au discernement
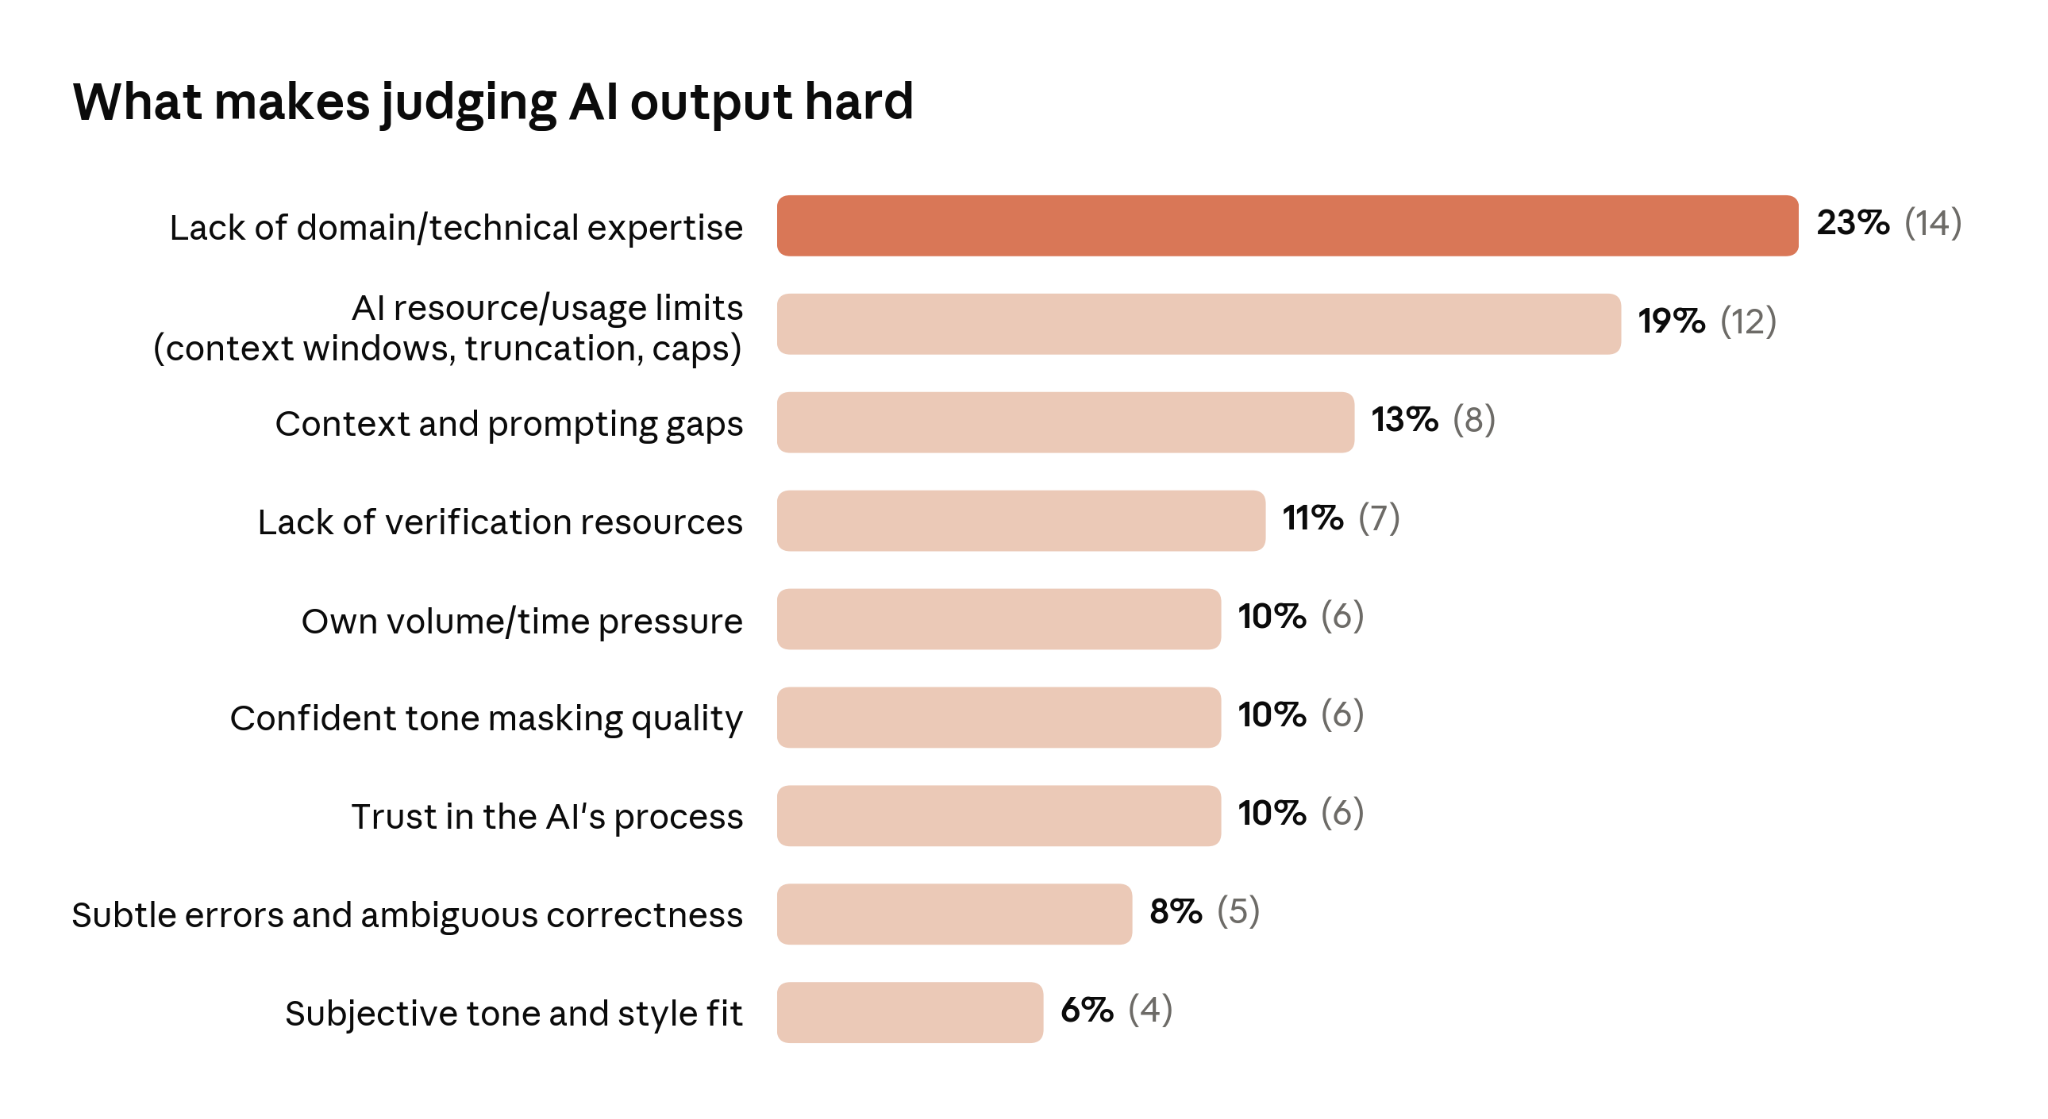
L'IA permet aux gens d'élargir leurs capacités, ce qui signifie qu'ils effectuent souvent des tâches en dehors de leur domaine d'expertise direct. C'est précisément là que ces participants ont trouvé le discernement difficile : il est compliqué de juger une réponse lorsqu'on ne sait pas à quoi ressemble une bonne réponse.
Soixante-deux participants ont cité un obstacle au discernement. Le manque d'expertise dans le domaine concerné arrivait en tête de liste. Certains participants non techniques ont décrit comment Claude les a guidés à travers des solutions impliquant du développement logiciel, où ils ne pouvaient pas distinguer un bon code ou de bonnes décisions d'architecture des mauvaises. Un apprenant s'est même tourné vers des vidéos de jardinage en ligne pour acquérir juste assez de connaissances du domaine afin d'évaluer les recommandations de Claude.
Nous nous attendions à ce que la pression du temps arrive en tête de cette liste. Pour ce groupe, le goulot d'étranglement résidait dans le fait de disposer de suffisamment d'expertise dans le domaine pour évaluer la qualité du résultat.
Laisser passer une erreur a changé la façon de travailler des participants
Sur l'ensemble des entretiens, on compte 18 témoignages significatifs de participants ayant manqué une erreur commise par Claude. La moitié des personnes ayant partagé une telle histoire nous ont également dit que cela avait changé leur façon de travailler aujourd'hui. Avoir constaté l'erreur leur a appris à repérer les suivantes.
Parmi les nouvelles pratiques adoptées par ces participants, on trouve :
- Exiger que Claude cite d'abord son texte source, avant de proposer une recommandation ou une analyse
- Créer des points de validation à chaque étape d'une tâche à plusieurs étapes, plutôt que de ne relire qu'à la fin
- Utiliser plusieurs agents d'IA à la fois : l'un produit le travail, les autres en vérifient différentes parties
Pour ces participants, il ne s'agissait pas de « vérifier leur travail plus rigoureusement » ou de devenir experts dans un nouveau domaine du jour au lendemain. Ils ont plutôt restructuré leurs flux de travail et affiné leur boîte à outils de discernement.
Construire votre boîte à outils de discernement
Les participants les plus sûrs de leur discernement dans cette étude avaient un point commun : une bonne boîte à outils. À mesure que vous commencez à utiliser l'IA pour des tâches plus difficiles et plus complexes, nous vous recommandons vivement d'identifier un ensemble de pratiques et de flux de travail que vous pouvez utiliser pour valider le travail de Claude. Voici cinq outils pour vous lancer.
- Créez des tests pour valider les livrables que vous produisez le plus souvent. Si vous n'êtes pas développeur logiciel, vous n'avez probablement pas de « tests » pour chaque tâche que vous effectuez. Mais l'idée s'applique à tous les domaines. Si vous êtes rédacteur de contenu, créez des grilles d'évaluation pour la voix, le ton et le format. Si vous êtes avocat, définissez des politiques et des règles que vous pouvez utiliser pour vérifier le langage contractuel généré. Essayez ce prompt pour itérer avec Claude et créer votre propre « test » de validation sous forme de Compétence réutilisable pouvant être partagée avec vos collègues :
Je veux créer une vérification réutilisable pour un type de travail que je produis, afin de pouvoir repérer les problèmes avant qu'il ne soit publié. Considère cela comme ma propre liste de contrôle qualité.
Avant d'écrire quoi que ce soit, pose-moi quatre ou cinq questions courtes en une seule fois : ce qu'est le livrable et qui le lit ; ce qu'une excellente version fait qu'une version correcte ne fait pas ; comment ces travaux échouent habituellement, y compris les retours que j'ai reçus ou les erreurs que j'ai repérées trop tard ; et ce qui me gênerait le plus de rater. Si je te donne un exemple d'un bon livrable, lis-le avant de rédiger.
Transforme ensuite mes réponses en une vérification de cinq à huit questions que je pourrai poser à n'importe quel futur brouillon, que je l'aie écrit, que tu l'aies écrit, ou que nous l'ayons écrit ensemble. Place la question la plus importante en premier. Fais en sorte que chaque question soit spécifique à mon travail plutôt que des conseils d'écriture généraux, et assure-toi que la vérification m'aide à repérer les faits ou chiffres erronés, les raisonnements ou affirmations que je ne pourrais pas défendre si on me les contestait, le contexte dont le lecteur a besoin mais qui ne figure pas dans le document, et un ton qui ne conviendrait pas à ce public. N'ajoute pas de chiffres, de seuils ou de règles que je ne t'ai pas donnés.
Livre la vérification sous forme de Compétence, et non de texte dans le chat. La Compétence doit accepter un brouillon sous forme de texte collé, de fichier ou de lien vers un document, exécuter chaque question dans l'ordre, et citer les lignes exactes du brouillon qui déterminent chaque réponse.
Le résultat de la Compétence doit être un tableau de bord visuel publié sous forme d'Artefact, et non un rapport textuel : un verdict en haut nommant la correction la plus importante à apporter, une bande d'une ligne montrant d'un coup d'œil le statut de chaque question (réussi, échoué, signalé), puis une ligne par question avec le statut, la ligne citée et une correction concrète. La réponse dans le chat après une exécution doit tenir en deux lignes : le verdict et les décomptes. Montre-moi la Compétence pour relecture, puis exécute-la une fois sur mon exemple afin que je puisse voir le tableau de bord.
- Laissez Claude vous aider à repérer les occasions de faire preuve de discernement avant de quitter le chat. Anthropic a publié une Compétence de discernement qui détecte les tâches complexes et incite Claude à proposer des pistes de validation supplémentaires. Après avoir testé cette Compétence auprès de quelques entreprises, des indices directionnels suggèrent que l'insertion de pauses dans votre flux de travail renforce le discernement. Voici un exemple de ce que la Compétence a ajouté au chat après qu'un utilisateur a demandé un rapport sur les travailleurs de la ville de Philadelphie :
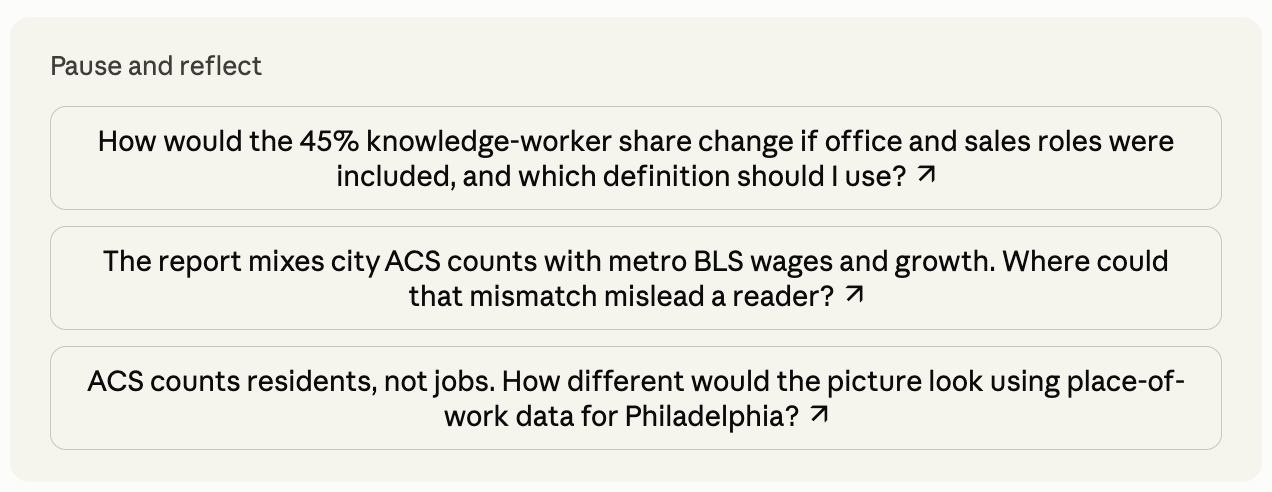
(Un exemple de déclenchement de la Compétence discernment-nudge après l'achèvement d'un rapport sur les travailleurs de la ville de Philadelphie)
Vous pouvez installer la Compétence discernment-nudge en demandant à Claude ici :
Merci d'installer ce fichier .md en tant que Compétence :
- Utilisez la relecture contradictoire dans Claude Code. Claude Code propose une étape de relecture contradictoire intégrée(s’ouvre dans un nouvel onglet). Cela signifie que Claude est capable de lancer un nouveau sous-agent pour examiner votre code ou votre livrable sous un angle nouveau. Utiliser un agent qui n'a pas participé à la construction du résultat augmente les chances de repérer des erreurs ou des hypothèses dangereuses.
Utilise un sous-agent pour examiner le diff du limiteur de débit par rapport à PLAN.md. Vérifie que chaque exigence est implémentée, que les cas limites listés disposent de tests, et que rien en dehors du périmètre de la tâche n'a changé. Signale les lacunes, pas les préférences de style.
- Constituez un panel d'experts. Le principal obstacle au discernement cité était le manque d'expertise sur le sujet traité. Identifier des personnes que vous pouvez solliciter pour une vérification secondaire élargit vos options. Sachez à qui vous adresser pour une seconde lecture dans les domaines en dehors de votre expertise, et contactez-les avant de livrer votre travail. Puis, bien sûr, rendez la pareille. Lorsqu'un collègue vous soumet quelque chose dans votre domaine d'expertise, ce sont vos cinq minutes qui rendent son discernement possible.
Essayez ce prompt pour itérer avec Claude sur les personnes susceptibles de vous aider à évaluer vos résultats, en vous basant sur vos échanges d'e-mails récents :
Je veux mettre en place une vérification de type « appel à un ami ». Avant de me fier à un travail, tu vas m'aider à trouver les bonnes personnes dans mon propre réseau pour le juger. Guide-moi étape par étape, et attends ma réponse avant de passer à la suivante.
Étape 1 : Vérifie si ma messagerie est connectée. Si ce n'est pas le cas, donne-moi des instructions étape par étape pour la connecter, puis attends que je te confirme que c'est fait. Ne devine pas de noms.
Étape 2 : Demande-moi le travail en question. Je peux le téléverser, coller le texte, ou coller un lien vers celui-ci. Si je te dis qu'il provient d'une conversation précédente avec toi, recherche-le dans mes conversations passées ; si tu n'y arrives pas, indique-moi comment activer « Rechercher et référencer les conversations » dans mes paramètres, ou demande-moi de le coller à la place.
Étape 3 : Dis-moi en une ligne de quoi il s'agit et quel type d'expertise serait nécessaire pour juger si c'est bon.
Étape 4 : Recherche dans ma messagerie des personnes possédant cette expertise : des personnes avec qui j'ai échangé sur ce sujet, des personnes mises en copie à ce sujet, des personnes ayant répondu à mes questions à ce propos, ou qui sont responsables de la décision à laquelle cela contribue.
Étape 5 : Propose 2 à 4 personnes. Pour chacune, donne une raison en une ligne basée sur ce que tu as trouvé dans ma messagerie, et un court message que je pourrais envoyer pour leur demander d'y jeter un œil.
Privilégie les personnes qui connaissent le sujet et qui n'hésiteront pas à me contredire, plutôt que les personnes à qui j'écris simplement souvent. Ne contacte personne à ma place, et ne cite pas mes e-mails dans les notes suggérées ; je les contacterai moi-même.
- Demandez à Claude un ancrage dans les sources. Vérifier le travail de Claude par rapport à une source externe était une pratique de référence. Vous pouvez demander à Claude de faciliter ce travail en lui faisant citer les sources de chaque affirmation dans sa réponse. Avec ces sources en main, vous pouvez rapidement vérifier ce qui tient la route et ce qui pourrait nécessiter des recherches supplémentaires de votre part.
Essayez ce prompt dans votre conversation après avoir généré un résultat avec Claude :
Pour chaque affirmation factuelle de ta réponse, indique-moi d'où elle provient. Cite le passage exact de la source et inclus le lien ou le numéro de page. Si une affirmation provient de tes connaissances générales, indique-la comme « non sourcée » afin que je sache ce qu'il faut vérifier en premier.
Limites
Ces enseignements s'accompagnent de réserves importantes :
- Limites de l'échantillon : les personnes inscrites à l'Academy sont des participants auto-sélectionnés et motivés, qui ont choisi de s'inscrire pour mieux travailler avec l'IA ; leurs pratiques se situent probablement au-dessus de la référence de la population générale. L'échantillon (129 entretiens, 94 complets) est orienté vers des profils expérimentés et techniques, de sorte que les difficultés de discernement des utilisateurs plus récents sont sous-représentées. Ces témoignages doivent être compris comme un catalogue de pratiques au sein de cette population, et non comme une référence universelle, et nous ne formulons aucune affirmation de prévalence concernant les utilisateurs d'IA en général.
- Déclaration personnelle : toutes les données sont issues de déclarations personnelles. Nous avons privilégié les récits détaillés (« guide-moi à travers cela ») de travaux réels et traité les évaluations structurées comme un contexte descriptif. Le souvenir d'« une fois où quelque chose est passé inaperçu » est soumis à un biais de disponibilité : les échecs spectaculaires sont probablement surreprésentés par rapport à ceux plus facilement oubliés.
- Limites du codage : le codage thématique a été assisté par un LLM. Nous avons atténué ce risque grâce à des listes exactes de transcriptions par thème conservées à des fins d'audit, à une validation croisée déterministe (basée sur des règles) du module structuré, à une relecture humaine d'au moins 10 % de chaque thème, et à un recodage complet de chaque dimension concernée après révision de la grille.
Perspectives
Cette étude a recueilli des témoignages et des thèmes auprès d'utilisateurs expérimentés et motivés sur la manière dont ils vérifient le travail de Claude. Notre objectif était d'approfondir notre compréhension de la façon dont le discernement se développe et des tactiques qui fonctionnent bien en pratique.
Dans nos travaux futurs, nous prévoyons d'approfondir cette démarche à travers des études d'intervention mesurant l'impact de la Compétence de discernement sur les organisations, et de faire évoluer l'idée des « tests pour votre domaine » vers une bibliothèque partagée de vérifications spécifiques à chaque rôle, que chacun pourra adopter et enrichir.
Nous nous attendons à ce que le discernement évolue à mesure que les modèles produisent des résultats de plus en plus aboutis. Avec cette étude et les suivantes, nous visons à rendre cette évolution visible et à fournir des outils pédagogiques que chacun pourra utiliser.
Bibtex
Si vous souhaitez citer cet article, vous pouvez utiliser la clé Bibtex suivante :
@online{swanson2026aidiscernment,
author = {Kristen Swanson and Maggie Vo and Zoe Ludwig and Jeff Olson and Matt Gallivan and Erik Olesund and Rick Dakan and Joe Feller},
title = {Anthropic Education Report: How people check Claude's work},
date = {2026-09-10},
year = {2026},
url = {https://academy.claude.com/tutorials/discernment-toolkit},
}
Remerciements
Kristen Swanson a conçu la recherche, dirigé l'analyse et rédigé ce rapport avec les retours de Matt Gallivan, Jeff Olson et Erik Olesund. Maggie Vo et Zoe Ludwig ont contribué à l'alignement du modèle, à la communication et à la relecture. Le modèle des 4D pour la maîtrise de l'IA a été développé par Rick Dakan et Joe Feller en partenariat avec Anthropic. Mo Julapalli et Ankit Siva ont apporté un soutien technique. Ryan Donegan et Molly Vorwerck ont assuré la relecture et l'orientation des communications.
Notes de bas de page
- Lorsqu'on étudie la manière dont les gens décrivent leur utilisation de l'IA, protéger la vie privée des participants est primordial. Les entretiens ont été menés par Anthropic Interviewer(s’ouvre dans un nouvel onglet), un intervieweur qualitatif propulsé par Claude, selon son processus de consentement standard ; les réponses n'ont pas été associées au compte Claude Academy d'un utilisateur, à sa progression dans les cours, ni aux données de conversation Claude.ai. Aucune information personnellement identifiable n'apparaît dans cette analyse. Toute personne inscrite à un cours de maîtrise de l'IA sur Claude Academy pendant la période de collecte a reçu, dans son e-mail d'inscription, une note proposant une conversation de recherche facultative. La participation n'était pas rémunérée et était distincte de l'inscription au cours. Sur les 129 participants ayant commencé un entretien, 94 l'ont entièrement terminé, y compris le module d'enquête. Les témoignages ouverts ont été analysés à partir des 129 transcriptions, car les entretiens partiels contenaient fréquemment un récit de travail significatif, tandis que les chiffres de l'enquête reposent sur le sous-ensemble de participants ayant atteint l'enquête (n=95–98 selon l'item). Le codage thématique s'est déroulé comme suit : un LLM a codé l'ensemble du corpus par rapport aux questions de recherche, la liste exacte des transcriptions derrière chaque thème étant conservée à des fins d'audit. Le module d'enquête a été analysé de manière déterministe. Ensuite, un évaluateur humain a relu au moins 10 % de chaque thème afin d'identifier les incohérences de codage. La grille de codage a été modifiée sur la base de cette relecture, et chaque dimension concernée a été entièrement recodée selon la grille révisée. Tous les nouveaux jeux de données codés ont de nouveau été relus et analysés par un humain. Cet article a été entièrement rédigé par un humain et révisé avec l'aide de l'IA.
- D'après le module d'enquête (n=95) : 63 des 95 répondants ont déclaré une utilisation quotidienne, et 62 des 95 ont déclaré six mois ou plus d'expérience avec les outils d'IA. La confiance auto-évaluée des répondants était la plus élevée pour savoir quand vérifier (moyenne de 3,9 sur une échelle de 5 points) et la plus faible pour juger de l'exhaustivité (3,5), le jugement de l'exactitude se situant entre les deux (3,7). Ceci est cohérent avec les constats relatifs aux obstacles au discernement : les participants savent globalement qu'une vérification est nécessaire, et la difficulté réside dans le fait de l'effectuer en dehors de leur domaine d'expertise.