Als wir den AI Fluency Index(öffnet in neuem Tab) einführten, wollten wir verstehen, wie Menschen im Laufe der Zeit besser im Umgang mit Claude werden. Die ersten Daten stammten aus Chat und erzählten eine konsistente Geschichte: KI-Kompetenz entwickelt sich entlang zweier Stränge, die sich sehr unterschiedlich verhalten. Manche Fähigkeiten wachsen natürlich mit der Praxis, andere erfordern bewusstes, wiederholtes Lehren. Diese Erkenntnis prägte, wie wir über Onboarding und produktinternes Lernen denken, und gab Organisationen einen Ausgangspunkt für den Aufbau ihres eigenen Claude-Trainings.
Seitdem haben wir den Index auf Claude Code und Claude Cowork ausgeweitet, womit sich die Gesamtzahl auf über 50.000 Gespräche über die 11 verhaltensbezogenen KI-Kompetenz-Indikatoren erstreckt. KI-Kompetenz hat über alle drei Oberflächen hinweg eine gemeinsame Struktur, aber jedes Produkt hat seinen eigenen Einstiegspunkt. Wie „gut im Umgang mit Claude werden" aussieht, hängt davon ab, welches Claude du verwendest, und wenn du dafür verantwortlich bist, einem Team beim Aufbau von KI-Kompetenz zu helfen, ist diese Unterscheidung wichtig dafür, was du zuerst vermittelst.
Dieser Beitrag geht durch, was wir herausgefunden haben, und bietet ein einfaches Curriculum-Modell, das du für deine Organisation anpassen kannst.
Jedes Produkt hat einen Signature Move
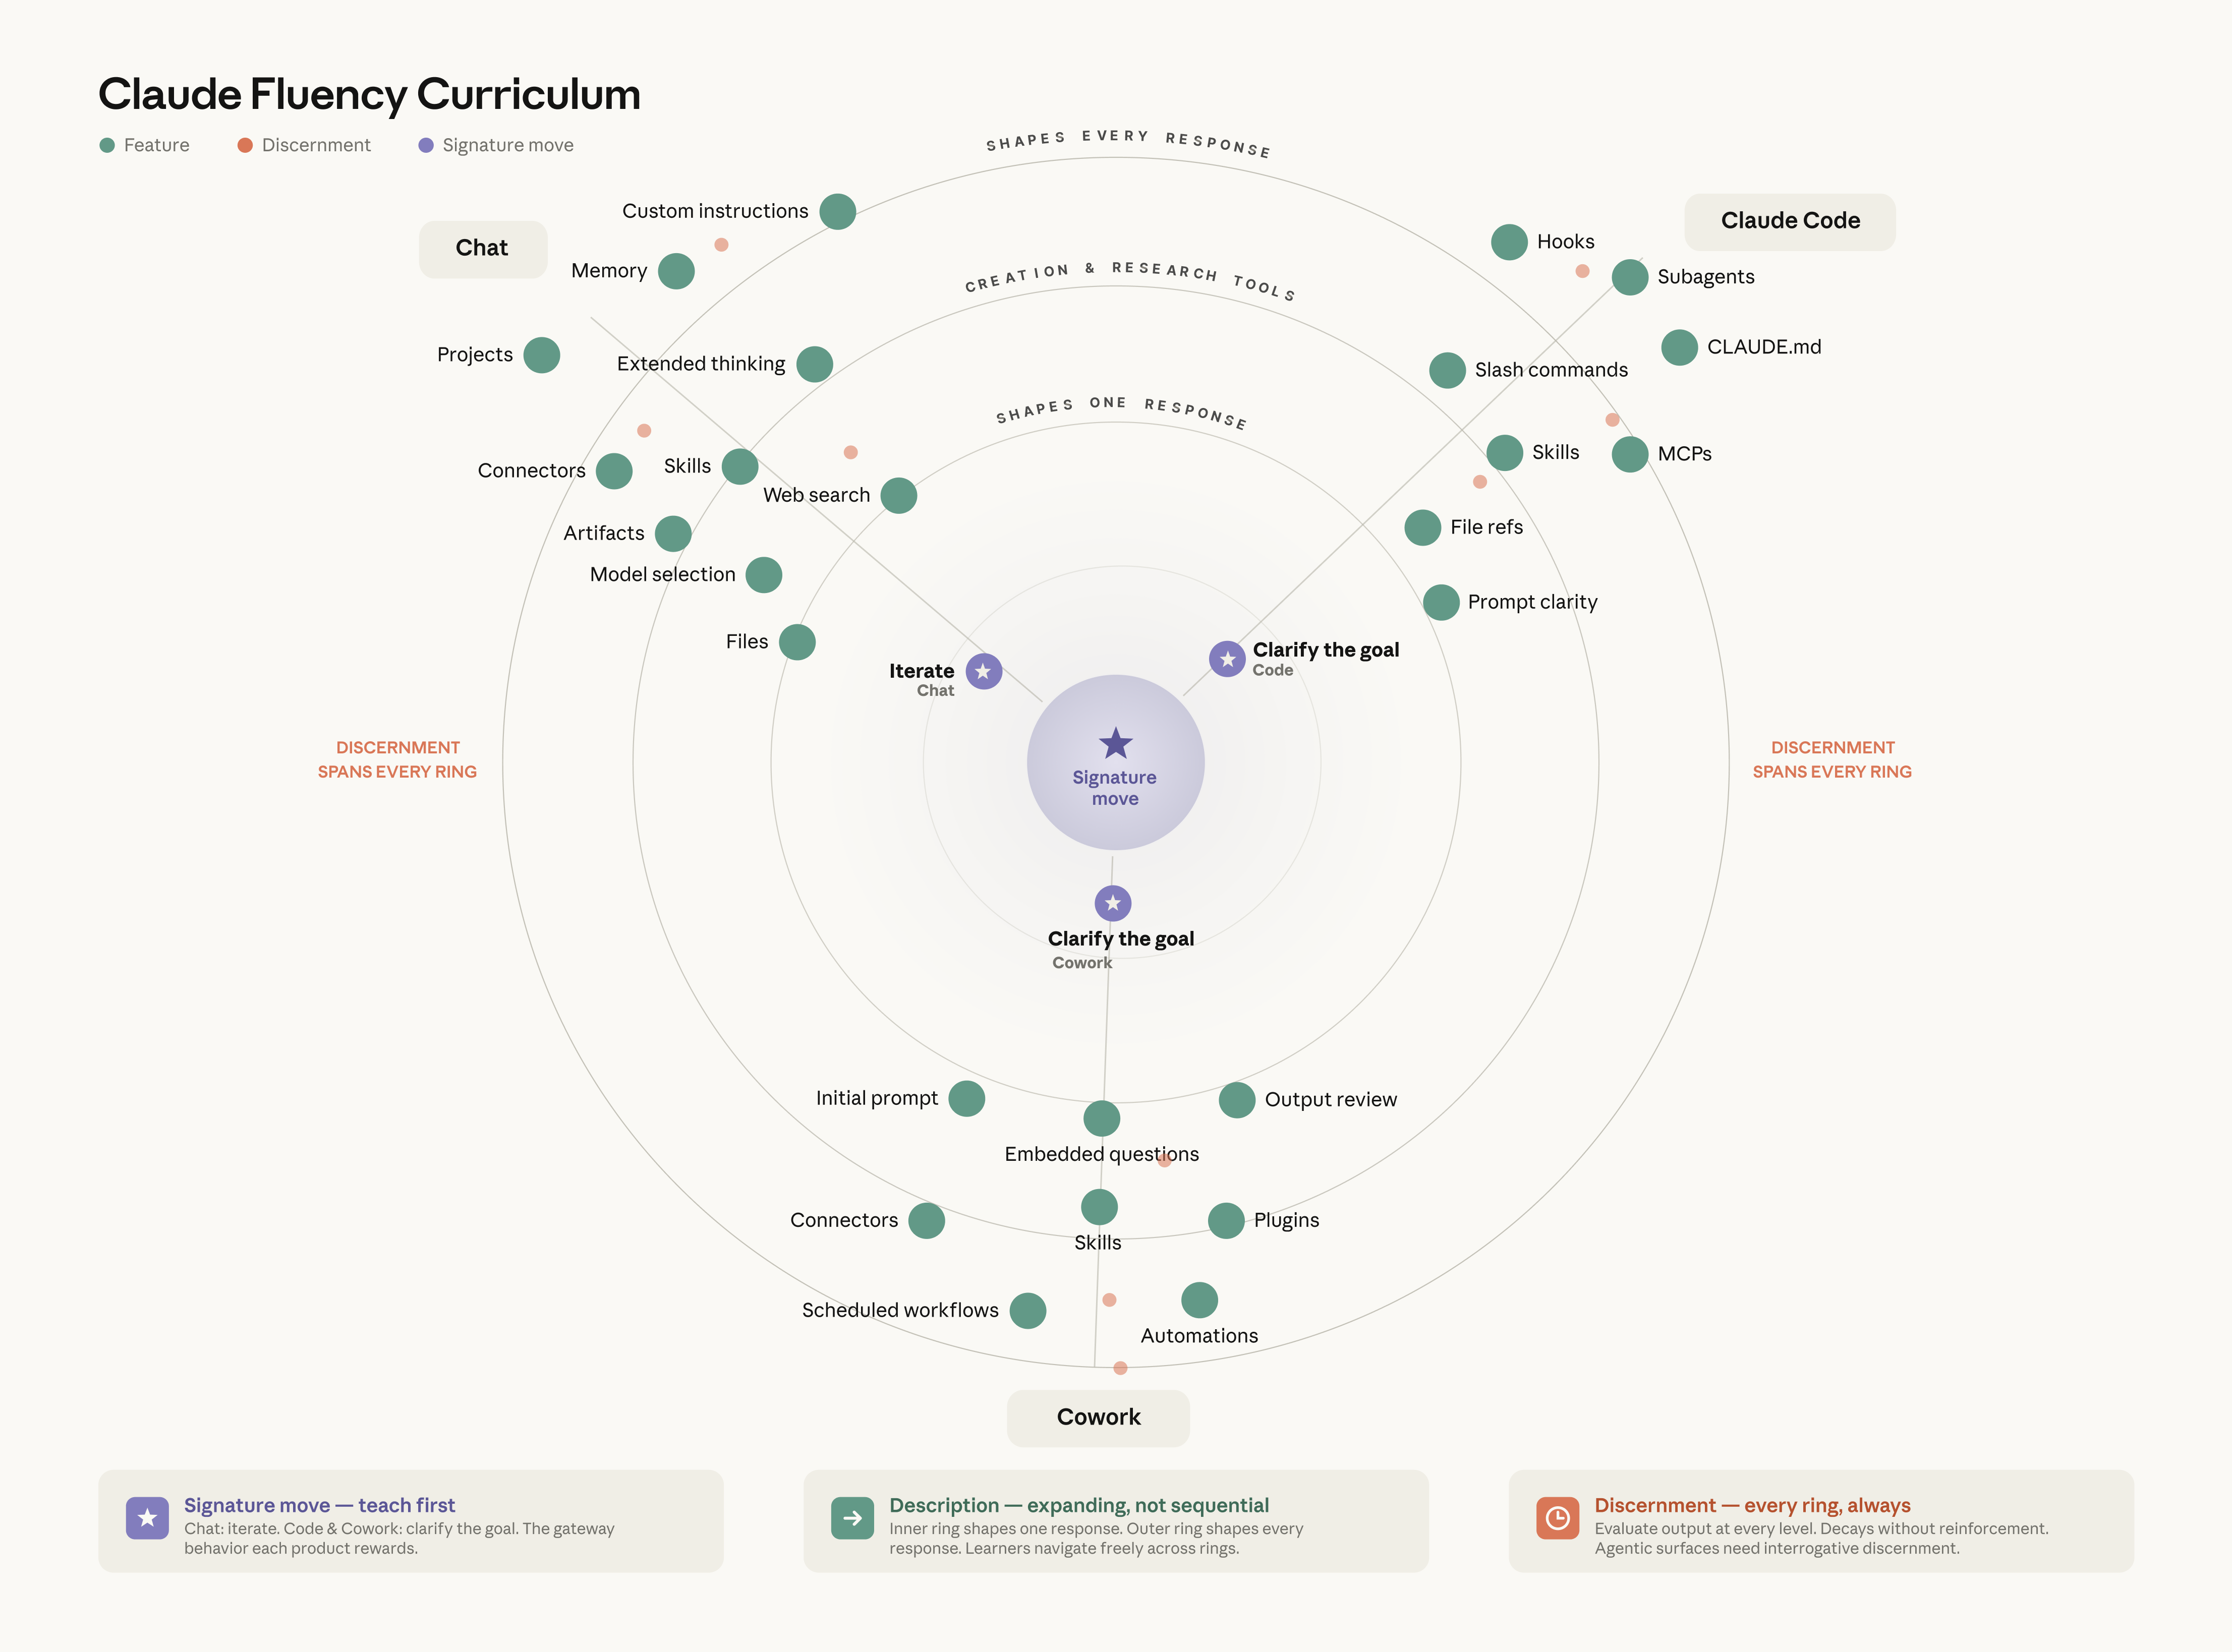
Jede Claude-Oberfläche belohnt zu Beginn ein anderes Verhalten. Wir nennen dies den Signature Move: das Einstiegsverhalten, das, wenn es vorhanden ist, die anderen KI-Kompetenz-Indikatoren am zuverlässigsten hebt.
In Chat ist der Signature Move das Iterieren. Nutzer, die durch Folgeeingaben verfeinern, zeigen in jeder anderen von uns gemessenen Dimension eine stärkere KI-Kompetenz, und Nutzer, die eine Nachricht senden und dann gehen, zeigen fast keine kritische Bewertung. Iteration schafft den Raum, in dem sich andere Fähigkeiten entwickeln.
In Claude Code und Claude Cowork ist der Signature Move das Klären des Ziels. Beide agentischen Oberflächen belohnen Nutzer, die klar formulieren, was sie wollen, bevor Claude mit der Arbeit beginnt. Nutzer, die das Ziel klären, geben auch häufiger das Format vor, legen den Interaktionsstil bewusster fest und zerlegen Aufgaben effektiver. Zielklarheit geht mit dem gesamten Spektrum an Verhaltensweisen der Description (Beschreibung) einher, auf eine Weise, wie es Iteration auf diesen Oberflächen nicht tut.
Für alle, die Claude-Training für ihre Organisation aufbauen, bedeutet dies, dass das Onboarding zuerst den Signature Move vermitteln sollte. Ein Chat-Curriculum, das Iteration nicht früh etabliert, wird Schwierigkeiten haben, darauf etwas aufzubauen. Ein Claude-Code- oder Claude-Cowork-Curriculum, das Zielklarheit nicht etabliert, wird Nutzer hervorbringen, die vage Anfragen übergeben und sich dann fragen, warum das Ergebnis das Ziel verfehlt hat.
Das Beschreibungsspektrum entwickelt sich mit der Praxis
Nach dem Signature Move schreiten Lernende entlang dessen voran, was wir das Beschreibungsspektrum nennen: die Bandbreite an Optionen, die zur Verfügung stehen, um zu gestalten, was Claude dir gibt. Das Spektrum ist nach Dauerhaftigkeit organisiert, also danach, wie lange das Feature deine Interaktionen mit Claude beeinflusst. Am einfachen Ende geschieht die Gestaltung im Moment und betrifft eine Antwort. Du iterierst, du fügst Kontext hinzu, du lädst eine Datei hoch. Am fortgeschrittenen Ende geschieht die Gestaltung in der Konfiguration und betrifft jede nachfolgende Antwort, ohne dass du dafür so viel Aufwand betreiben musst. Du richtest ein Projekt ein, du schreibst eine CLAUDE.md, du planst einen Workflow.
Die ermutigende Erkenntnis hier ist, dass Beschreibungsfähigkeiten organisch und nichtlinear mit Zeit und Erfahrung zu wachsen scheinen. Nutzer, die schon länger dabei sind, geben häufiger Beispiele an, legen den Interaktionsstil bewusster fest und kommunizieren Tonerwartungen klarer. Menschen, die Claude weiterhin nutzen, finden von selbst ihren Weg zu diesen Fähigkeiten. Wenn deine Trainingszeit also begrenzt ist, sollte es sich bereits als fruchtbar erweisen, Menschen einfach verschiedenen Arten von Beschreibung auszusetzen, die sie mit Claude üben können.
Die Discernment-Spirale (Beurteilung) muss gelehrt werden
Beurteilung, die Reihe von Verhaltensweisen rund um die Bewertung dessen, was Claude dir zurückgibt, entwickelt sich ganz anders. Sie wächst nicht mit der Zugehörigkeitsdauer. Sie überträgt sich nicht durch Vertrautheit mit Features.
Ein Teil davon lässt sich durch eine Verschiebung erklären, wie Verifikation stattfindet. Wenn Claude eine Datei bearbeitet oder einen Bericht erstellt, können Nutzer sehen, was getan wurde. Sie prüfen den Diff, führen den Test aus, überfliegen die Ausgabe. Diese beobachtende Verifikation ist real, und unsere Indikatoren erfassen sie nicht vollständig, weil man nicht „ist das richtig?" eintippt, wenn man einfach hinschauen kann. Aber Beobachtung erfasst nur Fehler, die man sehen kann. Sie übersieht falsche Annahmen, fehlenden Kontext und plausibel klingende, aber falsche Behauptungen. Ein Diff, der kompiliert, kann dennoch den falschen Ansatz verkörpern, und ein Bericht, der sich sauber liest, kann dennoch die falsche Quelle zitieren.
Da Aufgaben, die früher von Berufseinsteigern erledigt wurden, zunehmend von Claude automatisiert werden, werden außerdem gezielte Programme erforderlich sein, um Menschen zu vermitteln, „wie gute Arbeit aussieht".
Wenn deine Trainingszeit begrenzt ist, ist Beurteilung der Punkt, auf den du dich konzentrieren solltest.
Ein einfaches Curriculum-Modell
Einfach ausgedrückt lautet die Lehrsequenz:
- Zuerst den Signature Move vermitteln
- Entlang des Beschreibungsspektrums voranschreiten
- Beurteilung bei jedem Schritt erneut aufgreifen
Jede produktbezogene Lernerfahrung, ob formales Modul oder kurze Team-Session, sollte den Signature Move des Produkts verstärken, lernrelevante Features einführen und mit einer Beurteilungsprüfung abschließen. Einen Schritt „jetzt hinterfrage es" einzubauen, ist das, was die kritische Bewertung im Kreislauf hält.
Die folgenden Tabellen übertragen dieses Modell auf jedes Produkt. Nutze sie als Ausgangspunkt für dein eigenes Curriculum und passe die Features und Prüfungen an das an, was dein Team tatsächlich verwendet.
Chat
Signature Move: Iterieren. Verfeinern durch Folgeeingaben.
| Dauerhaftigkeitsstufe | Features | Lehransatz | Beurteilungsprüfung |
|---|---|---|---|
| Basic | Iteration, Modellauswahl, Datei-Uploads, Websuche | Zeigen, dann Menschen mit ihren eigenen Aufgaben erkunden lassen | Ist diese Antwort tatsächlich brauchbar, oder braucht sie eine weitere Runde? |
| Middle | Artefakte, erweitertes Denken, Konnektoren | Erstellung mit Formatvorgabe koppeln; Denken positionieren als „wenn du möchtest, dass Claude intensiver nachdenkt" | Lies das Denken. Hält die Argumentation stand, oder klang Claude nur selbstbewusst? |
| Lasting | Projekte, benutzerdefinierte Anweisungen, Memory | Zeigen, wie ein gut eingerichtetes Projekt jedes Gespräch darin verändert | Versorgt dein Projekt Claude mit dem richtigen Kontext, oder nur mit mehr Kontext? |
Claude Code
Signature Move: Das Ziel klären. Formulieren, was du willst, bevor Claude mit der Ausführung beginnt.
| Dauerhaftigkeitsstufe | Features | Lehransatz | Beurteilungsprüfung |
|---|---|---|---|
| Basic | Prompt-Klarheit, Dateiverweise, Modellauswahl | Ein klares Ziel, ein agentischer Durchlauf, dann Überprüfung | Bevor du den Diff akzeptierst, frage Claude, was es angenommen hat |
| Middle | Skills, Slash-Commands, MCPs | Eine wiederholbare Fähigkeit formen | Die Fähigkeit an einem Fall testen, bei dem sie sich irren könnte |
| Lasting | CLAUDE.md, Hooks, Subagents | Jede Session im Repo formen | Deine Konfiguration prüfen. Nutzt Claude sie so, wie du es erwartest? |
Claude Cowork
Signature Move: Das Ziel klären. Ein Briefing schreiben, das benennt, was du brauchst, bevor Claude es ausführt.
| Dauerhaftigkeitsstufe | Features | Lehransatz | Beurteilungsprüfung |
|---|---|---|---|
| Basic | Der anfängliche Prompt, Modellauswahl, eingebettete Fragen, Überprüfung der Ausgabe | Einen in sich geschlossenen Prompt schreiben; prüfen, was du zurückbekommen hast | Bevor du dies verwendest, frage: Was würde es falsch machen? |
| Middle | Konnektoren, Plugins, Skills | Ein wiederholbares Abruf- oder Erstellungsmuster formen | Hat der Konnektor das abgerufen, was du tatsächlich gebraucht hast, oder nur das, was leicht zu finden war? |
| Lasting | Geplante Workflows, mehrstufige Automatisierungen | Arbeit formen, die ohne dich läuft | Wann hast du zuletzt überprüft, dass dieser Workflow noch gute Arbeit liefert? |
Wie es weitergeht
Der KI-Kompetenz-Index verfolgt diese Muster weiterhin monatlich, und wir werden weiterhin veröffentlichen, was wir lernen, während sich die Produkte weiterentwickeln und der Datensatz wächst. Wenn du Claude-Training für deine Organisation aufbaust und es in dieser Forschung verankern möchtest, stehen das KI-Kompetenz-Framework und die Kursmaterialien(öffnet in neuem Tab) kostenlos zur Verfügung, und du kannst dich für den KI-Kompetenz-Newsletter anmelden(öffnet in neuem Tab), um über neue Forschung zu KI-Kompetenz benachrichtigt zu werden.
Wir sind besonders daran interessiert, von Teams zu hören, die mit Beurteilungsschulung auf agentischen Oberflächen experimentieren, da die Daten dort die größte Lücke zwischen dem, was Nutzer natürlicherweise tun, und dem, was gute Praxis erfordert, nahelegen. Wenn du etwas in dieser Richtung durchführst, würden wir gerne davon lernen.