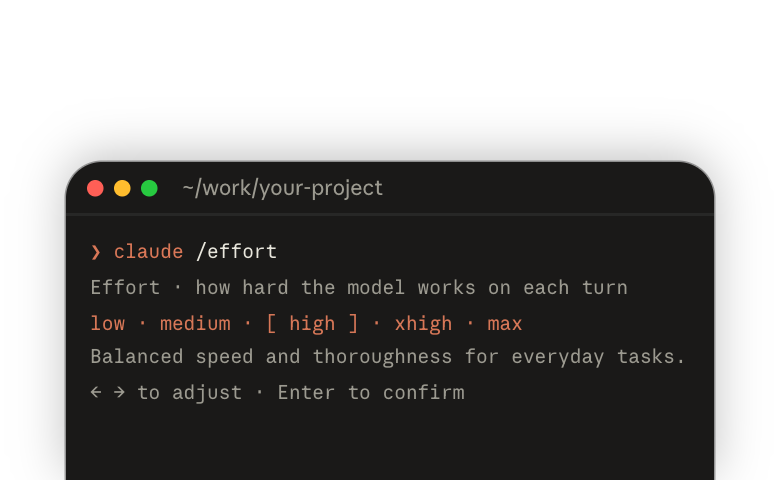
Entwickler, die mit Claude Code arbeiten, stoßen irgendwann auf eine Kosten- oder Nutzungsbeschränkung. Dennoch wollen Entwickler an der Grenze der Modellintelligenz arbeiten und greifen oft standardmäßig auf das leistungsfähigste verfügbare Modell zurück.
Unabhängig davon, welches Modell du verwendest, ist ein weiterer wichtiger Regler für Kosten und Token-Nutzung die Effort-Stufe. Passe den Effort an die Komplexität der Aufgabe an; Kosten entstehen, wenn du das nicht tust – in beide Richtungen.
Effort ändert nicht, was das Modell weiß
Effort sagt deinem Modell, wie viele Ressourcen es für die Aufgabe in deinem Prompt aufwenden soll. Wenn du den Effort auf die niedrigste Stufe setzt, versucht das Modell, die Ziele des Prompts mit so wenig Ressourcen wie möglich zu erreichen: weniger Tool-Aufrufe, weniger Token und insgesamt weniger Arbeit. Wenn du den Effort auf das Maximum setzt, signalisierst du dem Modell, dass es so viele Ressourcen nutzen kann und soll, wie es braucht, um die Ziele im Prompt zu erfüllen.
Effort legt fest, wie hart das Modell arbeitet, nicht wie viel es weiß. Das Modell, das du wählst, bestimmt das Fähigkeitsniveau, mit dem du arbeitest. Effort ist ein Signal dafür, wie hart du möchtest, dass dieses Modell arbeitet.
Wann du den Effort ändern solltest
Wenn der Effort für die Aufgabe zu niedrig ist, bricht das Modell wahrscheinlich frühzeitig ab und kommt mit unfertiger Arbeit zu dir zurück. Das ist ein Signal dafür, dass das, worum du gebeten hast, komplexer ist als der Effort, den du eingeplant hast. Dann musst du herausfinden, wo es aufgehört hat, und erneut prompten, damit es weitermacht. Am Ende kann das mehr kosten, als wenn du die Effort-Stufe von Anfang an richtig eingestellt hättest.
Wenn der Effort zu hoch ist, bemerkst du das vielleicht nicht bei jedem Prompt oder jeder Aufgabe: Das Modell verwendet mehr Token als nötig, die Antwortzeiten werden länger, und du bemerkst ein Muster von Überdenken oder davon, dass mehr Aufgaben identifiziert werden, als du tatsächlich zugewiesen hast. Du sendest das Signal „Was ich dir beschreibe, ist wirklich komplex und schwierig", und das Modell wird dieses Signal aufgreifen und die Arbeit als entsprechend komplex behandeln.
Der Standardwert liegt in der Mitte, und das ist nicht willkürlich: Er ist für jedes Modell auf die Stufe abgestimmt, bei der die meisten Aufgaben abgeschlossen werden, ohne zu viele Ressourcen zu verbrauchen. Deshalb ist er der richtige Ausgangspunkt.
Du stellst den Effort niedriger ein für Aufgaben, von denen du weißt, dass sie einfach sind und keinen großen Ressourcenaufwand erfordern sollten: Zeit, Turns, Tool-Aufrufe oder Dokumentenlesevorgänge. Wenn du diese Art von Aufgabe bereits auf der Standardstufe ausgeführt hast, versuche es eine Stufe niedriger und schau, ob du einen Unterschied in der Qualität bemerkst. Wenn nicht, gehe weiter eine Stufe nach der anderen nach unten, bis du einen bemerkst.
Du gehst vom Standardwert nach oben, wenn du weißt, dass du etwas beschreibst, das lange dauern und viele Turns sowie wiederholte Überprüfungen erfordern sollte. Der andere Zeitpunkt, um den Effort zu erhöhen, ist, wenn du die Aufgabe nicht schnell selbst überprüfen kannst und mehr Selbstüberprüfung vom Modell während der Arbeit möchtest. Dieselbe Regel gilt in diese Richtung: eine Stufe nach oben gehen, erneut ausführen und aufhören, wenn es anfängt, die Dinge zu erledigen, von denen du denkst, dass es sie erledigen sollte.
An welchem Regler drehen: Effort oder Modell?
Ändere das Modell nur, wenn mehr Effort das Problem nicht gelöst hat. Wusste das Modell nicht genug, oder hat es sich nicht genug angestrengt? Wenn es genug wusste, sich aber nicht genug angestrengt hat, ändere den Effort. Wenn es genug wusste, aber zu hart gearbeitet hat, ist das ebenfalls ein Effort-Problem. Wenn das Ändern des Effort das Problem nicht löst und du nicht das leistungsfähigste Modell verwendest, ist das ein Zeichen dafür, dass das von dir gewählte Modell nicht über das nötige Wissen verfügt oder für die Aufgabe nicht fähig genug ist.
Wenn du das Modell wechselst, beginne wieder beim Standardwert
Die Stufennamen sind bei jedem Modell gleich, aber dieselbe Stufe bedeutet bei einem anderen Modell nicht denselben Arbeitsaufwand.
Wenn du ein Modell auswählst, beginne den Effort immer beim Standardwert und passe ihn nach Bedarf nach oben oder unten an. Angenommen, du probierst eine schwierige Aufgabe mit dem am wenigsten leistungsfähigen verfügbaren Modell aus, um zu sehen, ob es die Aufgabe günstiger erledigen kann. Nachdem du den Effort so hoch wie möglich gedreht hast, erledigt das Modell die Aufgabe immer noch nicht auf dem von dir benötigten Qualitätsniveau, also wechselst du zu einem leistungsfähigeren Modell. Lass den Effort nicht auf Maximum stehen; versuche es erneut beim Standardwert. Das leistungsfähigere Modell kann die Aufgabe möglicherweise auch mit weniger Effort erledigen.
Immer wenn es ein neues Modell gibt, einschließlich einer neueren Version des Modells, das du bereits verwendest, überprüfe die Aufgaben, die du bisher erledigt hast, erneut. Schau, ob du mit dem leistungsfähigeren Modell bei niedrigerem Effort dieselben Ergebnisse erzielen kannst, was diese Aufgaben möglicherweise günstiger macht.
Die Effort-Stufe einstellen
Du kannst den Effort über eine der folgenden Möglichkeiten ändern:
Nur für diese Sitzung:
--effort-Flag: Übergib beim Starten von Claude Code einen Stufennamen
Für diese und zukünftige Sitzungen:
/effort: Führe/effortohne Argumente aus, um einen interaktiven Schieberegler zu öffnen,/effortgefolgt von einem Stufennamen, um sie direkt festzulegen, oder/effort auto, um auf den Modellstandard zurückzusetzen- In
/model: Verwende bei der Modellauswahl die Pfeiltasten links/rechts, um den Effort-Schieberegler anzupassen - Einstellungen: Setze
effortLevelin deiner Einstellungsdatei auflow,medium,highoderxhigh - Umgebungsvariable: Setze
CLAUDE_CODE_EFFORT_LEVELauf einen Stufennamen oderauto
Für einen Skill oder Subagenten:
- Skill- und Subagenten-Frontmatter: Setze
effortin einer Skill- oder Subagenten-Markdown-Datei, um die Effort-Stufe während der Ausführung zu überschreiben
Eine Stufe, die du mit /effort festlegst, bleibt auch in deiner nächsten Sitzung bestehen. Verwende daher das --effort-Flag, wenn du eine Stufe nur für einen Durchlauf möchtest. Max verbraucht so viele Ressourcen, dass Claude Code diese Stufe nur für die Sitzung gelten lässt, es sei denn, du legst sie über die Umgebungsvariable fest – so kannst du sie nicht versehentlich dauerhaft aktiviert lassen.
Ultracode ist keine Effort-Stufe. Es ist eine nur für die Sitzung geltende Claude-Code-Einstellung, die das Modell auf xhigh laufen lässt und bei umfangreichen Aufgaben zusätzlich Claude dynamische Workflows(öffnet in neuem Tab) orchestrieren lässt, wobei die Arbeit auf mehrere Agenten verteilt wird.
Wenn mehr als eine Methode den Effort festlegt, gewinnt diejenige, die in der folgenden Reihenfolge am weitesten oben steht.
Was auch immer oben gewinnt, deine Organisation kann es begrenzen. Bei Enterprise-Plänen kann ein Administrator eine maximale Effort-Stufe pro Modell(öffnet in neuem Tab) festlegen. Stufen oberhalb dieser Obergrenze erscheinen nicht in der /effort-Auswahl, und wenn du mit /effort oder --effort eine solche anforderst, läuft Claude Code auf der Obergrenze und teilt dir das mit.
Durchgerechnetes Beispiel
Derselbe Prompt wird dreimal auf einem Modell ausgeführt, bei niedrig, dem Standardwert und maximal: Spiele jede Stufe ab und beobachte, wie viel Arbeit in dasselbe Ergebnis fließt. Der Prompt fordert ein kleines CSV-zu-JSON-Skript an, das an einer Beispieldatei getestet wird – absichtlich unspektakulär, damit die Effort-Stufen Raum haben, sich zu unterscheiden.
Probiere es in deiner eigenen Umgebung aus
Drei separate Sitzungen. Führe in jeder dieselben vier Schritte aus. Du stellst den Vergleich selbst zusammen, da /usage nur die Sitzung meldet, in der du dich gerade befindest. Überprüfe es am Ende jedes Durchlaufs, notiere die für die Sitzung gemeldete Token-Anzahl, beende dann die Sitzung und starte den nächsten Durchlauf neu.
1. Starte eine neue Sitzung in einem eigenen leeren Ordner, auf der Stufe dieses Durchlaufs
# aus einem leeren Ordner außerhalb eines Repos
# Durchlauf 1 · niedrig
mkdir effort-low && cd effort-low && claude --effort low

# Durchlauf 2 · Standard
cd .. && mkdir effort-default && cd effort-default && claude
# dann führe /effort auto aus

# Durchlauf 3 · max
cd .. && mkdir effort-max && cd effort-max && claude --effort max
Das Flag (oder /effort auto) sorgt dafür, dass jeder Durchlauf auf seiner eigenen Stufe beginnt, da low bis xhigh in deine nächste Sitzung übernommen werden, sobald sie mit /effort festgelegt wurden.
2. Füge denselben Prompt ein
Schreibe ein Skript, das eine CSV-Datei in JSON umwandelt. Speichere es als csv_to_json.py in diesem Ordner. Teste es mit dieser CSV, gespeichert als sample.csv:
name,team,start_date
Priya,Payments,2024-03-18
Marcus,Platform,2023-11-02
Lena,Support,2025-01-273. Wenn Claude die Arbeit zurückgibt, überprüfe, was diese Sitzung verbraucht hat
/usageAchte auf die Gesamttoken-Anzahl der Sitzung; der Rest des Bildschirms variiert je nach Plan.
4. Beende die Sitzung und gehe dann zurück zu Schritt 1 für die nächste Stufe
/exitDie drei Token-Anzahlen sollten von niedrig bis maximal ansteigen, und alle drei Ordner sollten einen funktionierenden Konverter enthalten. Öffne die drei Skripte nebeneinander: Der Unterschied darin, wie viel gebaut wurde, ist der Unterschied, für den du bezahlt hast.
Die Gewohnheit, die du beibehalten solltest
Effort-Management läuft auf eine Gewohnheit hinaus: beim Standardwert beginnen, beobachten, was zurückkommt, und jeweils eine Stufe anpassen. Halte diesen Kreislauf am Laufen, und du wirst wissen, welche Stufe eine Aufgabe benötigt, und einem Kollegen oder Administrator erklären können, warum.
Mehr erfahren
- Die Wahl eines Claude-Modells und einer Effort-Stufe in Claude Code(öffnet in neuem Tab): die Konzepte hinter Modellwahl und Effort, vom Claude-Code-Team.
- Modellkonfiguration(öffnet in neuem Tab): die vollständige Referenz für
/effort, Einstellungen, Rangfolge und Organisationslimits. - Den Wert von Claude Code maximieren(öffnet in neuem Tab): ein aufgezeichnetes Webinar darüber, wohin die Token einer Sitzung fließen, wie man das richtige Modell und die richtige Effort-Stufe wählt und was CLAUDE.md und MCP-Server zu jedem Turn beitragen, vom Claude-Code-Team.
- Optimierung für Kosten und Intelligenz(öffnet in neuem Tab): gemessene Ergebnisse für Effort, Prompt-Caching und Modellwahl, verglichen nach Kosten pro Aufgabe, aus der Claude-Platform-Dokumentation.
- Kostenoptimierung bei der Claude API(öffnet in neuem Tab): Kostenhebel, die nacheinander auf einen funktionierenden Agenten angewendet werden, für Platform-Entwickler, aus dem Claude Cookbook.